

一段普通录像,也可能藏着适合拍成短片的故事:
工作人员搬着容器走进后厨,放下时意外洒落,随后慌忙查看;一个人站在门前看手机,突然转身奔跑,身后的小狗紧跟上来。
这些内容并不复杂,却有动作、有变化,也有让人继续看下去的理由。
问题是,直接写“把它变得更有电影感”,很难说明我们到底想改变什么。本节从素材整理、故事拆解、分镜设计到生成纠错,带你把模糊的审美要求,变成能够执行的提示词。即使没有摄影基础,也可以从一个清楚的小故事开始练习。
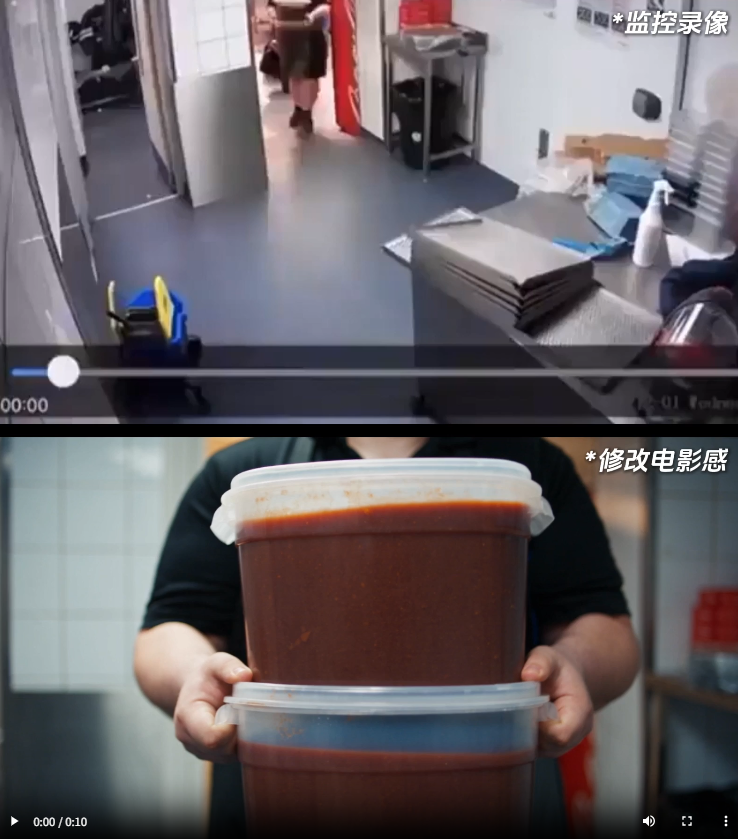
前后对比
一、先确定:故事不变,拍法可以改变
开始写提示词之前,先区分两件事:视频发生了什么,以及摄影机怎样记录它。前者是故事,后者是拍法。重新创作时,可以保留人物、场景、道具和事件顺序,同时调整机位、景别、镜头运动与节奏。
以“后厨意外”为例,故事是:工作人员抱着装有红色酱料的容器进入,准备放到操作台上,容器失去平衡,酱料洒出,他低头查看并慌忙后退。这个因果关系必须保留。至于从门口拍、从台面拍,还是切到鞋边观察洒落,都可以重新安排。
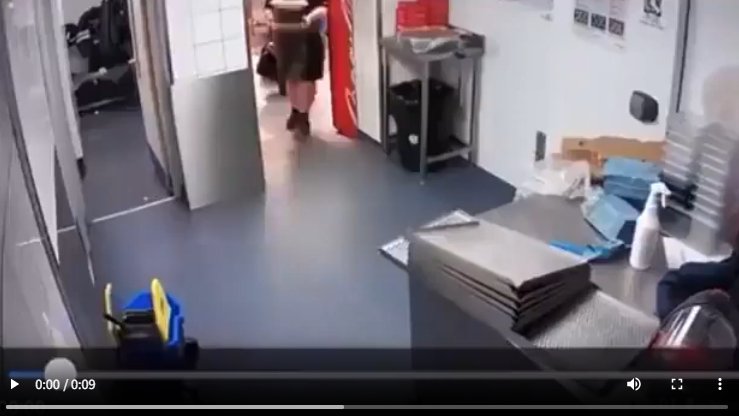
参考视频
所谓电影感,需要落实到观众的注意力上:先让人知道角色在哪,再让人注意到关键物品,接着看清意外发生,最后看到人物反应。画面好看只是其中一部分,信息出现的顺序同样重要。
先写一句创作目标:“保留事件和人物身份,重新安排镜头,让观众清楚看到动作、意外及反应。”这一句能够帮助你判断后面的提示词有没有偏离主题。
二、分三次提取:人物、场景和道具
素材提取的目的,是准备一组可以重复使用的视觉参考。人物图回答“是谁”,场景图回答“在哪里”,道具图回答“拿着什么”。实际操作时,这三类素材需要分开处理:先选取对应截图,再分别提交提取要求,每次只处理一类素材。全部检查完成后,再用于后续分镜和视频生成。
第一步:单独提取人物。
原录像中的人物可能较小、模糊或被遮挡,单张截图容易漏掉外观信息。因此,人物提取分成两个环节:先分析整个视频,再结合分析结果与截图生成参考图。
先上传完整视频,让AI整理人物特征。
指定需要分析的人物,让AI结合他在不同时间、角度和动作中的画面,整理稳定的外观特征。可以发送下面这段指令(这里使用可以分析视频的语言模型,比如ChatGPT,Gemini):
请分析我上传的完整视频,结合【目标人物】在不同时间、角度和动作中的画面,整理一份用于生成人物参考图的外观特征表。
分别分析以下内容:
1. 整体外观:大致年龄感、可见肤色、发型、帽子、胡须及其他辨识特征。 2. **脸型与五官:** 脸部轮廓、眉形、眼睛、鼻子、嘴唇、下颌及可辨认的面部细节。 3. **体型与身材:** 胖瘦、肩宽、躯干与四肢的形态,以及整体身材比例。 4. **服装与配饰:** 服装款式、颜色、图案、裤子、鞋子和配饰。
结合全片交叉核对,区分人物本身的稳定特征与光照、透视、运动模糊造成的变化。每项标明“可确认”“大致可判断”或“无法确认”。无法确认的细节不要编造,不推算精确身高或体重。
最后列出适合截图的时间点,分别用于脸部、全身和其他可见角度参考。
这一步只输出人物特征分析和截图建议,不生成人物图片。
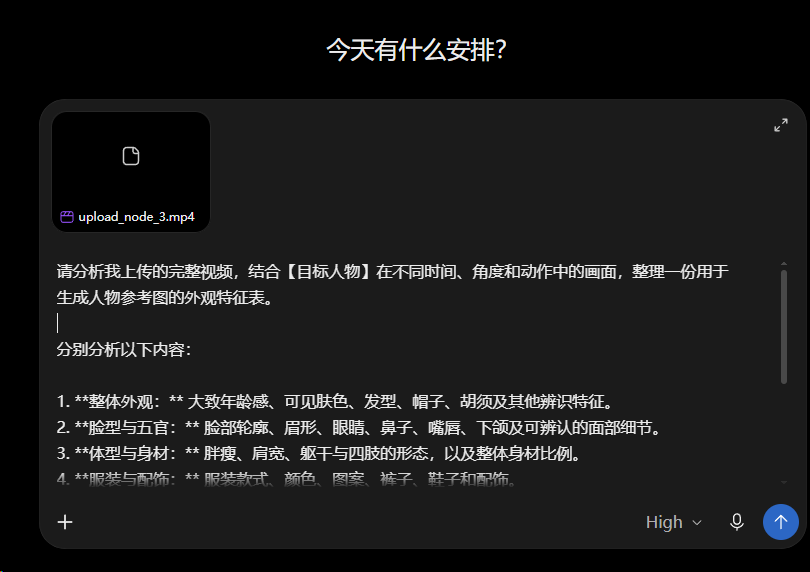
再把特征表和视频截图一起交给图片生成工具(这里可以使用GPT image 2.0去生成)。
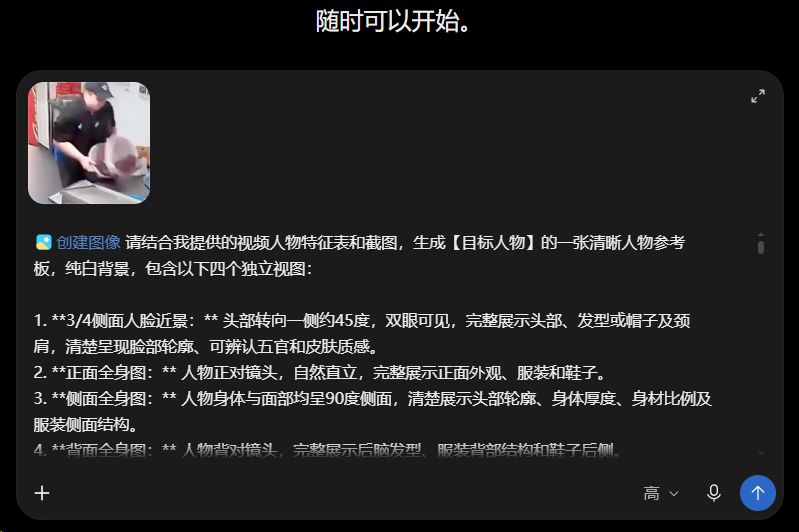
网页版ChatGPT中的iamge2.0
根据分析中列出的时间点,截取相对清楚的脸部、全身和其他角度画面。将截图与特征表一起提供,用下面的指令生成人物:
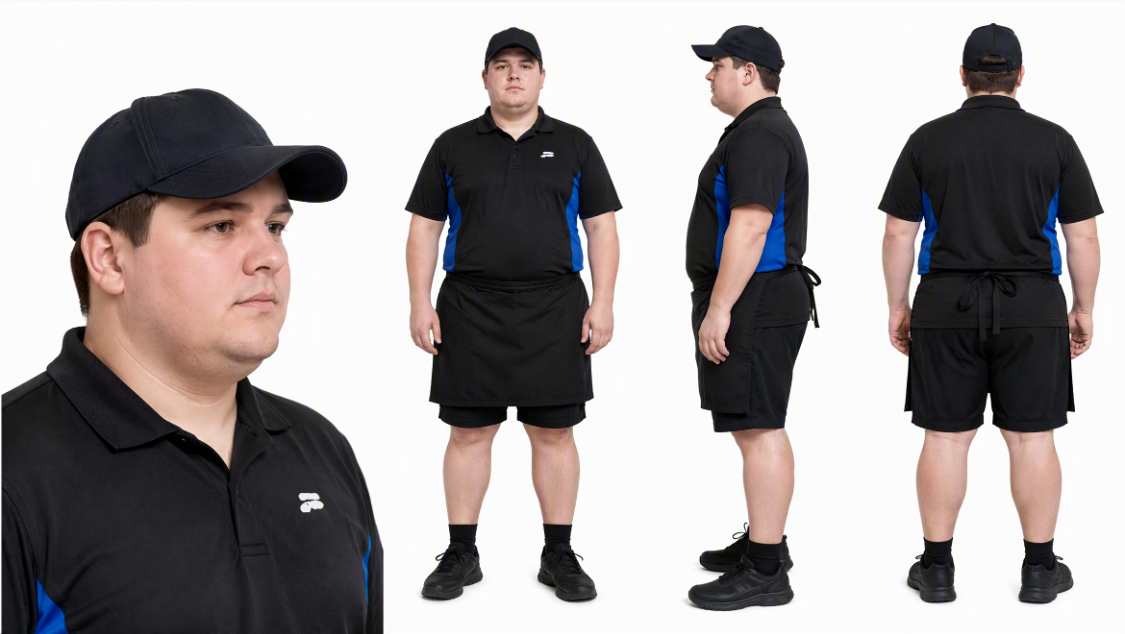
请结合我提供的视频人物特征表和截图,生成【目标人物】的一张清晰人物参考板,纯白背景,包含以下四个独立视图:
1. 3/4侧面人脸近景:头部转向一侧约45度,双眼可见,完整展示头部、发型或帽子及颈肩,清楚呈现脸部轮廓、可辨认五官和皮肤质感。 2. 正面全身图:人物正对镜头,自然直立,完整展示正面外观、服装和鞋子。 3. 侧面全身图:人物身体与面部均呈90度侧面,清楚展示头部轮廓、身体厚度、身材比例及服装侧面结构。 4. 背面全身图:人物背对镜头,完整展示后脑发型、服装背部结构和鞋子后侧。
以截图中的可见外观为基础,用特征表补充从其他视频画面确认的信息。四个视图必须保持同一人物的脸部特征、发型、肤色、体型、身材比例、服装配色及配饰一致。不美化五官,不改变胖瘦,不拉长身材。
三个全身视图采用统一比例和自然直立姿态,双臂放松并与躯干稍留间距,完整展示头顶至鞋底,头顶与脚底基线分别对齐。人脸近景单独放大,与三个全身视图区分排列,各视图之间留出空白,不重叠、不裁切。
使用均匀柔和光照,保留皮肤和衣物的真实质感。移除原场景及手持道具,保留人物穿戴的服装和配饰。
对于特征表中标记为“大致可判断”或“无法确认”的细节,以及缺少参考的侧面、背面,依据可见结构自然、克制地补全,不新增装饰、图案或夸大辨识特征。分析文字与截图发生冲突时,先指出冲突并请求核对。
提高画面清晰度,但不要将补全细节当作已经确认的真实外观。
生成后,先核对脸型、发型、体型和服装是否符合原人物,再检查补全的细节。需要侧面或背面参考时,补充相应截图后单独生成,并沿用已经确认的人物设定。整段视频也看不清的五官,仍然只能作为生成设计进行确认。
第二步:单独提取场景。
重新选择一张能看清环境布局的截图,单独提交场景提取要求。
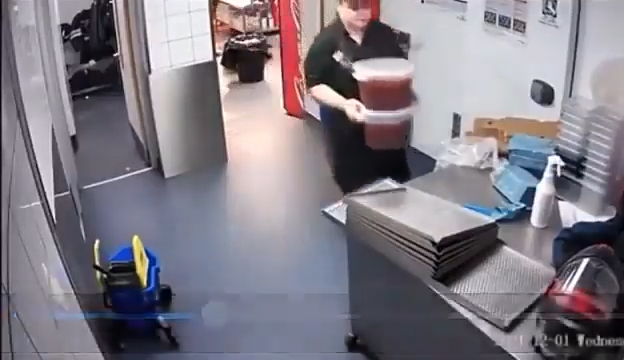
视频截图
无论是室内空间、街道、自然景观还是幻想场景,都应保留原图中主要环境元素的位置关系,移除人物,得到可供重新安排机位的空场景参考图。
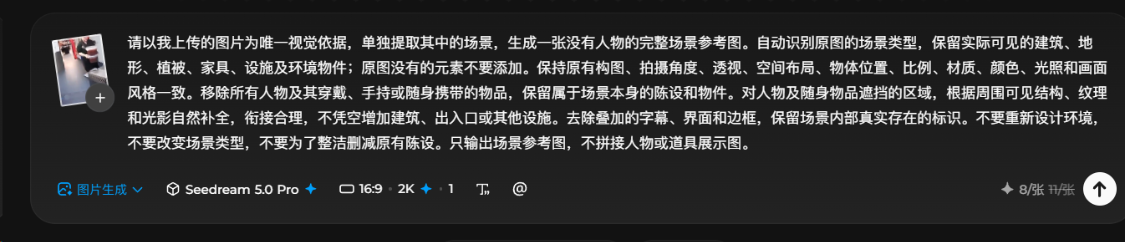
选择图片生成,使用seedream 5.0pro模型
场景提取提示词可以这样写(seedream 5.0pro生成):
请以我上传的图片为唯一视觉依据,单独提取其中的场景,生成一张没有人物的完整场景参考图。自动识别原图的场景类型,保留实际可见的建筑、地形、植被、家具、设施及环境物件;原图没有的元素不要添加。保持原有构图、拍摄角度、透视、空间布局、物体位置、比例、材质、颜色、光照和画面风格一致。移除所有人物及其穿戴、手持或随身携带的物品,保留属于场景本身的陈设和物件。对人物及随身物品遮挡的区域,根据周围可见结构、纹理和光影自然补全,衔接合理,不凭空增加建筑、出入口或其他设施。去除叠加的字幕、界面和边框,保留场景内部真实存在的标识。不要重新设计环境,不要改变场景类型,不要为了整洁删减原有陈设。只输出场景参考图,不拼接人物或道具展示图。
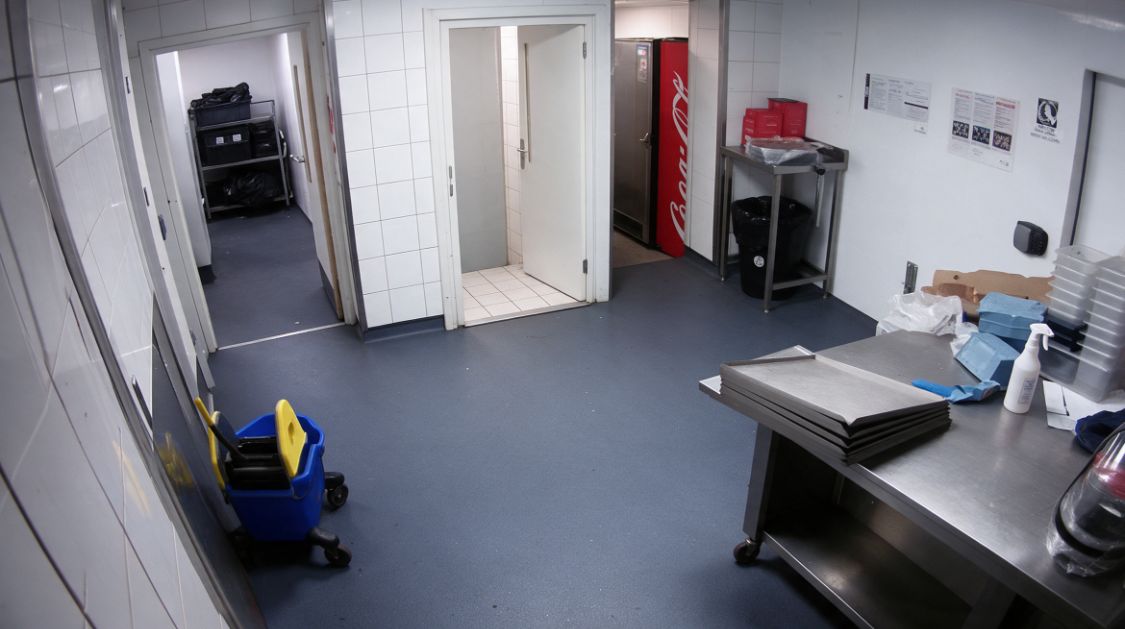
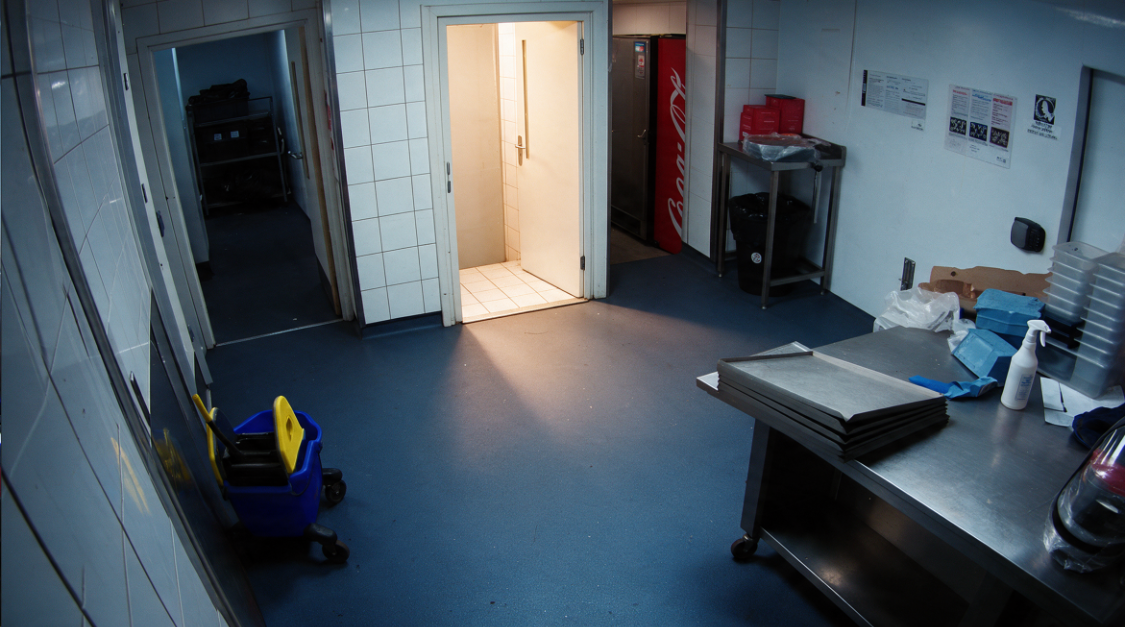
取完成后,先把场景图调整成目标电影风格。
空场景图先用来确认布局,再进行风格化。把它交给图片生成工具,说明希望采用的电影风格;可以附上风格参考图,也可以用文字描述光线、色调和氛围。将下面模板中的【目标风格】替换成自己的要求,例如“自然日光、柔和阴影、低饱和暖色、轻微胶片颗粒的写实电影风格”(可以用seedream 5.0pro去生成图片)。
请以我上传的空场景图为结构依据,将它调整为【目标风格】,生成用于视频制作的电影风格场景参考图。如提供了风格参考图,只参考其中的光照、色彩、材质表现和氛围,不复制它的建筑或布局。保持原场景类型、构图、透视、空间尺寸、主要结构、通道及物件的位置和比例一致。按目标风格调整光线方向与软硬、明暗层次、色彩关系和材质质感,使前景、中景、背景有清楚的空间层次,保留重要动作区域的可见细节。电影感不等于整体变暗,不统一添加雾气、光束或夸张虚化;效果应符合场景与目标风格。不要移动或增删关键设施,不改变人物行走和操作所需的空间,不新增人物、剧情道具或文字。只输出一张完整的电影风格空场景参考图。
第三步:单独提取道具。
再选择一张关键道具清楚可见的截图,单独提取容器。重点保留形状、材质、颜色、大小、开合状态和内容物。大容器与小餐盒需要不同的拿法,不能在提取时随意替换。
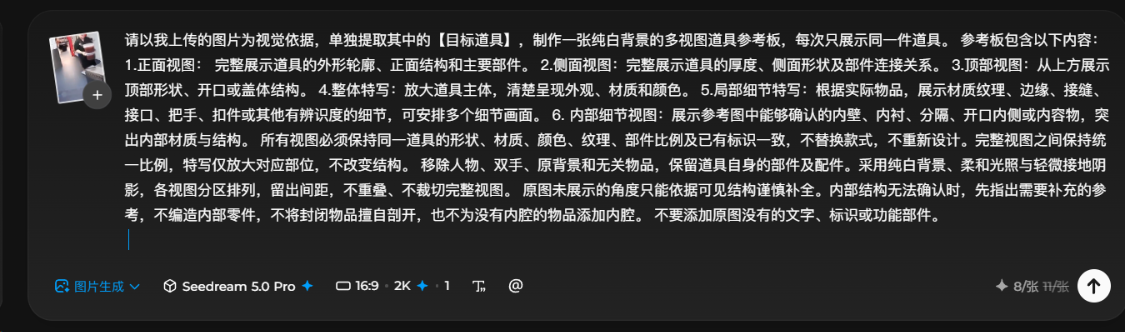
道具提取提示词可以这样写(seedream 5.0pro生成):
请以我上传的图片为视觉依据,单独提取其中的【目标道具】,制作一张纯白背景的多视图道具参考板,每次只展示同一件道具。
参考板包含以下内容:
1.正面视图: 完整展示道具的外形轮廓、正面结构和主要部件。 2.侧面视图:完整展示道具的厚度、侧面形状及部件连接关系。 3.顶部视图:从上方展示顶部形状、开口或盖体结构。 4.整体特写:放大道具主体,清楚呈现外观、材质和颜色。 5.局部细节特写:根据实际物品,展示材质纹理、边缘、接缝、接口、把手、扣件或其他有辨识度的细节,可安排多个细节画面。 6. 内部细节视图:展示参考图中能够确认的内壁、内衬、分隔、开口内侧或内容物,突出内部材质与结构。
所有视图必须保持同一道具的形状、材质、颜色、纹理、部件比例及已有标识一致,不替换款式,不重新设计。完整视图之间保持统一比例,特写仅放大对应部位,不改变结构。
移除人物、双手、原背景和无关物品,保留道具自身的部件及配件。采用纯白背景、柔和光照与轻微接地阴影,各视图分区排列,留出间距,不重叠、不裁切完整视图。
原图未展示的角度只能依据可见结构谨慎补全。内部结构无法确认时,先指出需要补充的参考,不编造内部零件,不将封闭物品擅自剖开,也不为没有内腔的物品添加内腔。
不要添加原图没有的文字、标识或功能部件。
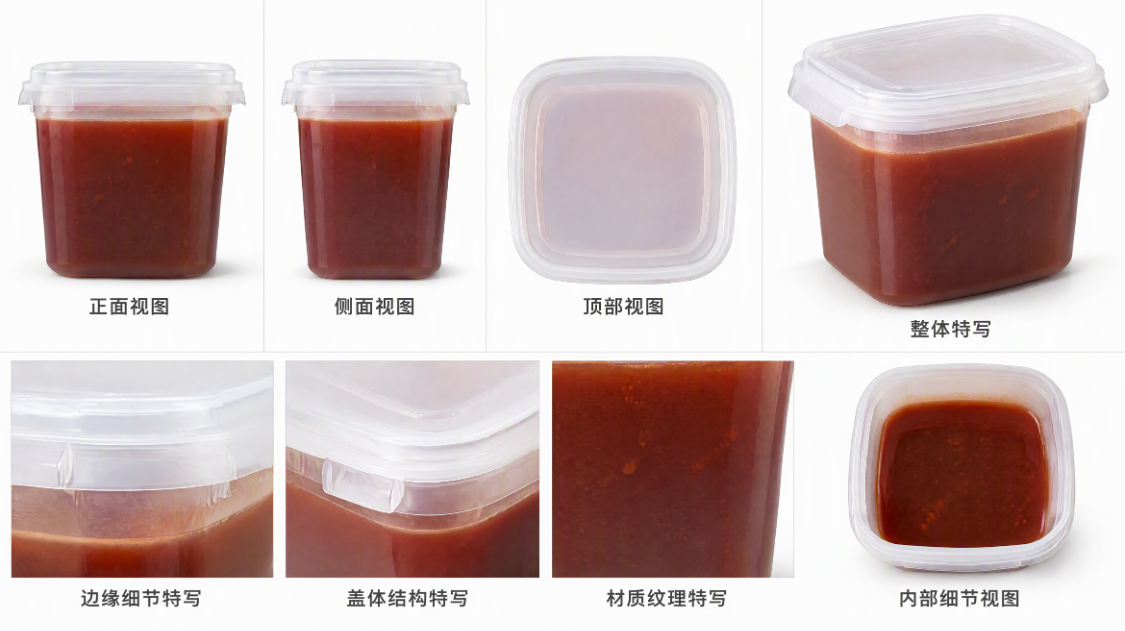
三次提取完成后,分别检查人物是否一致、场景布局是否正确、道具是否准确,再将它们编号保存。后续生成视频时,可以一起提供这些已经分别提取好的参考图,并明确每张图的用途。
三、先写事件链,再写画面形容词
有了参考素材,下一步是把动作整理成事件链。先不要加入“震撼”“高级”“大片”等词,只写发生了什么,以及前后有什么联系。
后厨案例可以整理为“抱着2盒容器进入—靠近操作台—放置时上方容器失去平衡—上方容器中的酱料洒落桌面—人物准备整理洒落的容器—同时下方的容器由于在桌面边缘,因此容器掉到地上—低头准备去拿酱料的同时酱料经过地面反弹弹起糊在人物脸上—人物慌忙后退”。
这里要区分观察和推测。看见人物转身奔跑,并不能证明他在躲避危险。
每个关键动作都需要起点和结果。“容器倾斜”不够完整,还要交代此前如何被托住、在哪里失衡、酱料最后落到哪里。“人物惊慌”也要变成能看见的动作,例如停顿、低头、缩肩或后退,而不是让角色一直保持夸张表情。
事件链可以这样询问AI(ChatGPT/gemini等语言大模型):
按时间顺序整理录像里的可见动作(故事链),写清每个动作的起点、变化和结果。区分已经发生的事件与无法确认的动机。保留人物和道具之间的接触关系,先输出事件链,暂时不要添加运镜、滤镜或新的剧情。
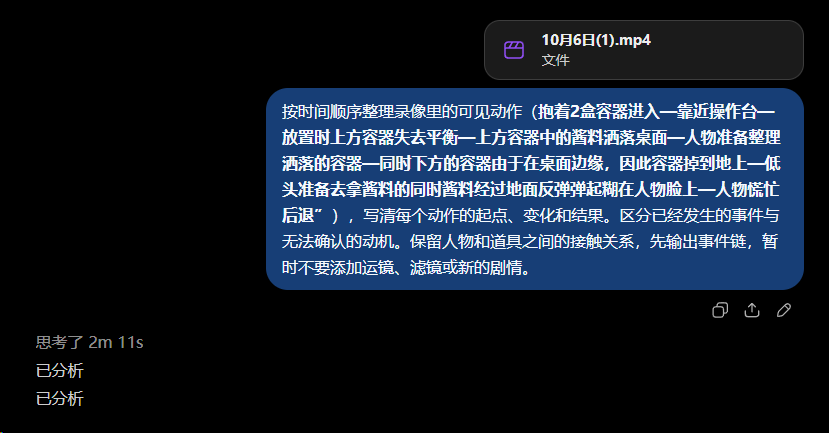
将参考视频上传
这一步能避免生成结果画面漂亮,却把“意外洒落”拍成“主动倒出”,或把“转身奔跑”改成“站着摆姿势”。
四、让AI根据事件顺序,重新设计分镜
上一节得到的是事件顺序,说明“发生了什么”。这一节把它交给AI,要求重新安排“每一段从哪里拍、拍到什么”。完成后,我们会得到一张分镜表,供下一节整理视频提示词使用。
在刚才分析录像的同一对话里,发送下面这段指令:
请根据刚才整理的事件顺序,为这段内容重新设计一套有电影感的分镜。保留人物、场景、关键道具和事件的先后关系,不新增剧情。重新安排拍摄角度、画面范围和必要的镜头运动,不沿用原录像从头拍到尾的固定视角。让观众依次看清人物进入、关键动作、意外发生和人物反应。每个镜头集中表现一个主要动作,前后动作接得上。请用表格列出镜头编号、时间段、画面内容和拍摄方式,先输出分镜表。
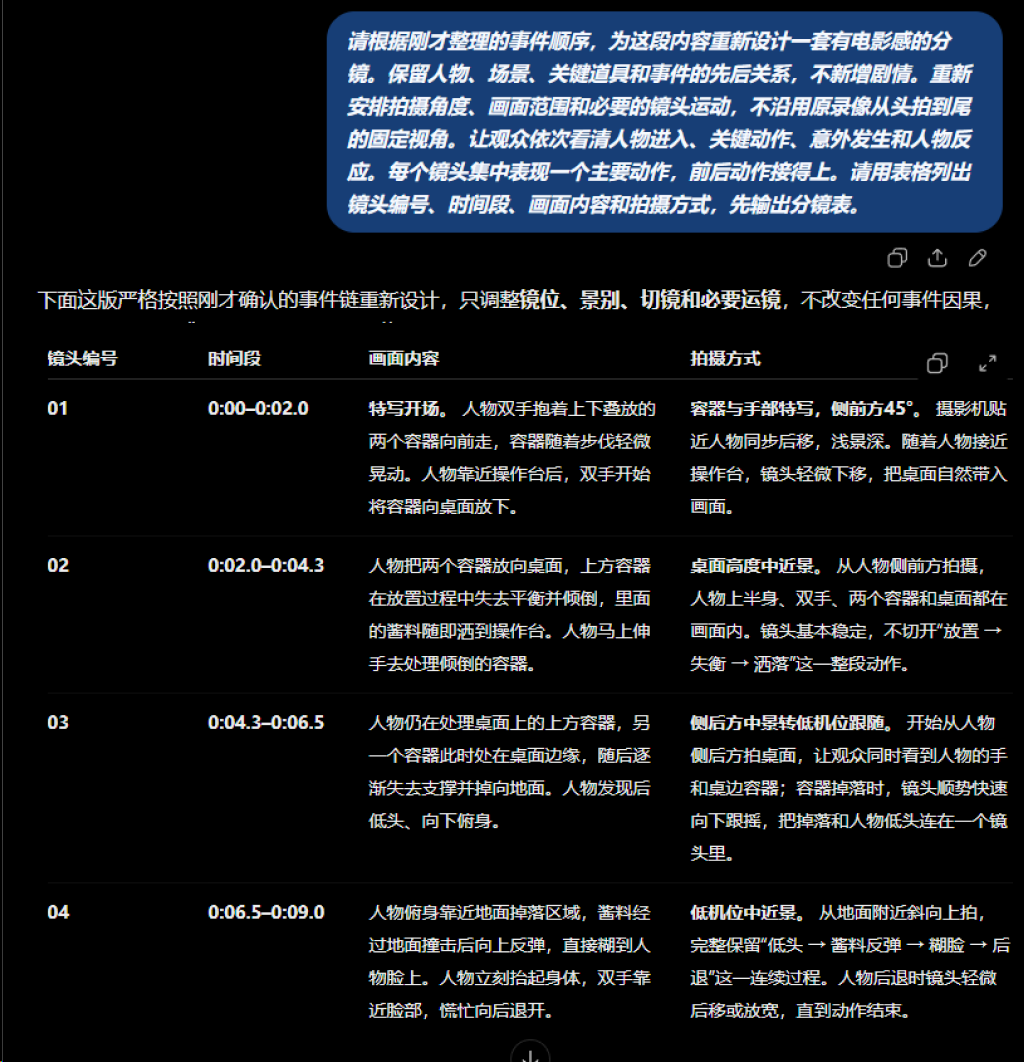
这张表就是重新设计后的分镜。它保留同一个事件,通过不同角度,依次呈现环境、道具、失手过程和人物反应。时间为教学示例,可按实际动作节奏调整。
拿到分镜后,检查有没有遗漏关键动作、改变故事,或加入素材里没有的情节。如果某个镜头不合适,直接指出镜头编号,让AI修改这一行。确认后,把分镜表用于下一步。
五、把分镜和素材交给AI,整理视频提示词
现在,将第二节分别提取的人物、场景和道具参考图,与第四节确认好的分镜表一起交给AI,让它整理成用于视频生成的提示词。
上传参考图时,简单标明“人物图”“场景图”“道具图”,再附上已经确认的分镜。这一步沿用前面的故事和镜头安排,将它们整理成可以直接使用的文字。
可以直接发送下面这段指令:
这是分别提取好的人物、场景和道具参考图,以及参考原视频,原视频用于参考事件顺序、人物动作、移动路线以及人物与道具的交互过程。,请结合已经确认的分镜,整理成用于视频生成的完整提示词。人物外观以人物图为准,环境布局以场景图为准,关键物品以道具图为准。按照分镜的时间顺序写清人物动作、拍摄角度和镜头变化,保留原事件,不新增剧情。沿用新的分镜安排,删除与它冲突的旧机位要求。输出可直接复制的最终提示词。
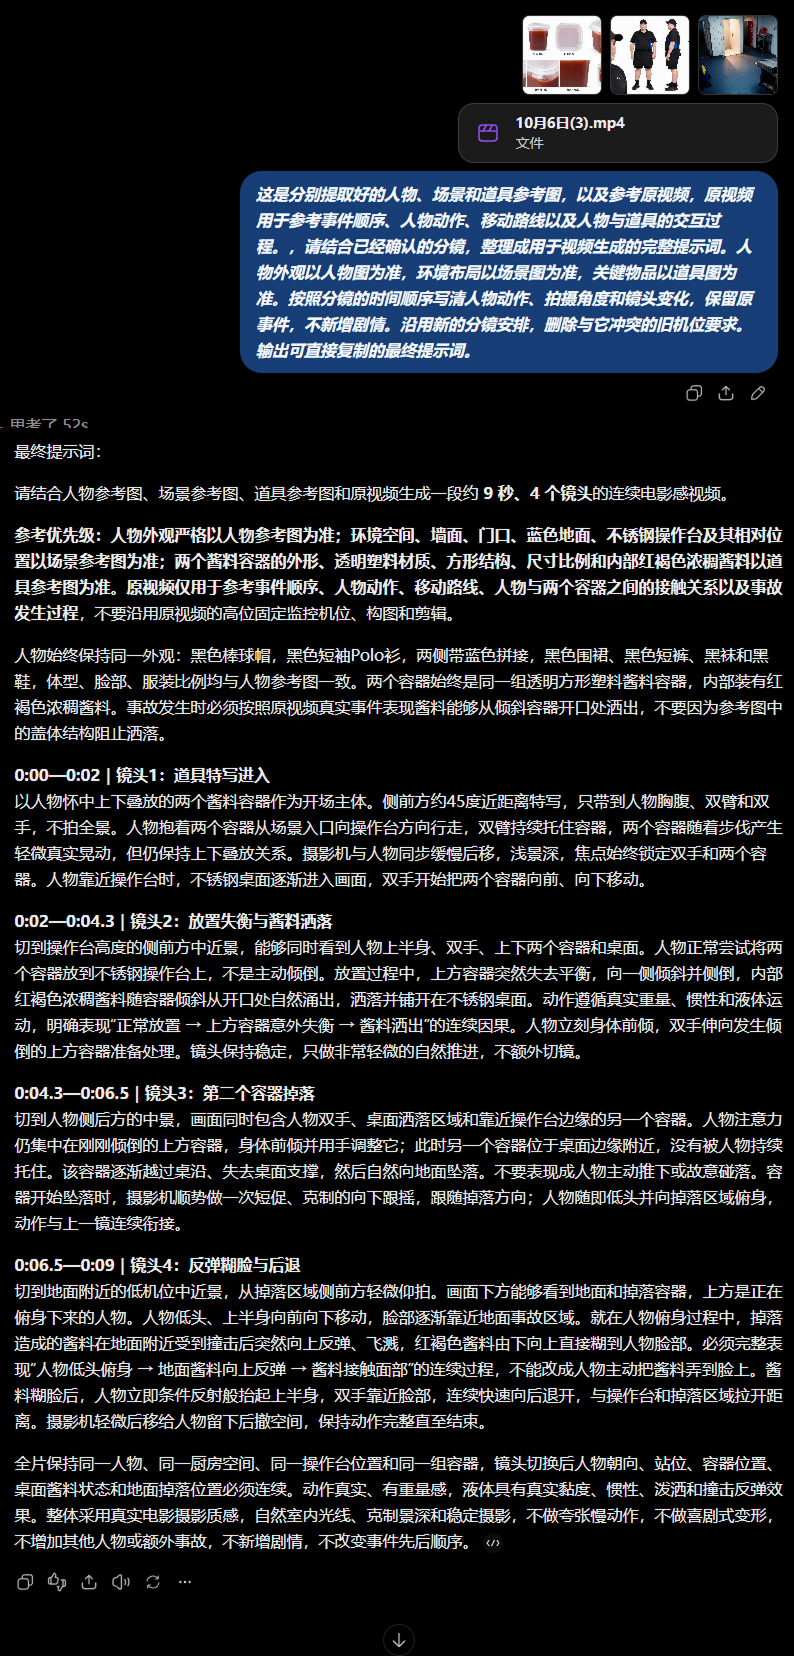
接着上一步的聊天记录继续询问
拿到结果后,先核对三件事:人物和道具有没有写错,动作顺序有没有改变,镜头安排是否对应分镜。
如果发现问题,就在这里改好,再进入视频生成。
六、同时输入原视频和参考图,生成第一版视频
使用seedance2.5去生成视频,上传原视频、人物参考图、已确认的电影风格场景图和道具参考图,再粘贴刚才整理好的视频提示词。检查提示词中的视频、图片标识是否与实际输入对应,然后设置画面比例和时长,开始生成。
原视频补充了静态图片无法完整提供的动作信息,例如人物如何托住道具、在哪里失去平衡、怎样后退。
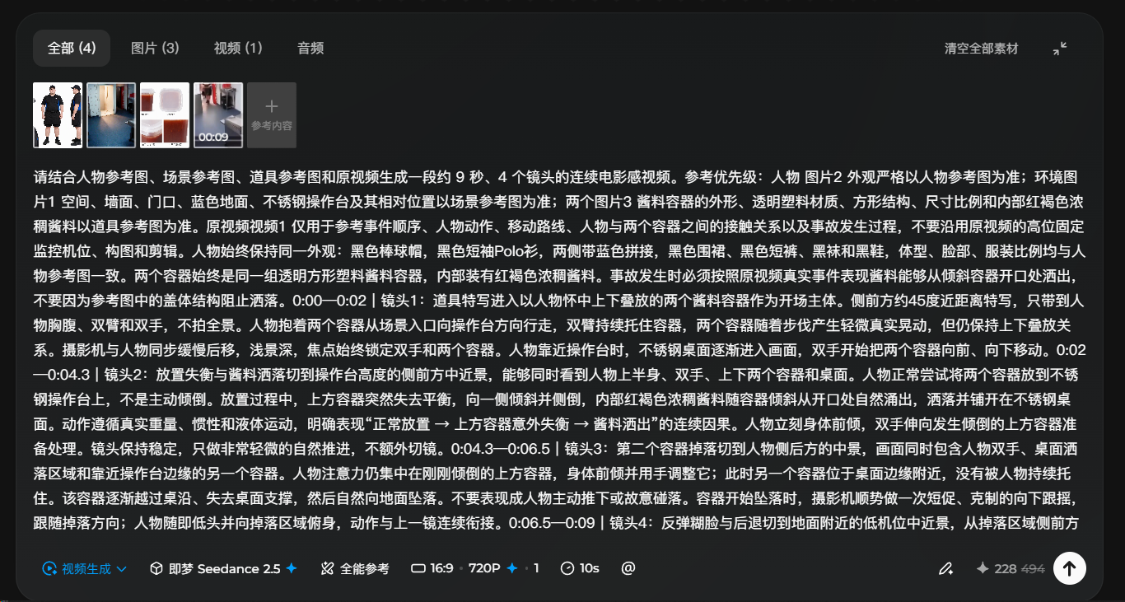
视频提示词如下:
请结合人物参考图、场景参考图、道具参考图和原视频生成一段约 9 秒、4 个镜头的连续电影感视频。
参考优先级:人物 图片2 外观严格以人物参考图为准;环境 图片1 空间、墙面、门口、蓝色地面、不锈钢操作台及其相对位置以场景参考图为准;两个 图片3 酱料容器的外形、透明塑料材质、方形结构、尺寸比例和内部红褐色浓稠酱料以道具参考图为准。原视频视频1仅用于参考事件顺序、人物动作、移动路线、人物与两个容器之间的接触关系以及事故发生过程,不要沿用原视频的高位固定监控机位、构图和剪辑。
人物始终保持同一外观:黑色棒球帽,黑色短袖Polo衫,两侧带蓝色拼接,黑色围裙、黑色短裤、黑袜和黑鞋,体型、脸部、服装比例均与人物参考图一致。两个容器始终是同一组透明方形塑料酱料容器,内部装有红褐色浓稠酱料。事故发生时必须按照原视频真实事件表现酱料能够从倾斜容器开口处洒出,不要因为参考图中的盖体结构阻止洒落。
0:00—0:02|镜头1:道具特写进入
以人物怀中上下叠放的两个酱料容器作为开场主体。侧前方约45度近距离特写,只带到人物胸腹、双臂和双手,不拍全景。人物抱着两个容器从场景入口向操作台方向行走,双臂持续托住容器,两个容器随着步伐产生轻微真实晃动,但仍保持上下叠放关系。摄影机与人物同步缓慢后移,浅景深,焦点始终锁定双手和两个容器。人物靠近操作台时,不锈钢桌面逐渐进入画面,双手开始把两个容器向前、向下移动。
0:02—0:04.3|镜头2:放置失衡与酱料洒落
切到操作台高度的侧前方中近景,能够同时看到人物上半身、双手、上下两个容器和桌面。人物正常尝试将两个容器放到不锈钢操作台上,不是主动倾倒。放置过程中,上方容器突然失去平衡,向一侧倾斜并侧倒,内部红褐色浓稠酱料随容器倾斜从开口处自然涌出,洒落并铺开在不锈钢桌面。动作遵循真实重量、惯性和液体运动,明确表现“正常放置 → 上方容器意外失衡 → 酱料洒出”的连续因果。人物立刻身体前倾,双手伸向发生倾倒的上方容器准备处理。镜头保持稳定,只做非常轻微的自然推进,不额外切镜。
0:04.3—0:06.5|镜头3:第二个容器掉落
切到人物侧后方的中景,画面同时包含人物双手、桌面洒落区域和靠近操作台边缘的另一个容器。人物注意力仍集中在刚刚倾倒的上方容器,身体前倾并用手调整它;此时另一个容器位于桌面边缘附近,没有被人物持续托住。该容器逐渐越过桌沿、失去桌面支撑,然后自然向地面坠落。不要表现成人物主动推下或故意碰落。容器开始坠落时,摄影机顺势做一次短促、克制的向下跟摇,跟随掉落方向;人物随即低头并向掉落区域俯身,动作与上一镜连续衔接。
0:06.5—0:09|镜头4:反弹糊脸与后退
切到地面附近的低机位中近景,从掉落区域侧前方轻微仰拍。画面下方能够看到地面和掉落容器,上方是正在俯身下来的人物。人物低头、上半身向前向下移动,脸部逐渐靠近地面事故区域。就在人物俯身过程中,掉落造成的酱料在地面附近受到撞击后突然向上反弹、飞溅,红褐色酱料由下向上直接糊到人物脸部。必须完整表现“人物低头俯身 → 地面酱料向上反弹 → 酱料接触面部”的连续过程,不能改成人物主动把酱料弄到脸上。酱料糊脸后,人物立即条件反射般抬起上半身,双手靠近脸部,连续快速向后退开,与操作台和掉落区域拉开距离。摄影机轻微后移给人物留下后撤空间,保持动作完整直至结束。 全片保持同一人物、同一厨房空间、同一操作台位置和同一组容器,镜头切换后人物朝向、站位、容器位置、桌面酱料状态和地面掉落位置必须连续。动作真实、有重量感,液体具有真实黏度、惯性、泼洒和撞击反弹效果。整体采用真实电影摄影质感,自然室内光线、克制景深和稳定摄影,不做夸张慢动作,不做喜剧式变形,不增加其他人物或额外事故,不新增剧情,不改变事件先后顺序。
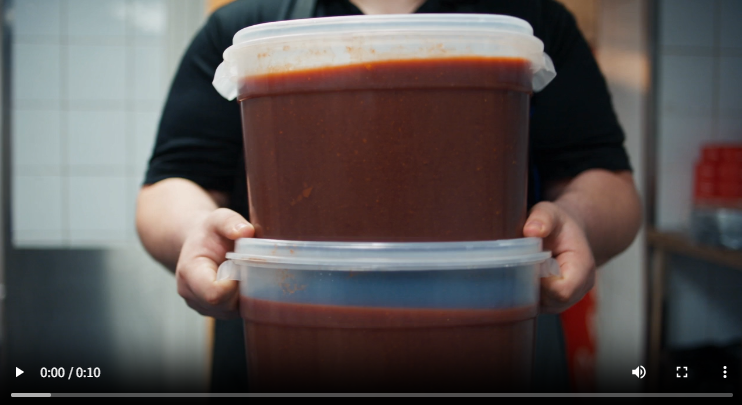
第一版生成完成后,先从头看一遍,判断故事是否完整,再检查关键动作。以后厨故事为例,重点看人物是否抱着正确的容器进入、是否在放置时意外失手,以及洒落后有没有作出反应。先确认内容,再考虑颜色和光线是否需要调整。
完成这套流程后,你得到的是一段保留原事件、重新安排拍摄方式的短片。从分别提取素材,到设计分镜、整理提示词、生成与修改,每一步都有明确的结果,也为下一步准备好了材料。