


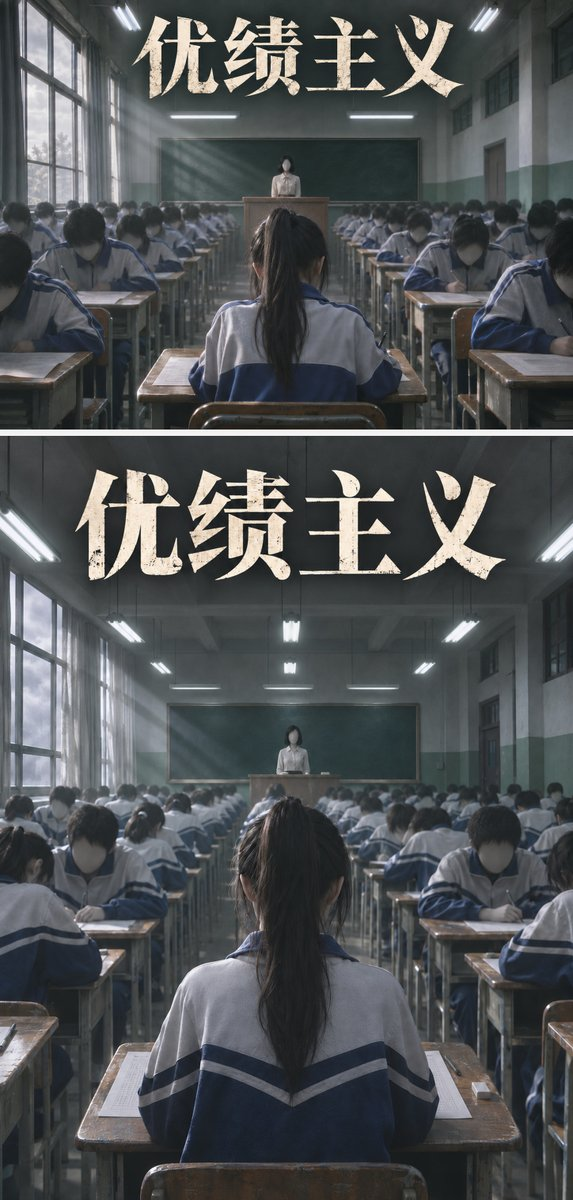
我把“重返高中、噩梦高考”的设定,做成了一部带恐怖游戏感的 AI漫剧《优绩主义》。
它的游戏感来自第一人称镜头、视角切换,以及后期叠加的交互提示和对话框。真正费功夫的,是让这些东西在同一条故事里成立。
这次制作也抽了几千积分、走了不少弯路。下面把剧本、人物和场景资产、视频生成、镜头修补,以及游戏式 UI 和字幕的做法完整拆开。
一、从熟悉的日常里,找一个异常
从自己的生活里,找到一个故事入口
第一步,还是写剧本。
对于一两分钟的短片,我们不需要铺开复杂的世界观,把人物、环境和基本设定交代清楚,再围绕一个异常事件推进,最后完成一个反转,就能构成一个完整的故事。
如果暂时没有思路,可以从自己熟悉的职业或生活环境入手。
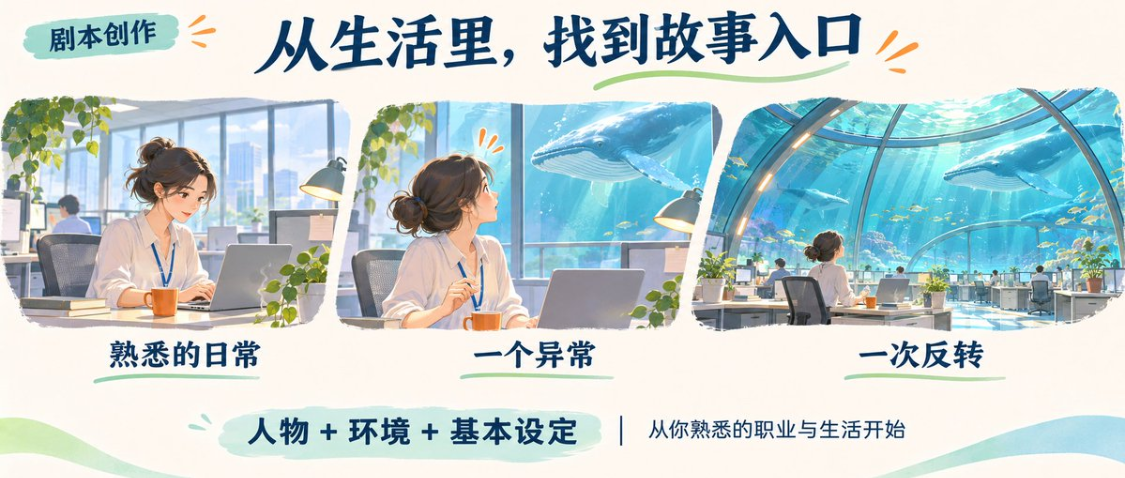
想一想:当熟悉的日常中突然出现一件不对劲的事,会发生什么?
比如,一位老师班里突然来了一个诡异的转校生;
一个救生员被锁在游泳馆里,发现泳池中出现了奇怪的生物;
一个司机凌晨开车,无论怎么走都会回到同一个路口;
一个家庭主妇发现,眼前的丈夫虽然长相没变,行为习惯却越来越陌生……
这些“日常中的异常”,都可以成为故事的起点。
有了初步想法后,我们就可以借助DeepSeek、GPT 或豆包,把创意扩展成剧本。
这时候大家会比较好奇,我们应该用哪个模型呢?
这次用到的工具,我大致这样分工:
豆包工作:内置很多skill,大家可以选择短剧创作的skill,融合了市面上比较好的梗,可以做流水线式的套路短剧,这次体验里,剧情还需要继续打磨。
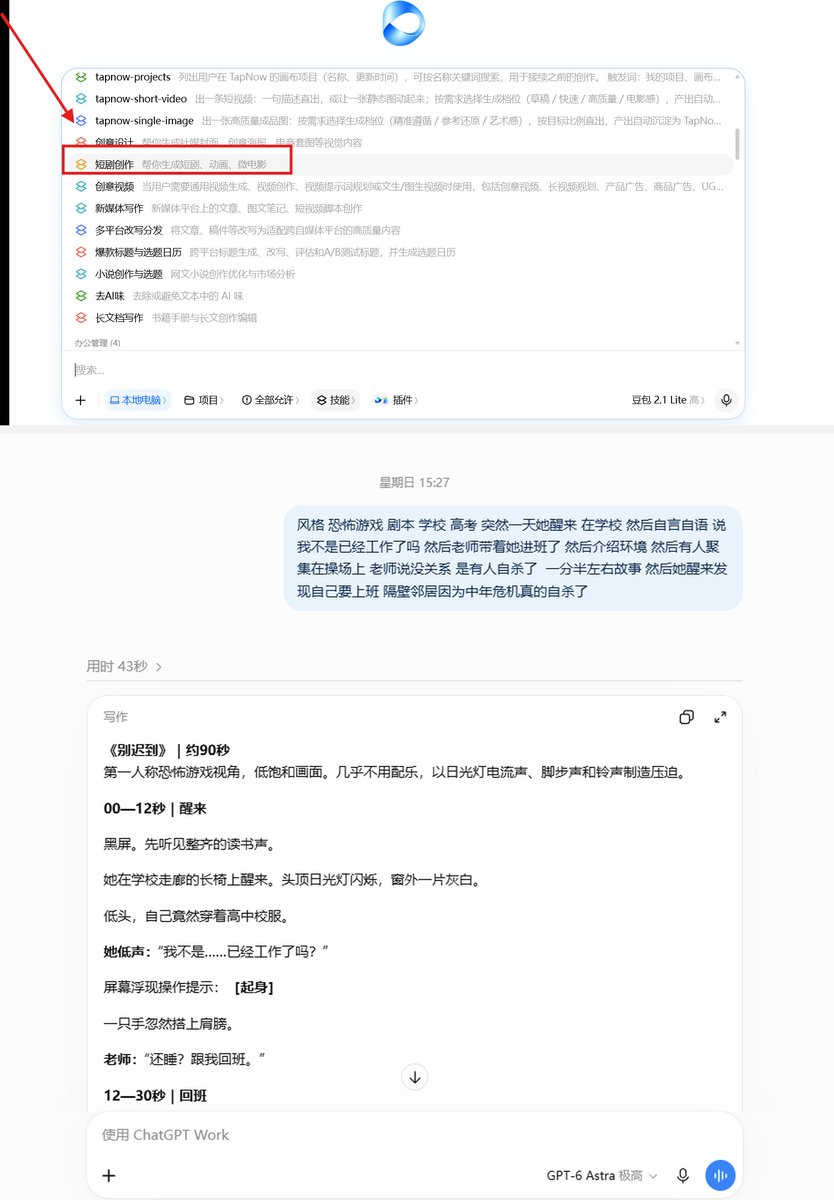
GPT:比较全能,创意和剧本台词都比较强。台词比豆包和DS更相对更流畅,比较生活化。
这次也沿用了平时的分工:在剧本创意阶段,我习惯用 Astra 的高推理档,写剧本和修改台词时用 sol 的中或高推理档。
Deepseek:
我一般会在workbuddy中调用deepseek的模型
综合来看,ds的模型在剧本创意上也很不错,和gpt5.6的创意比较像,也经常能给我比较惊喜的剧本反转。
但在人物台词撰写上表现一般。
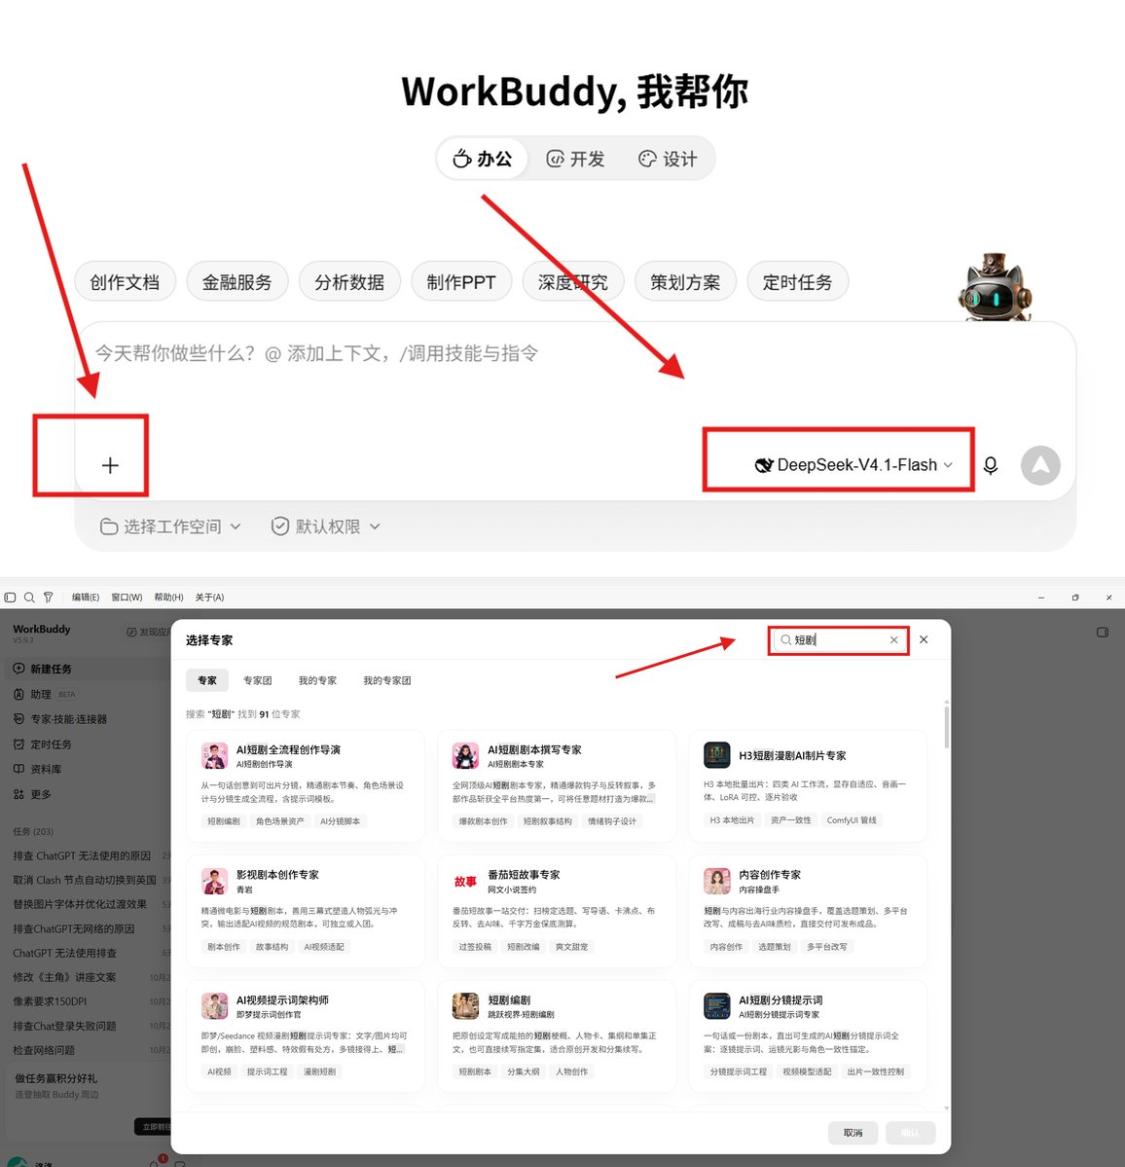
也可以选择加号,调用一些workbuddy内置的短剧剧本skill,让小白多一些选择。
无论哪个模型,把故事设定、目标时长、想要的氛围和反转方向告诉它,再逐步调整人物行为、情节节奏和结尾,让剧本更适合后续的 AI 视频制作。
当AI出完一轮剧本后,我们还需要进行人工的微调和精修。
二、先把人物、场景和 UI 资产定下来
人物
剧本写好后,先别急着生成图片,我们需要确定整部短片的视觉风格。
无论是人物还是场景,都要围绕同一个方向展开,这样后续生成的画面才能保持统一。
这次我想做出一种进入恐怖游戏的感觉,所以把视觉方向定为 3D写实、偏3A游戏质感。
确定方向后,就可以根据剧本生成人物三视图和场景图了。
下面是我这次生成的部分图片,大家可以参考它们的整体质感。
人物图终版图,这次用的是即梦seedream5.0Flash
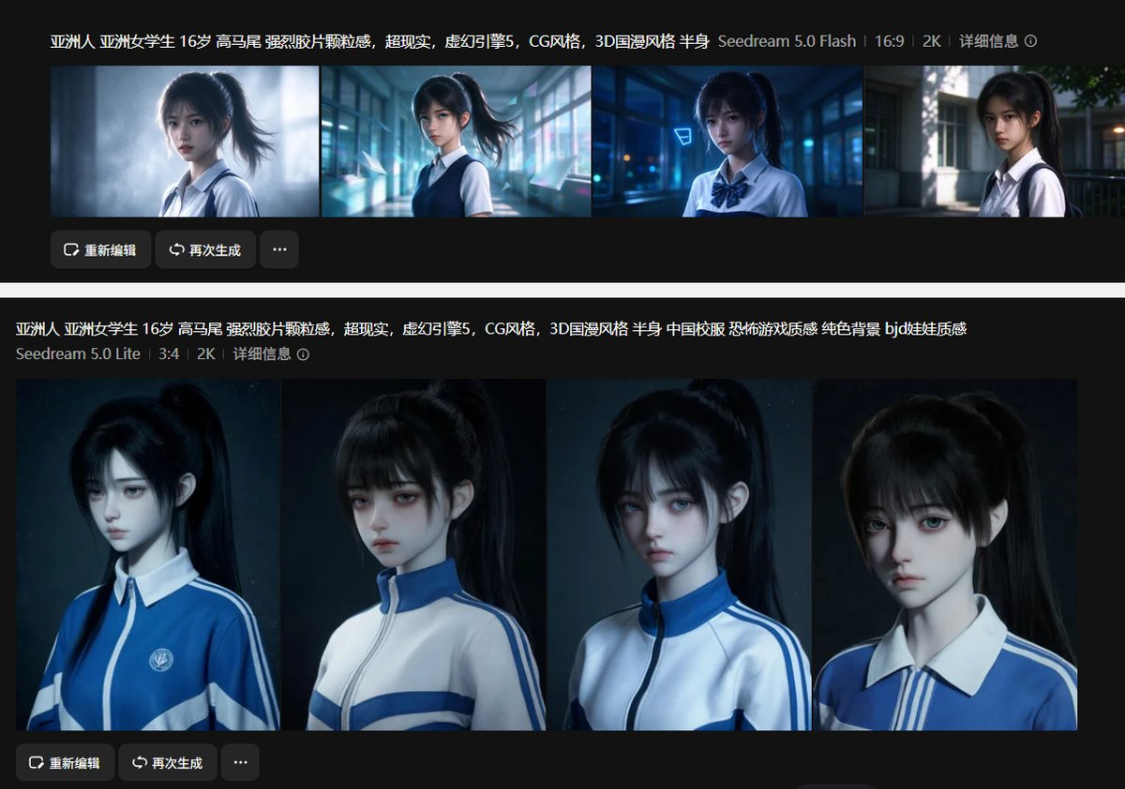
提示词如下:
亚洲人 亚洲女学生 16岁 高马尾 强烈胶片颗粒感,超现实,虚幻引擎5,CG风格,3D国漫风格 半身
而seedream5.0 lite给人的感觉是这样。
如果大家想要更偏3D一点的风格,可以提示词上适当加上BJD娃娃质感。
资产设计是 AI 视频制作的重中之重。
大家在正式生成视频之前,可以多尝试几个模型,对比效果,认真打磨人物、场景和道具资产。
尤其是人物资产,最好在这个阶段就把长相、发型、服装和整体风格确定下来。因为后续的分镜和视频都会围绕这些设定展开,做到一半再修改,往往会牵动多个镜头,甚至需要重新生成。
前期多花一点时间把资产做好,后面的制作才能更顺畅,也能减少返工。
确定角色的整体形象之后,再补齐正面、侧面、背面,并调整服装、发型和身体比例等细节。
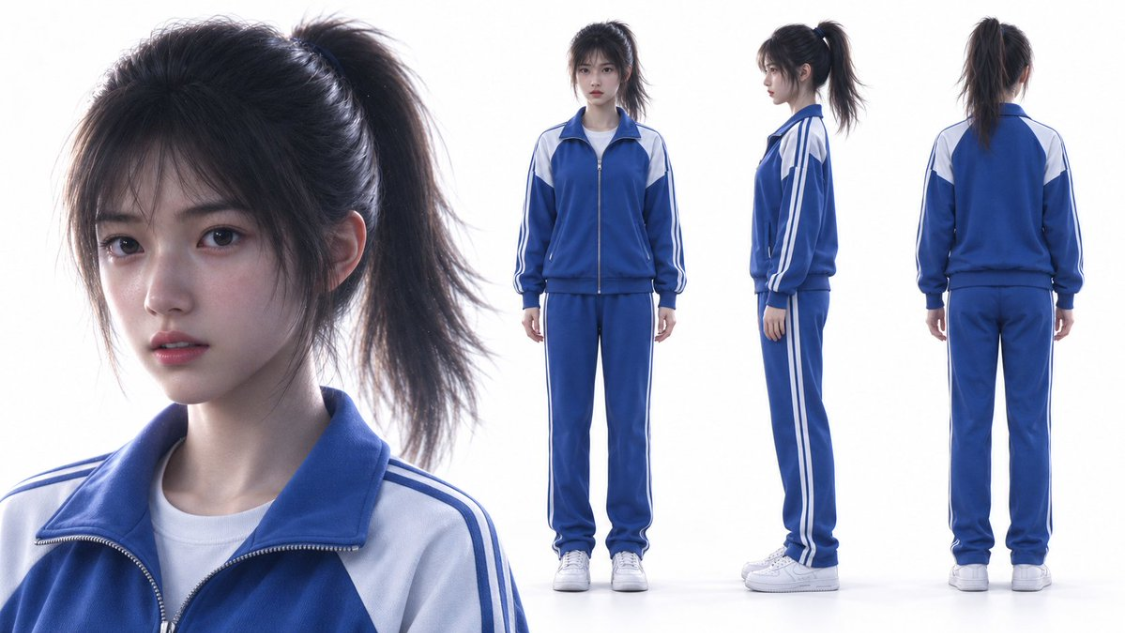
我是用GPT的image出图的功能出的人物三视图。
如果大家没有GPT账号,也可以使用libtv等任意聚合式平台。
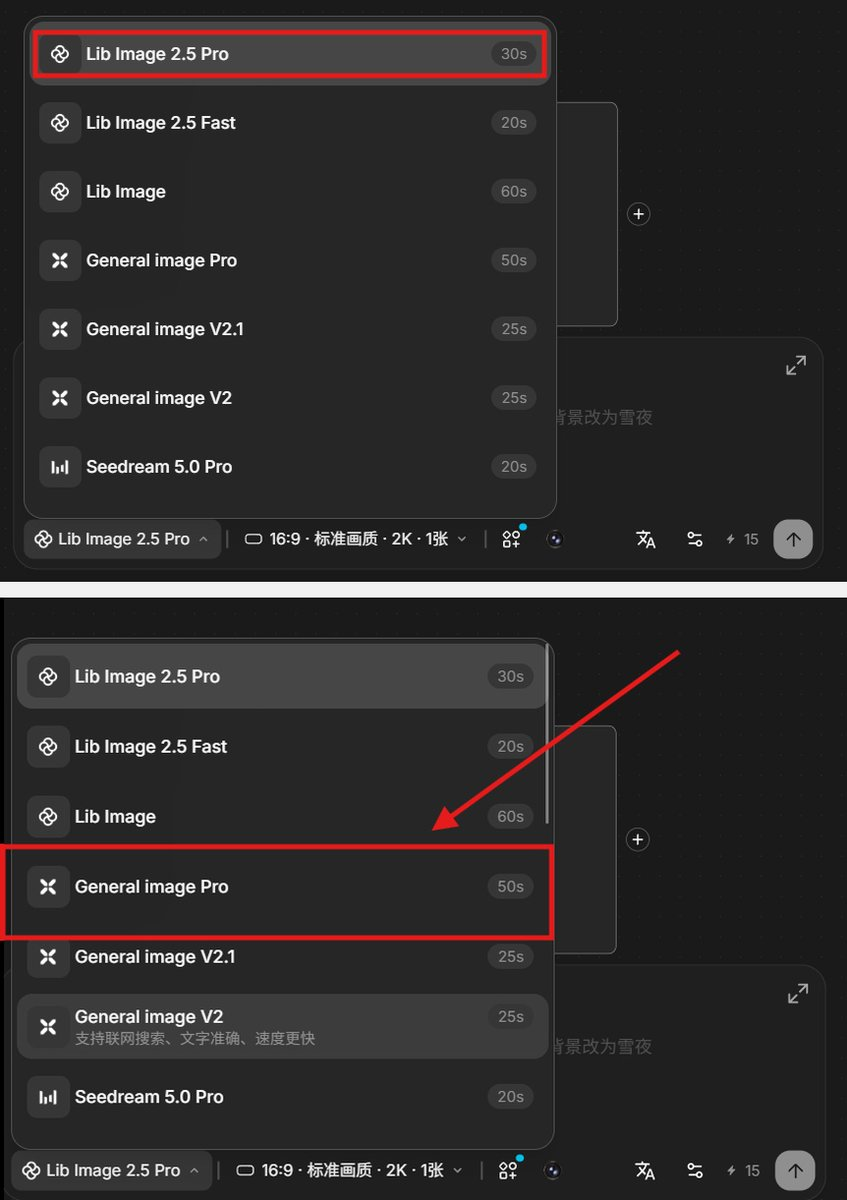
三视图提示词如下:(16:9/21:9)
生成全身三视图以及一张面部特写。(最左边占满 1/3 的位置是超大的面部特写,右边 2/3 放正视图、侧视图、后视图,二八身材比例),纯色背景
三视图做好以后,需要人换服装。
如果需要修改人物服装,我们可以用香蕉模型来完成
用 Image 模型换装后,人物的涂抹感会比较明显。
NPC 的设计,我参考了《翌日》这类恐怖游戏的氛围,把角色做成了无脸形象。
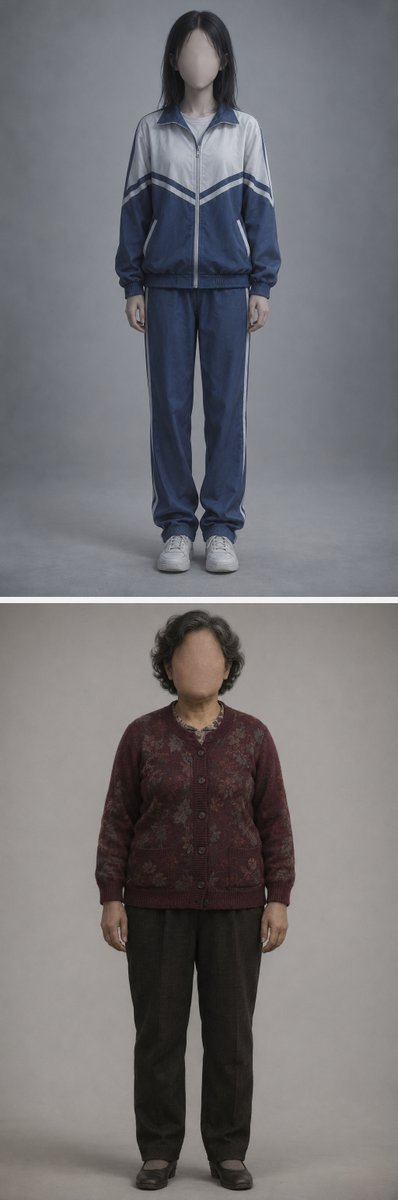
普通的校园环境里,出现一些没有五官、却仍然照常行动的人,这种反差本身就能带来不安感。
角色的衣着和姿态可以保持日常,让异常集中在脸部。
与此同时,把剧本中要用到的基础场景也准备出来。先确定空间长什么样,再围绕它生成不同镜头。
场景
对于场景资产,我同样用的是image模型,只需要我们描述画面+风格即可。
例如,校园恐怖题材可以这样写
3D 3A游戏 梦核 校园恐怖游戏质感,16:9 横屏,白天,低饱和冷灰色调,黑柔镜头效果,真实材质,柔和的自然光。
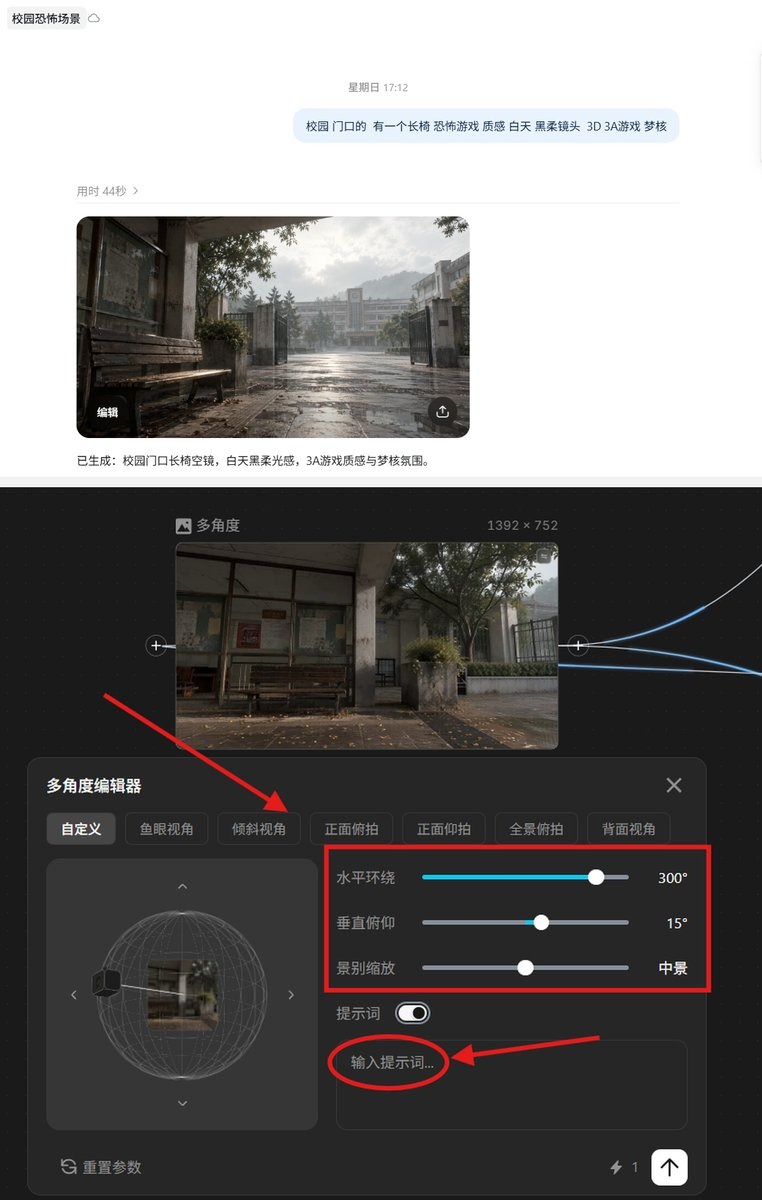
基础场景出来后,我用 LibTV 的角度变化功能,继续生成同一空间里的其他视角。
这一步很适合补充后续需要的画面,比如从走廊看向教室、从门口看向室内,或者回头看刚刚经过的位置。
生成不同角度时,我也可以在提示词里保留同一段风格描述,让材质、光线和色调尽量统一。
例如,校园恐怖题材可以这样写:
3A游戏 梦核 校园恐怖游戏质感,白天,低饱和冷灰色调,黑柔镜头效果,真实材质,柔和的自然光。
UI设计
场景图生成后,我们还可以挑选部分画面,通过改图的方式加入UI 元素,比如“进入班级”“接听电话”等交互提示,让画面更有游戏代入感。
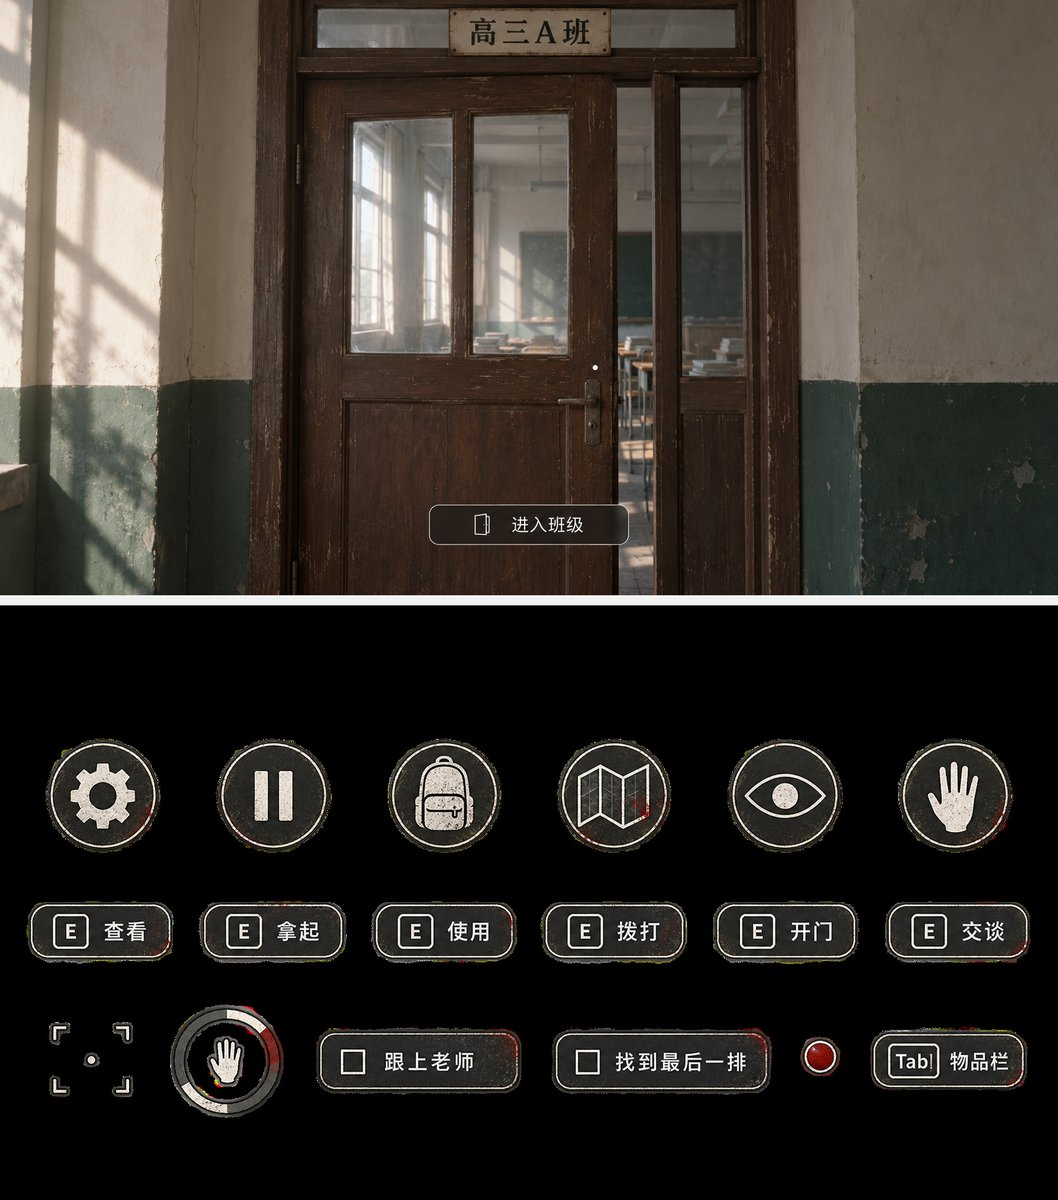
也可以单独生成一批风格统一的 UI 按钮、图标和互动标注,后期裁切、去底,再叠加到视频中。
这样就能根据镜头需要,灵活调整它们的位置、大小和出现时间。
三、围绕这次的风格选择视频模型
素材准备好后,就可以进入视频生成环节了。
这一步,建议大家先用同一组素材测试不同模型,看看哪一个更适合自己想要的风格。
做 AI 视频,并不是模型越贵,效果就越好,关键在于它是否适合你的画面和叙事需求。
这次我测试了 H3、SD2.5、SD2.0、Wan3.0 等模型。
00:15
围绕这部短片想要的 3D、3A 游戏质感和第一人称视角,我的实际感受是:
• SD2.5:电影感不错,但画面更偏影视质感,距离我想要的 3A 游戏质感和 CG 感还有一些差距。
• SD2.0:综合表现还可以,但对提示词的遵循度一般,积分消耗也比较高。
• H3:整体效果尚可,但对提示词的遵循度同样不够理想,尤其是第一人称镜头,仍然缺少一些游戏中的代入感。
• Wan3.0:对参考图的 3D 质感还原得比较好,积分消耗也相对低,是这次测试中比较符合我需求的模型。
这些感受主要针对这次短片的素材和风格。大家制作时,也可以先选几个有代表性的镜头做测试,再确定后续主要使用的模型。
综合考虑下来,我主要用的是Wan3.0模型,部分镜头使用SD2.5做补充。
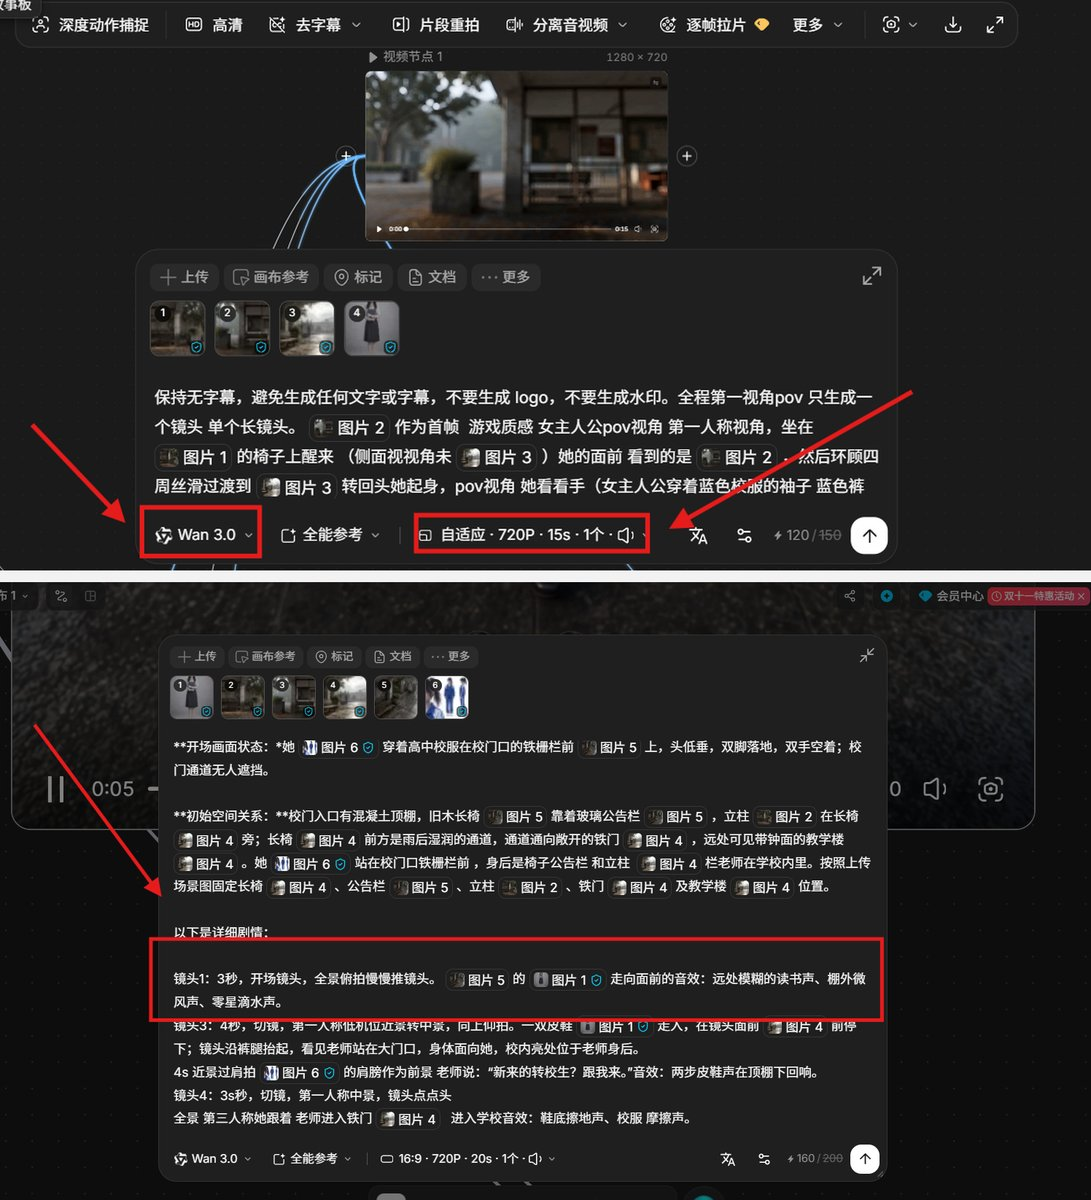
视频生成的基本流程与普通 AI 视频制作相似,选择Wan3.0模型,选好比例、时长、分辨率等。
但第一人称视角对镜头描述的要求更细,尤其要交代清楚“我在哪里、我在看什么、我接下来怎么动”。
我们可以先选好首帧参考图,再在提示词里明确:镜头从哪里开始、朝向哪里、谁在画面里,以及接下来发生什么。
视角可以写成 POV,也就是第一人称主观视角。但只写一个“POV”还不够,还要描述镜头的实际行为。例如:
保持无字幕,避免生成任何文字或字幕,不要生成 logo,不要生成水印。
全程第一视角pov 只生成一个镜头 单个长镜头。 {{Mixed 2}} 作为首帧 游戏质感 女主人公pov视角 第一人称视角,坐在 {{Mixed 1}} 的椅子上醒来 (侧面视视角未 {{Mixed 3}} )她的面前 看到的是 {{Mixed 2}} ,然后环顾四周丝滑过渡到 {{Mixed 3}} 转回头她起身,pov视角 她看看手(女主人公穿着蓝色校服的袖子 蓝色裤子 白色鞋子),突然远处的上课铃声响了,她抬头砍向左边,往学校里看去。学校里出来了一个老师 {{Mixed 4}} 着镜头走来,站在镜头前 准备和主人公开始说话。互动ui出现点击老师 。
pov视角 游戏质感 虚幻引擎5,3A游戏 CG风格。不要音乐不要音效 白天 黑柔镜头 梦核
把视线变化、移动方向和动作顺序写清楚,才能让镜头更接近角色亲眼看到的画面,也更容易建立游戏中的代入感。
这样,视角、人物关系和运动方向就都有了依据。
除了第一人称的 POV 镜头,我们还可以穿插一些第三人称的客观镜头。
第三人称视角通常参考游戏中的剧情过场。
通过全景、俯拍等镜头,让观众看清人物所处的环境,以及人物与空间的关系。
当画面从第一人称切换到第三人称时,也能暂时跳出角色的主观视野,从更客观的角度交代场景和人物状态。
视点从角色眼中抽离,转到高处俯瞰,就能形成类似“上帝视角”的观看效果,也让视角的变化更加明确。
但如果从第一视角切换到第三人称,单写一句“第三人称视角”有时并不稳定。
我会进一步限定画面里的人物构成,让镜头明确站到主角之外。
例如:
慢慢推镜头,俯拍镜头,主角和老师同时出现在画面中:主角站在前景,背对镜头;老师站在走廊另一端,面向主角。画面完整呈现两个人之间的距离。
四、用首尾帧修补镜头衔接
视频生成后,第一视角素材会很难生成,往往需要大量抽卡,但往往抽卡了还是不能获得好的效果。
遇到这种情况,我会用可灵的首尾帧功能,补一小段过渡视频。
例如,这段素材感觉不错,但中间突然抽了一下。
00:00 / 00:15
具体做法是:
• 截取需要修改视频的尾帧。
• 截取合适视频的首帧。
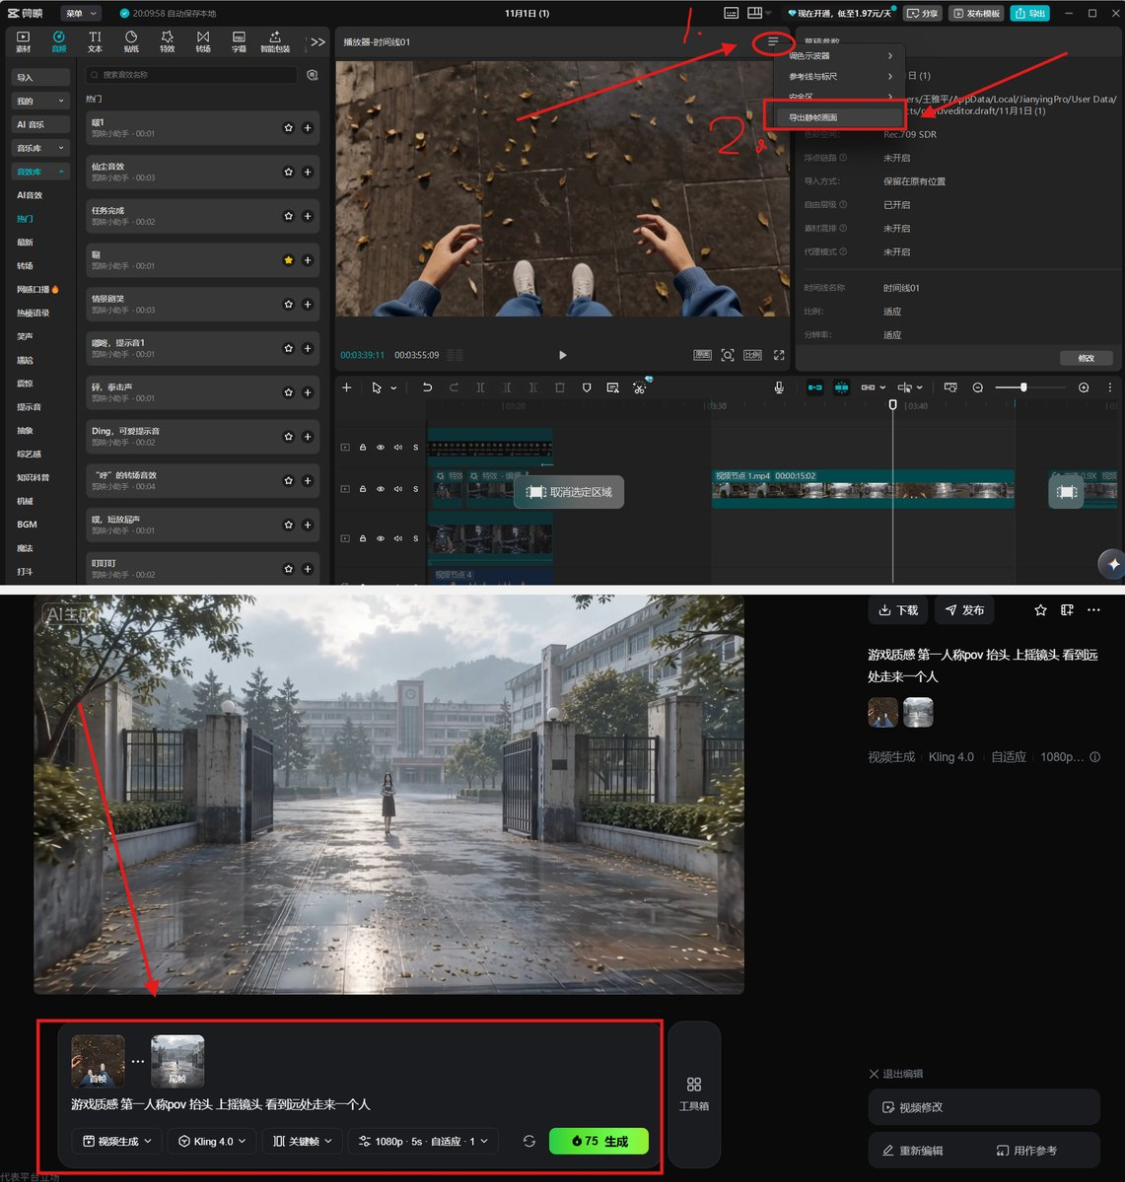
• 用可灵的首尾帧镜头,进行镜头衔接组合。
• 把生成的过渡片段剪映中,删掉重复的首帧和尾帧,再检查衔接剪辑。
如果两个画面的空间差异太大,也不要勉强连接。先调整素材或补一个中间视角,往往会更自然。
五、后期加入 UI 和游戏式字幕
基础成片完成后,最后到了剪辑环境。
常规剪辑完,再加字幕和提示界面。
提示界面大家可以把准备好的UI图片,简单蒙版裁剪后,放入视频中。
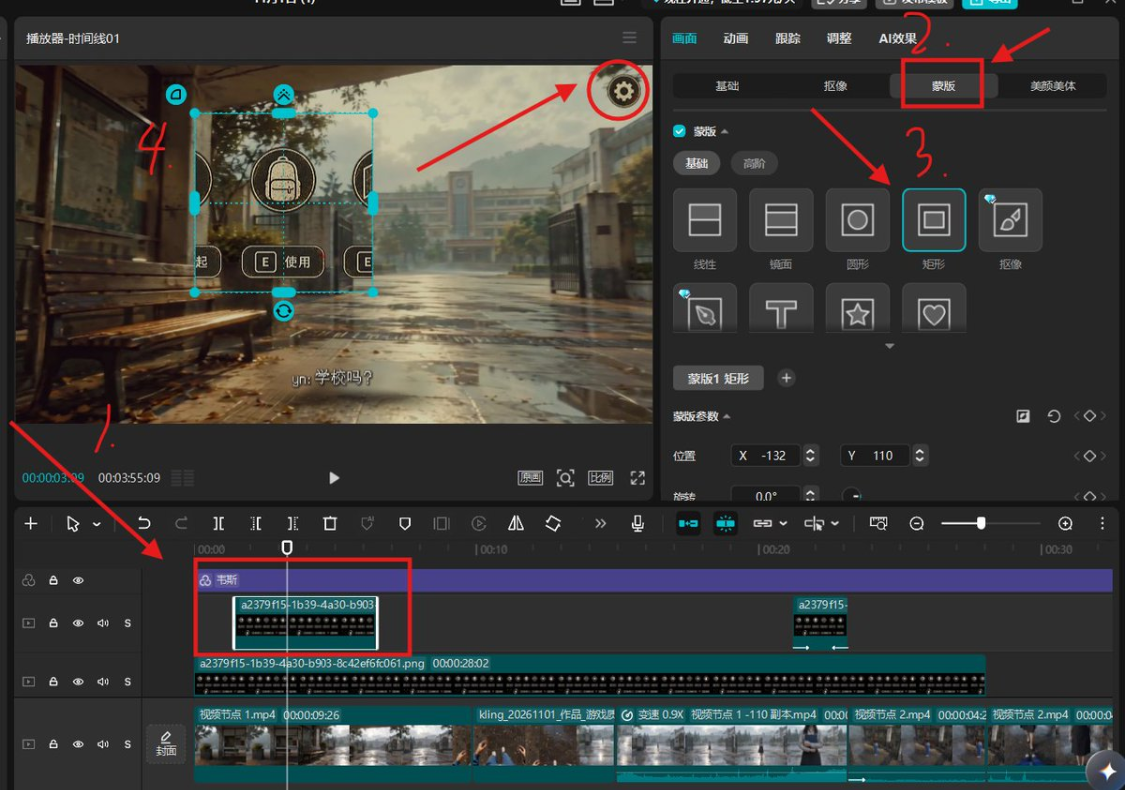
根据剧情,也可以加入“进入教室”“查看光荣榜”这类简短提示。
提示出现的位置和时间,要跟镜头动作对应。镜头靠近门口时再出现“进入教室”,观众才会理解它与当前画面的关系。
对于字幕设计,我这次用的是一个比较直接的方法:
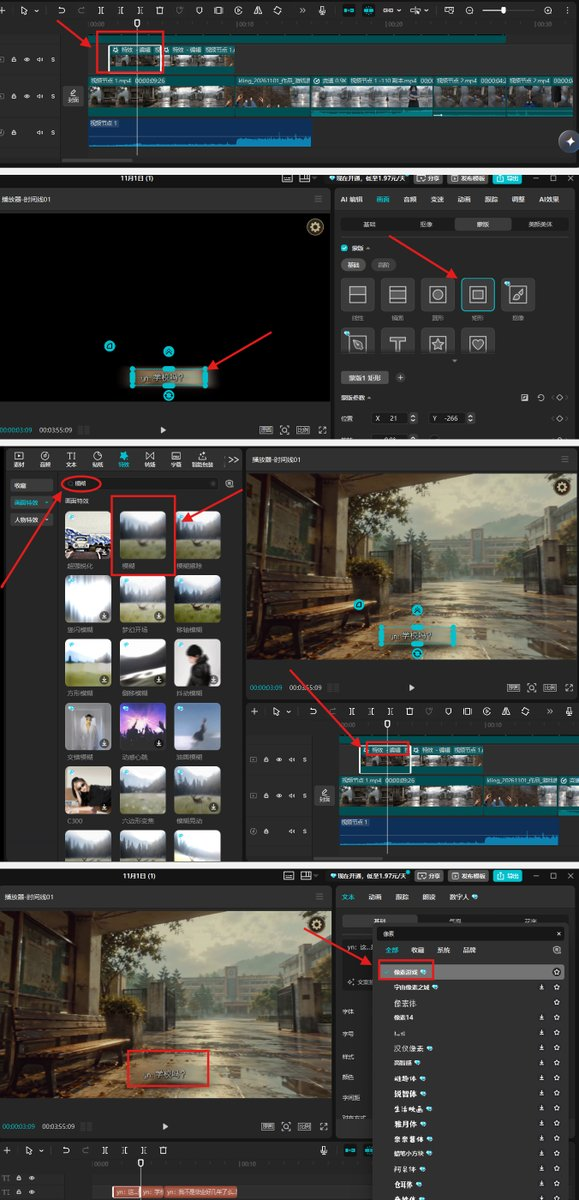
• 把原视频复制到上方轨道,与下方素材对齐。
• 用蒙版框出准备放字幕的区域,调整位置和加入羽化、阴影效果。
• 给上方这层素材添加模糊效果,只让字幕区域的背景变模糊。
• 在模糊区域上方添加文字,调整字号、修改字体为像素游戏。
这样,字幕后面保留了原画面的色彩和变化,同时又能与背景拉开层次,形成类似游戏对话框的效果。
字体、边距和字幕区域也尽量统一,让整条片子看起来像使用同一套游戏界面。
从一个小故事开始
做到这里,一条带有游戏式交互提示的 AI 短剧,就基本完成了。
现在做 AI 视频、AI 短剧的人越来越多,把短剧叙事和游戏体验结合起来,仍然是一个值得探索的方向。
这类轻体量的故事,相对没有那么吃剧本,只需要一个异常的设定,再通过视角、声音和交互提示等有趣的互动,让观众一步步进入故事。
把流程跑通之后,就可以尝试更多题材,找到属于自己的表达方式,这种影游融合形式值得继续尝试。
从剧本、人物和场景资产,到视频生成、镜头修补,再到 UI 和后期剪辑,这次尽量把我摸索出来的方法都拆开讲了。
可以先从一两分钟的小故事开始,把第一部作品做完。过程中卡住,就回到对应环节调整:故事不成立改剧本,人物不一致改资产,镜头突兀补过渡,游戏感不够再检查视角和 UI 的时机。