


在2026年的今天,AI视频工具已经不再是那个只会把图片简单扭一扭的玩具了。
但是,我发现90%的朋友在试图复刻那些大神级的AI视频时,依然停留在2024年的旧思维里。
很多人看到一个很棒的视频,第一反应是什么? ——截图。
然后把这张图扔给AI,问它:“这是什么?请帮我生成视频。”结果呢?你得到的往往是一个画面风格很像,但动起来完全不是那回事儿的东西。
原视频里那种惊心动魄的推拉镜头、那种细腻的光影流转,统统不见了。
为什么? 因为你从一开始,就把“结果”当成了“过程”。 视频不是一张会动的画。视频是“时间”和“空间”的各种参数在连续变化。
如果你只给AI一张截图,就像是给厨师看了一张菜的照片,却指望他能还原出烹饪时的火候和翻炒的手法——这在逻辑上是不成立的。 今天,我不教你那些虚头巴脑的形容词。
我们要聊点真东西:如何利用AI反推视频的“运动学规律”。 只要掌握这3个方法,你就能拿回AI视频创作的控制权。
第一章:反推“生成过程”,而不是“画面内容”
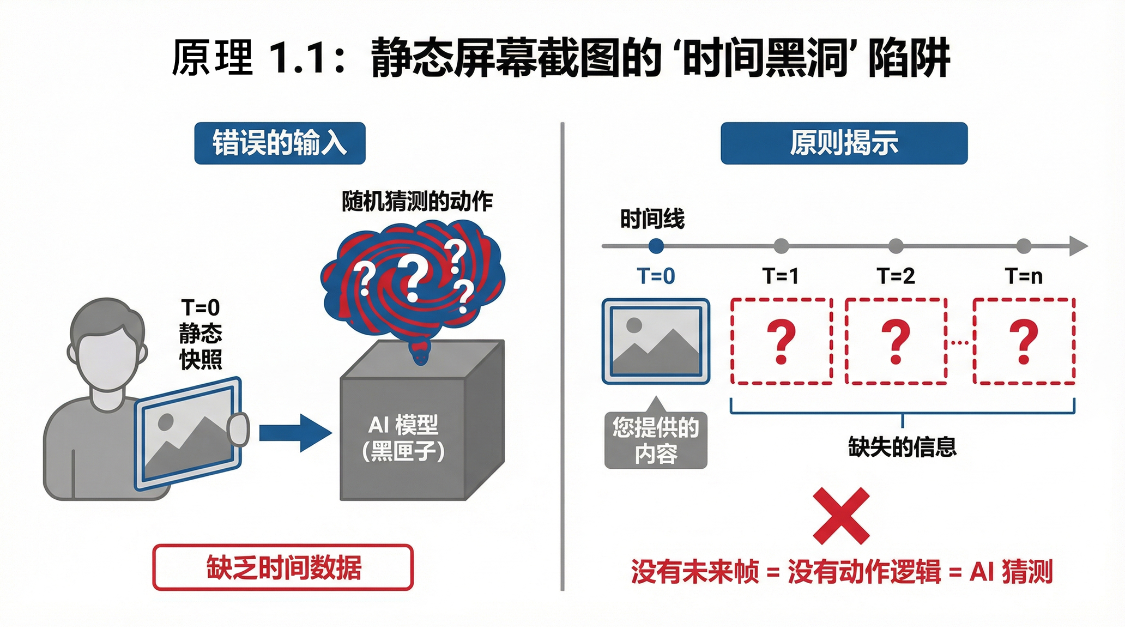
1.1 静态陷阱:为什么截图会失败?
在多模态模型(如最新的 Gemini 3或 Chat GPT 5.2)眼中,一张静态截图只是“T=0”时刻的一个切片。它无法包含T=1、T=2时刻的信息。
当你把截图扔给AI时,你实际上是在说:“给我画一个长得像这样的东西。” AI很听话,它画了。 然后你问:“让它动起来。” 因为没有“运动逻辑”,AI就开始瞎猜。它可能让云往左飘,也可能让树往右倒。这就是为什么你复现不了原视频神韵的根本原因——
你丢失了时间维度的信息。
1.2 正确姿势:三帧定乾坤
要反推一个视频的逻辑,我们不能只看“一张脸”,我们要看“一段生平”。
正确的方法是,在原视频中截取三个关键节点:
起始帧 (The Setup): 动作开始前的平静状态。
爆发帧 (The Climax): 动作幅度最大、光影变化最剧烈的那一瞬间。
结尾帧 (The Resolve): 动作结束后的画面。
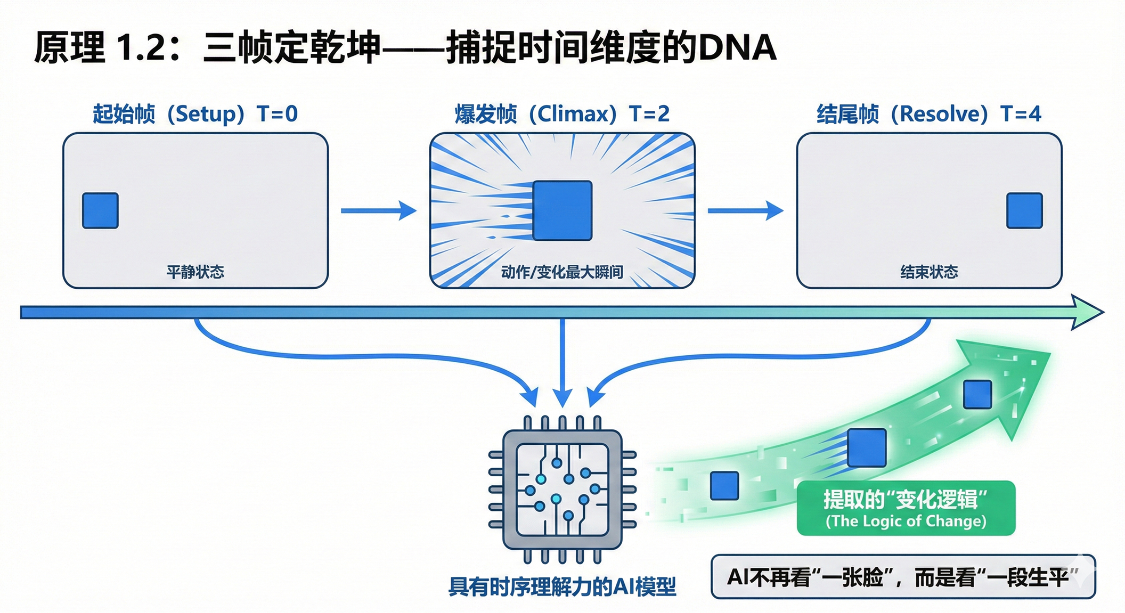
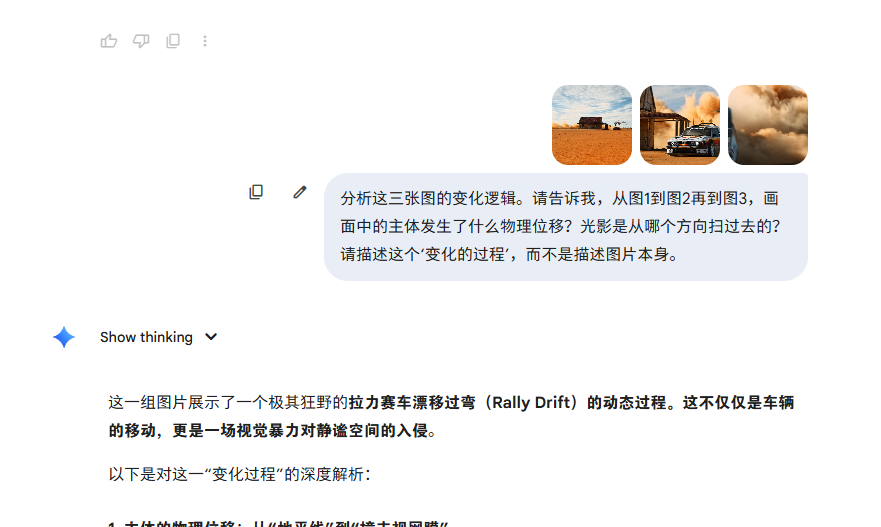
实战操作: 不要直接问AI“这画了什么”。 你需要把这三张图同时喂给具有“时序理解能力”的视觉模型,然后输入这样的指令:
“分析这三张图的变化逻辑。请告诉我,从图1到图2再到图3,画面中的主体发生了什么物理位移?光影是从哪个方向扫过去的?请描述这个‘变化的过程’,而不是描述图片本身。”
原理揭秘: 这时候,AI提取的不再是“一个穿着红衣服的女孩”,而是“一个红色色块在2秒内从左下角向右上角做加速运动,伴随着景深从f/2.8到f/11的变化”。 这才是视频的DNA。
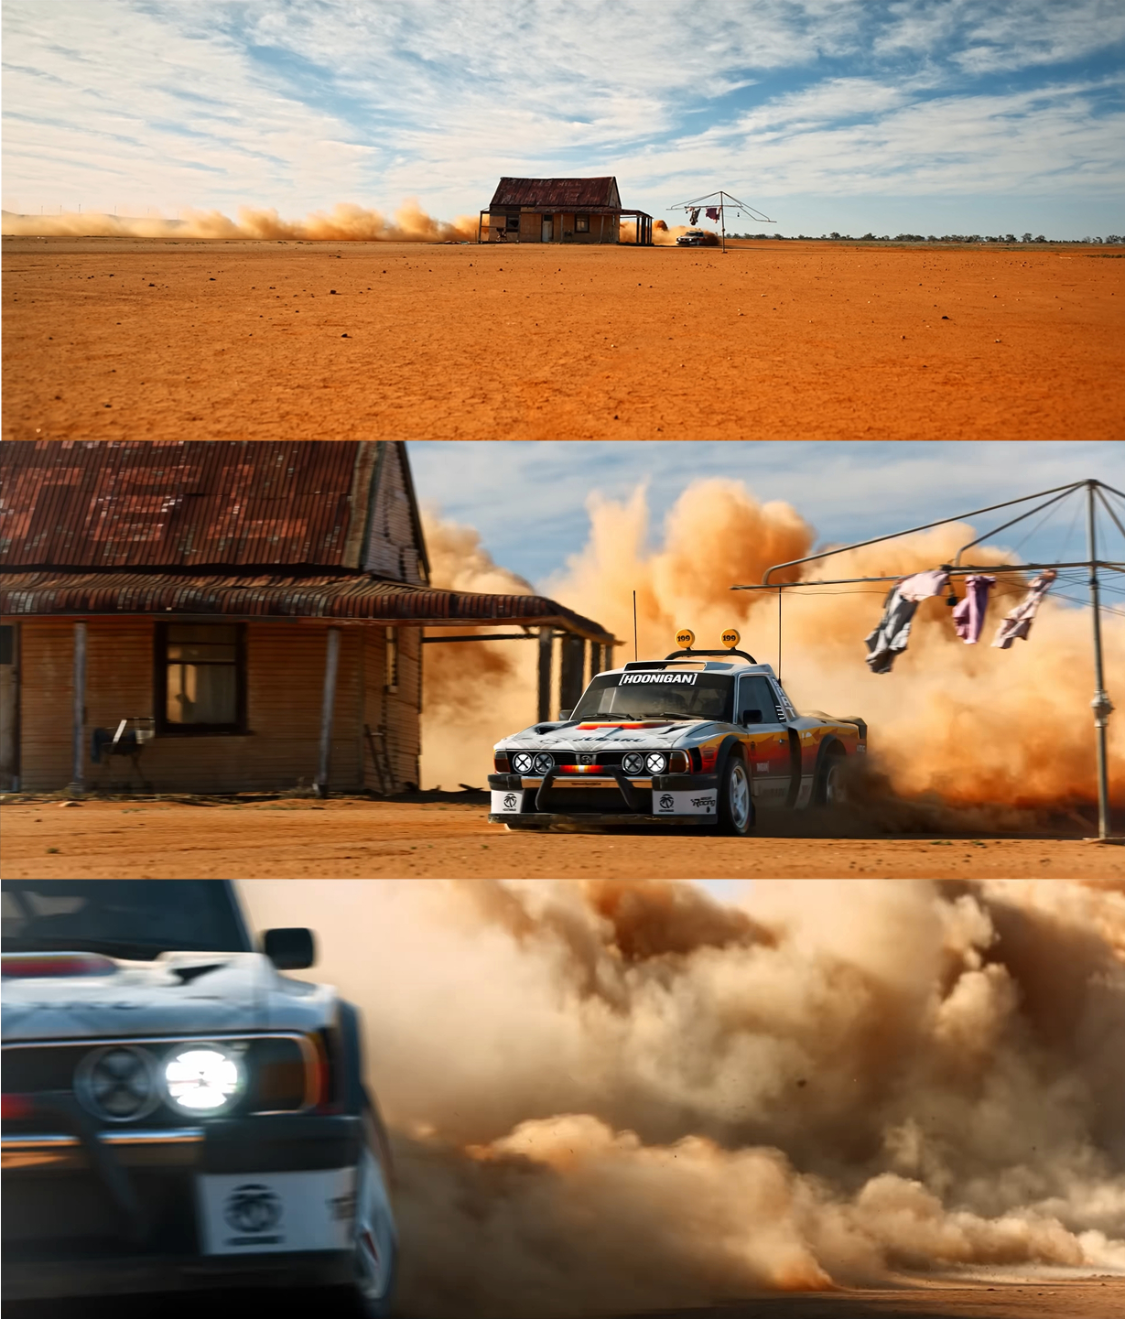
以下图为参考:
在Gemini中输入图片与提示词
“一个原本沉寂的荒漠空间,被一个高速旋转的金属物体暴力撕裂。主体带着毁灭性的动能,从远景的透视灭点死死咬住镜头,通过剧烈的横向漂移不断挤压画面的安全空间,最终用漫天的尘土和逼近的机械细节,彻底淹没了观察者的视线。”
第二章:用“相机运动结构”反推指令
2.1 别让AI写散文
很多新手喜欢问AI:“这个视频用了什么提示词?” AI通常会回复你一大段优美的散文:“宏大的史诗感,光影交错,充满希望的氛围……”
停!打住。 这些词在2024年可能有用,但在2026年,对于追求精准控制的视频模型来说,这些都是无效噪音。
视频的本质是摄像机与物体的相对运动。我们要反推的,是导演视角的“调度表”,而不是影评人视角的“观后感”。
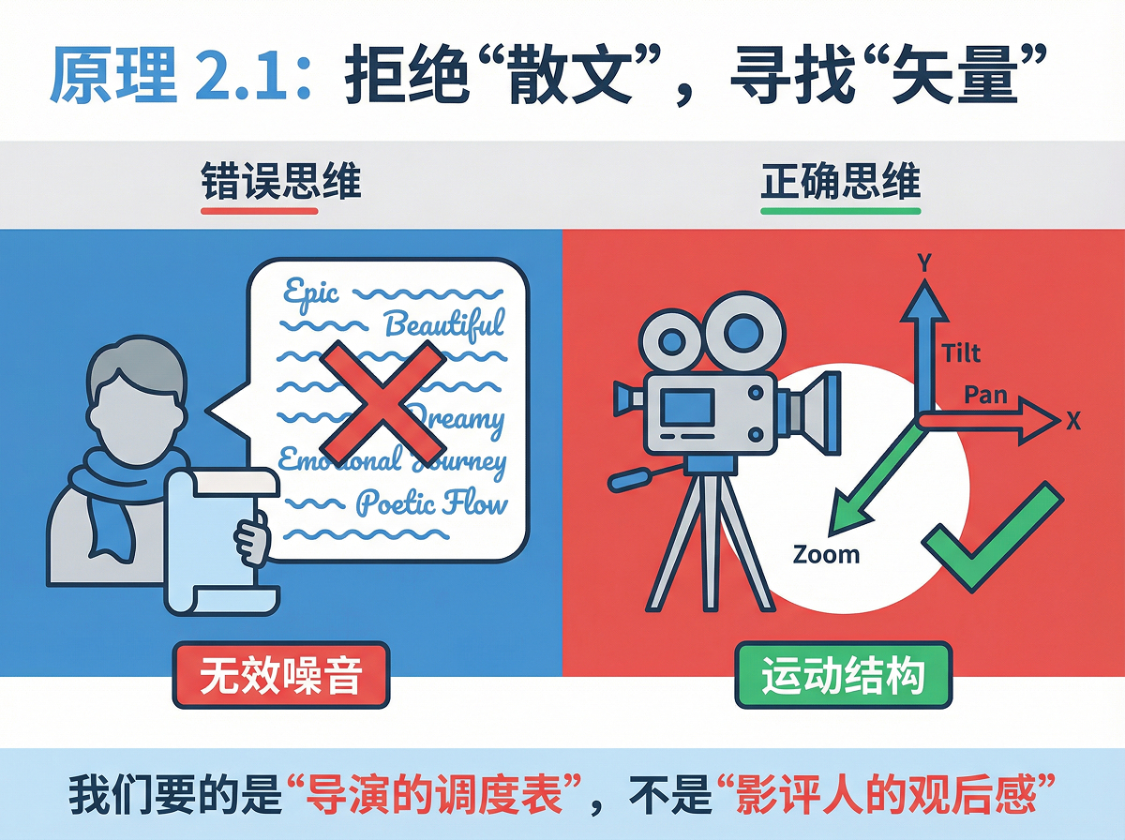
2.2 寻找“运动矢量”
我们要学会用“理科生”的思维去提问。我们要诱导AI输出矢量信息。
错误问法:
“这个视频感觉很震撼,它是怎么拍的?”
正确问法:
“忽略画面美感描述。请专注分析相机的运动路径(Camera Path)。
这是一个推镜头(Dolly In)还是变焦(Zoom)?
相机的物理坐标(X, Y, Z轴)是如何偏移的?
画面边缘的透视畸变是否随时间增加?(以此判断广角程度)”
为什么要这么做? 因为现在的视频生成模型,已经支持更精准的参数控制了。
如果是“推镜头”,背景会有视差变化(Parallax)。
如果是“变焦”,背景只有大小变化,没有视差。 AI如果能识别出这一点,你就能获得一个关键参数:–camera_motion zoom_in 还是 –camera_motion dolly_forward。这一个词的差别,就是“大片感”和“PPT动画”的差别。
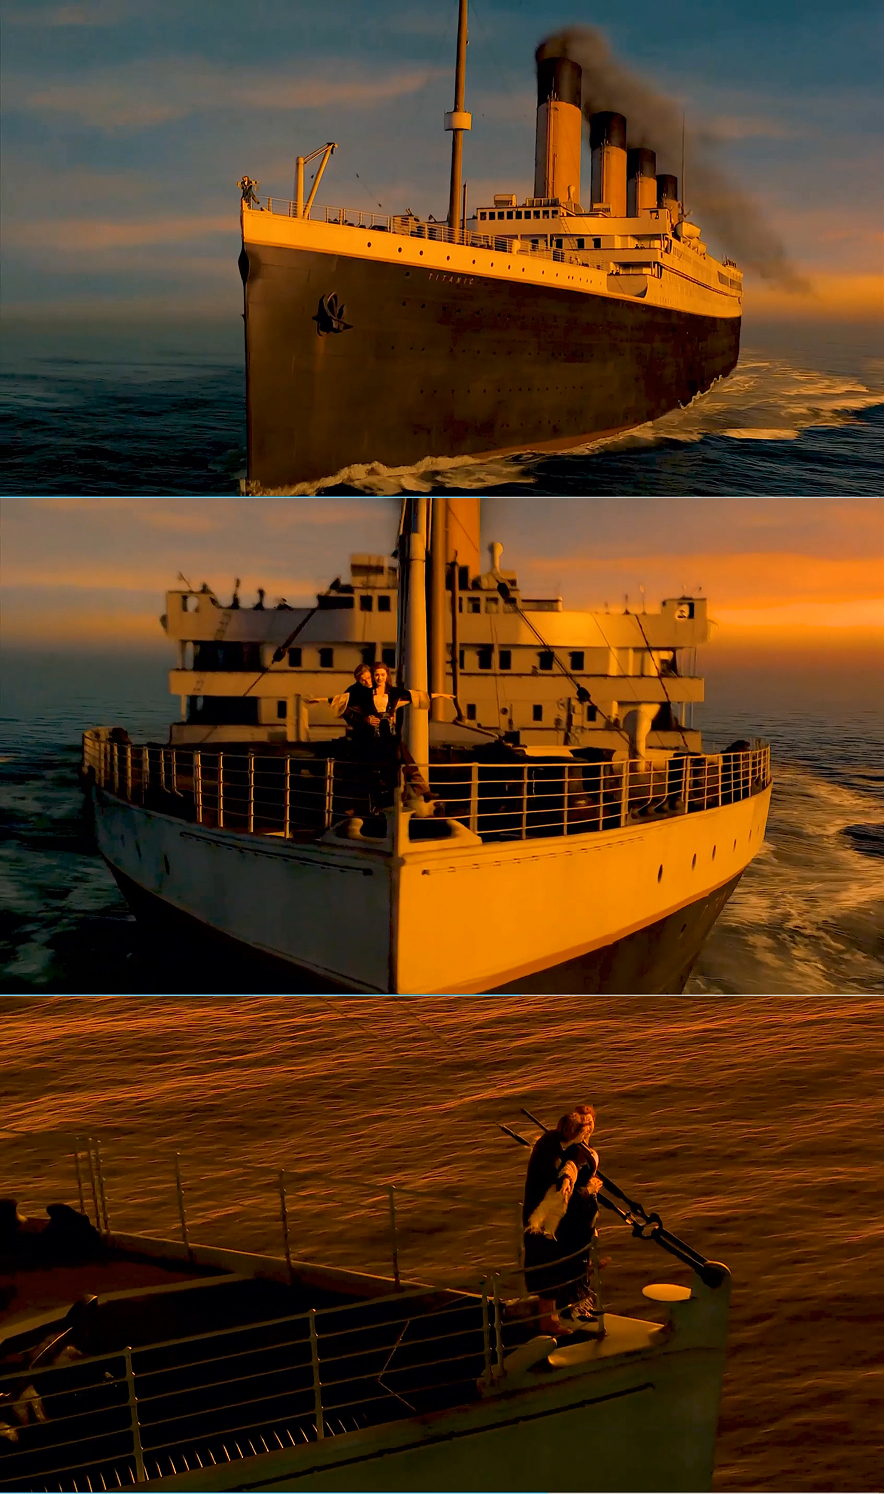
案例示范:
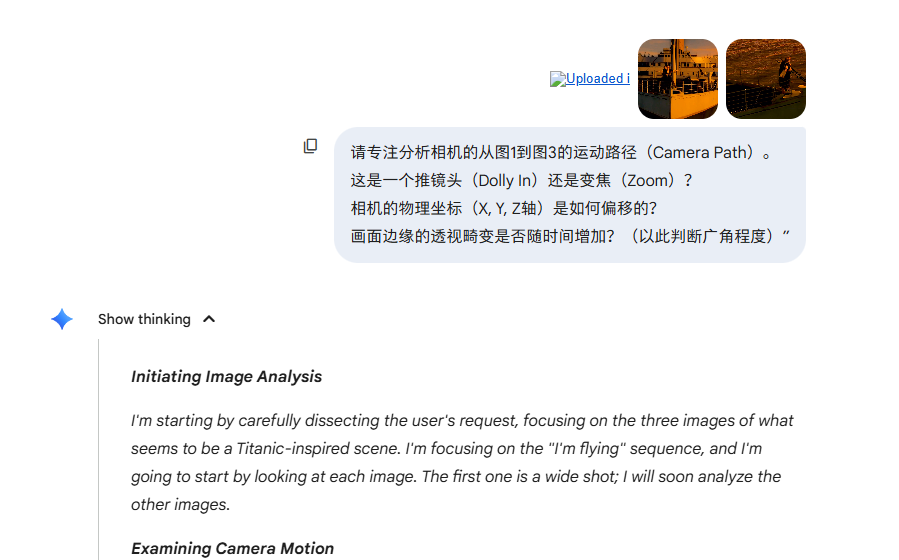
“Cinematic drone shot, establishing wide shot flying swiftly towards the ship’s bow, camera creates a sweeping motion, dolly in and crane up, transitioning from low angle to high angle close-up, dynamic perspective change, wide angle lens emphasizing speed and scale.”
第三章:具象化表达指令——从“许愿”到“编程”
3.1 翻译官的艺术
这是最关键的一步,也是区分“小白”和“专家”的分水岭。
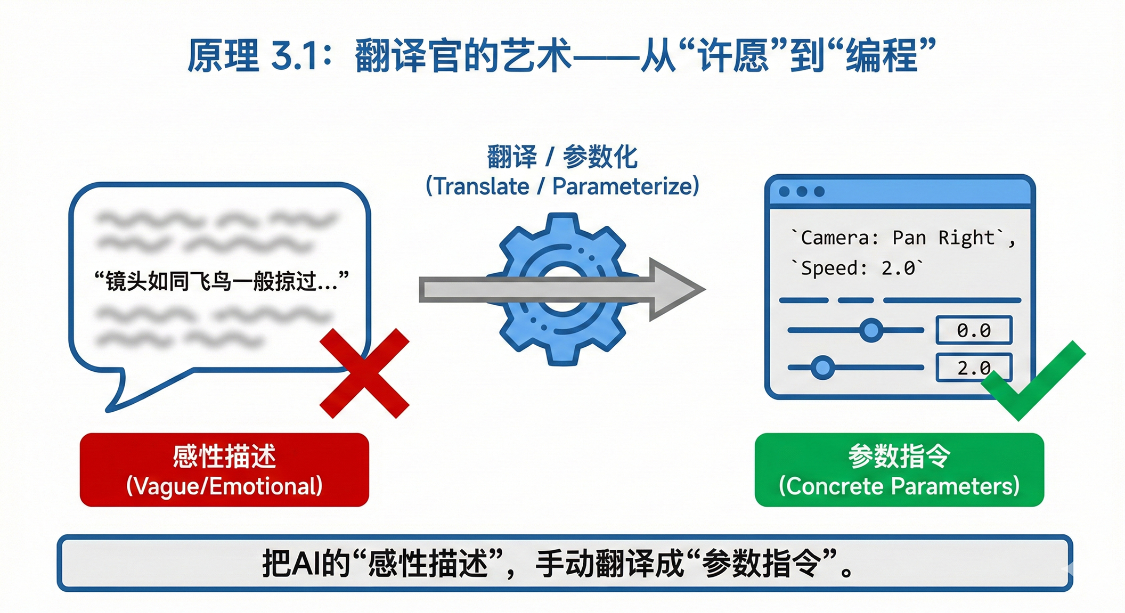
新手最容易犯的错,就是直接复制AI分析出来的长句子。 比如AI分析说:“镜头如同飞鸟一般掠过波涛汹涌的海面,带着一种自由而危险的气息……” 你把这句话扔回去生成视频,模型大概率听不懂,
我们要把AI的“感性描述”,手动翻译成“参数指令”。
3.2 剔除废词,建立“执行格式”
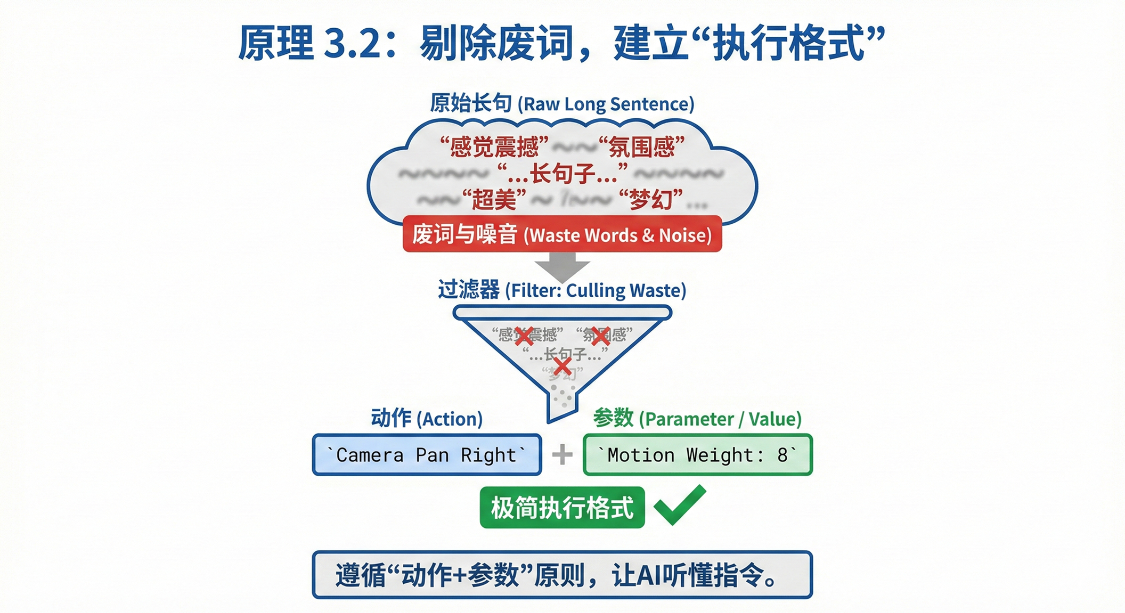
在2026年的提示词工程中,我们遵循“动作+参数”的极简原则。
来看看怎么翻译:
感性描述: “镜头平移,浏览整个场景”
翻译后: Camera Move: Pan Right / Horizontal Pan: +10
感性描述: “画面张力十足,动作非常剧烈”
翻译后: Motion Weight: 8 / Chaos: 20
感性描述: “时间流逝的感觉,光影快速变化”
翻译后: Speed: 2.0 / Lighting: Time-lapse
实操案例: 假设你想复刻一个“赛博朋克城市急速穿梭”的视频。 不要写:“一个很酷的未来城市,飞得很快,灯光拉成线。” 要写(基于反推结果):
Subject: Cyberpunk City Street, Neon lights. Action: Hyper-lapse forward. Camera: Dolly Forward: Fast, Motion Blur: High.
只有当你开始用动词和数值说话时,AI才能真正听懂你的导演指令。
结语:解构运动学,做AI的主人
其实,所谓的“视频反推”,本质上是在解构运动学规律。
AI视频生成技术发展到今天,已经不再是那个“抽卡游戏”了。它越来越像是一个精密的物理模拟器。
如果你只关注表象的颜色和构图,你永远只能跟在别人后面跑。
但当你学会剥离画面的表象,去触碰背后的参数逻辑——是推拉摇移,是焦距变化,是光线位移——你才算真正拥有了创作的自由。
记住:不要去“许愿”一个好视频,要去“构建”它。