

生图时,先写人物和场景,然后在后面补上一长串“超清、8K、电影感、最佳画质、超高细节”;做视频时,则恨不得把人物抬手、转头、迈步、转身的每一个动作都拆开,生怕少写一句AI就理解不了。
这些写法不能简单地说“错了”。
问题在于,模型已经发生了变化。
以前模型本身理解能力有限,提示词很大一部分作用是在帮它补能力。图片默认质量不够,我们就不断增加画质词;视频不会自己理解动作之间的关系,我们就把一个简单动作拆成很多步骤。
现在的新模型已经能够理解更加完整的自然语言,对人物、环境、动作关系的判断也越来越强。如果我们的提示词仍然把大量篇幅用在模型已经能够自己完成的事情上,不但浪费信息,有时还会给模型增加额外限制。
所以现在学习提示词,真正需要更新的并不是几个所谓的“新关键词”。
需要更新的是:
提示词到底应该负责解决什么问题。
一、所谓“提示词过期”,并不是以前的词突然不能用了
先从AI生图说起。
以前非常常见的一条提示词可能是这样的:
一名年轻女生站在街边,超高清,8K,电影感,最佳画质,大师摄影,超高细节,真实皮肤质感,精致画面。
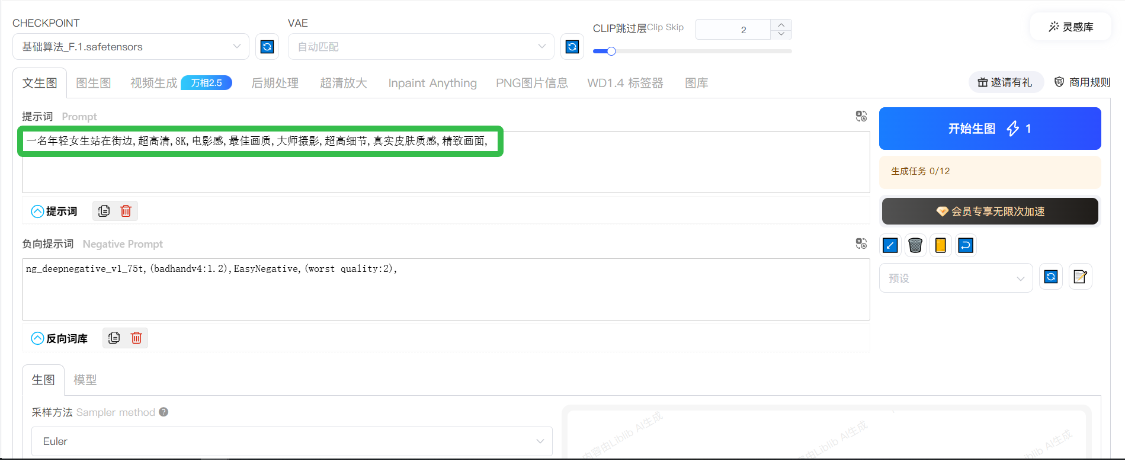
来源于webUI
这种写法为什么会出现?
因为早期模型本身的画面完成度有限。我们只告诉它“一个女生站在街边”,最后得到的图片可能人物细节不够、背景比较粗糙、材质不稳定,于是大家开始不断向提示词里加入各种提升质量的描述。
“高清”不够,就加“超高清”。
“超高清”还不放心,再加“8K”“最佳画质”“大师摄影”。
这些词在当时承担的其实是一种辅助模型提高画面完成度的作用。
但随着模型不断更新,这件事情正在发生变化。
现在很多图像模型即使没有写上一大串画质词,也已经能够默认生成比较完整的人物、光线、服装和环境。换句话说,过去提示词需要重点解决的“图片够不够精致”这个问题,已经没有以前那么突出。
这时候如果我们仍然按照旧方法不断叠加:
8K、超高清、极致细节、最佳质量、电影级、顶级摄影、完美光影……
结果不一定会因此出现明显提升。
有时候模型反而会把这些要求同时推向极致,让人物皮肤更加光滑、光线更加漂亮、画面更加工整,最后产生一种很典型的生成效果:看起来什么都很好,但就是很像AI。
所以“提示词过期”并不是说,从今天开始“8K”三个字绝对不能出现。
真正发生变化的是:
这些词已经不应该继续占据提示词的核心位置。
如果你的确需要某一种清晰度、质感或者影像风格,当然依然可以保留。但没有必要为了显得提示词专业,把意思相近的画质描述一层层叠上去。
现在更值得思考的是另外一个问题:
除了告诉AI“做得更好看”,还有什么信息真正决定了这张图片长什么样?
二、生图提示词的重点,正在从“提高画质”转向“制造真实感”
现在再去写一张偏真实摄影的AI图片,可以换一个思路。
以前我们是在描述结果:
电影感、超高清、顶级摄影、完美光影。
现在可以开始描述这张照片是怎样产生的。
比如仍然是一名女生站在街边。
过去可能写:
一名年轻女生站在城市街头,超高清,8K,电影感,大师摄影,最佳画质。
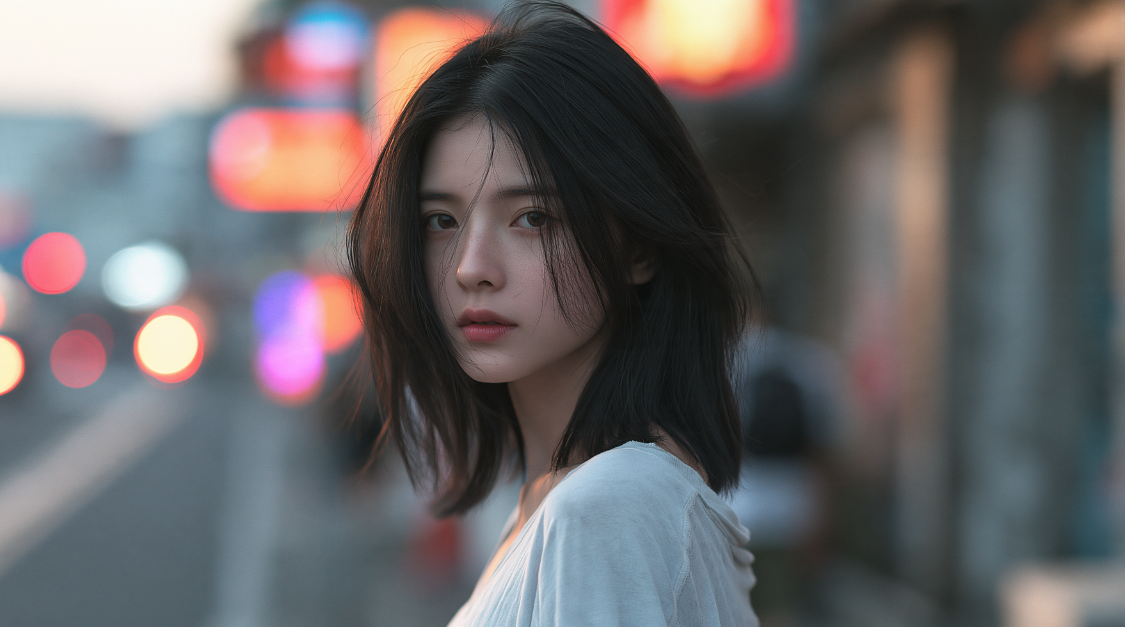
现在可以换成:
一名年轻女生站在傍晚的城市街边等车,手里拿着手机,偶尔低头查看消息。使用手机相机近距离拍摄,保持普通真实的生活记录感,街边自然光照在人脸和头发上,背景保留正常的道路、车辆和城市环境。
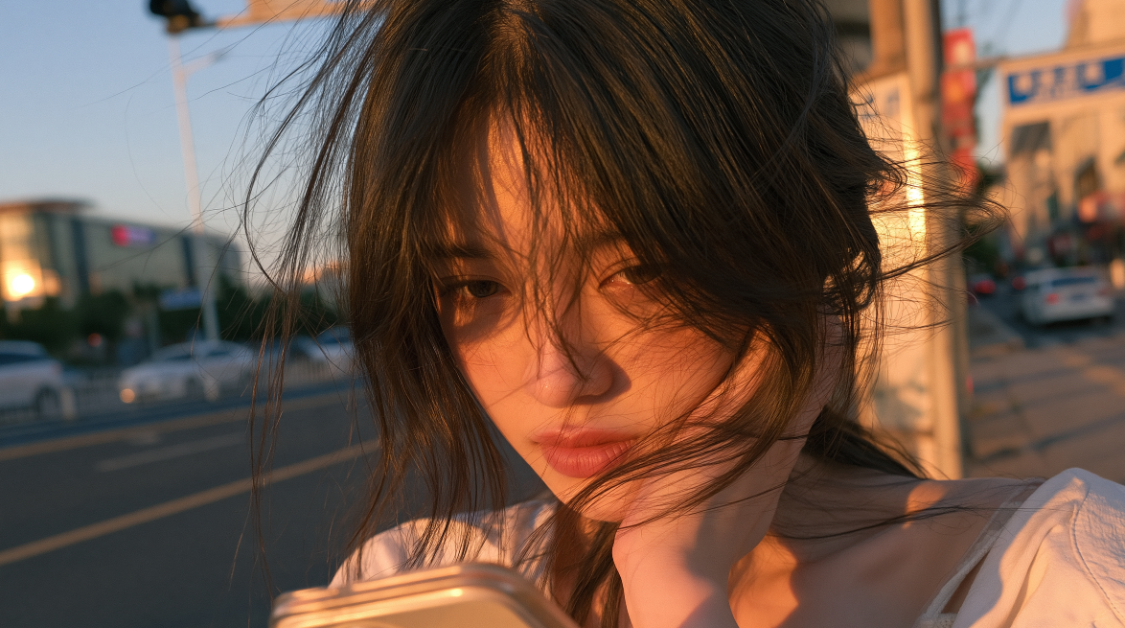
这里最重要的变化不是提示词变长了,也不是加入了更多摄影术语。
而是信息类型发生了变化。
第一种写法主要是在告诉模型:
“我要一张质量很高的图片。”
第二种写法则开始告诉模型:
人物在做什么、什么时间拍、使用什么方式拍,以及最终应该呈现怎样的真实状态。
这就是现在“真实感提示词”一个非常重要的方向。
例如同样是人像,我们写“专业棚拍”,模型会往更加正式、完整、布光明确的方向理解;写“手机相机拍摄、普通真实自然感”,模型接收到的又是另外一种画面要求。
所以真正有效的信息,不一定听起来特别专业。
很多时候反而是一些很普通的描述:
手机相机拍摄。日常生活记录。室内正常环境光。傍晚街边自然光。人物没有刻意摆拍。像正常拍摄得到的照片。
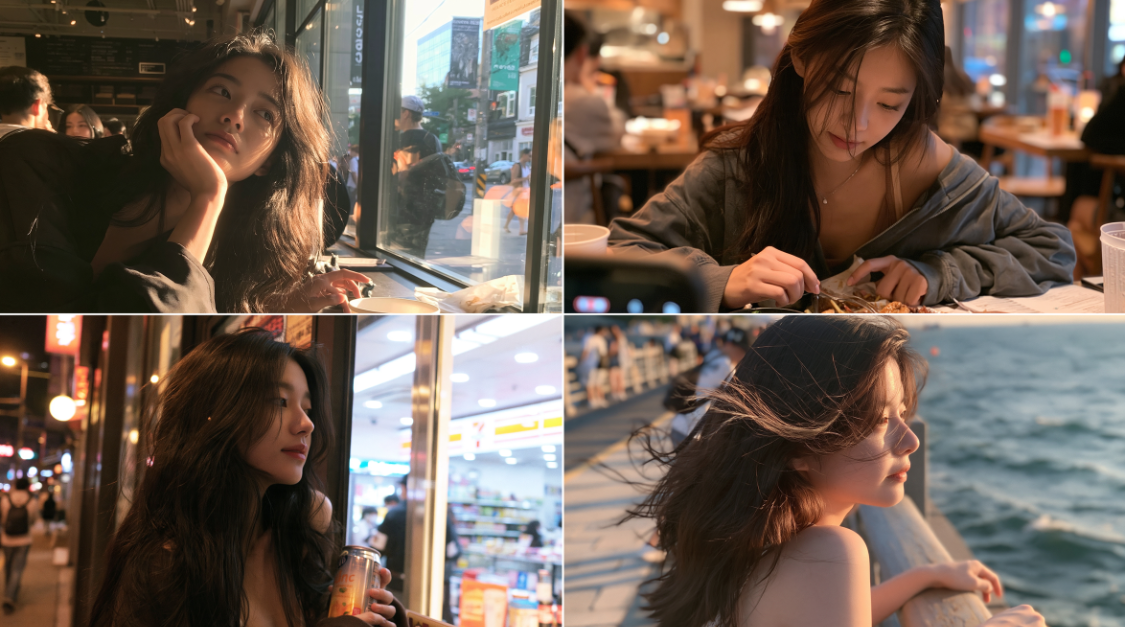
都由Midjourney生成
它们的作用并不是单纯“降低画质”,而是在帮助模型确定:最终图片应该属于哪一种真实的拍摄状态。
真正应该改变的是思考方式。
如果你想要商业产品图,那就按照商业拍摄的逻辑去描述;
如果你想要旅行途中随手记录的人像,就去描述它的环境、时间和拍摄方式;
如果想生成正式的杂志人物摄影,那么相机、灯光和人物状态又应该重新调整。
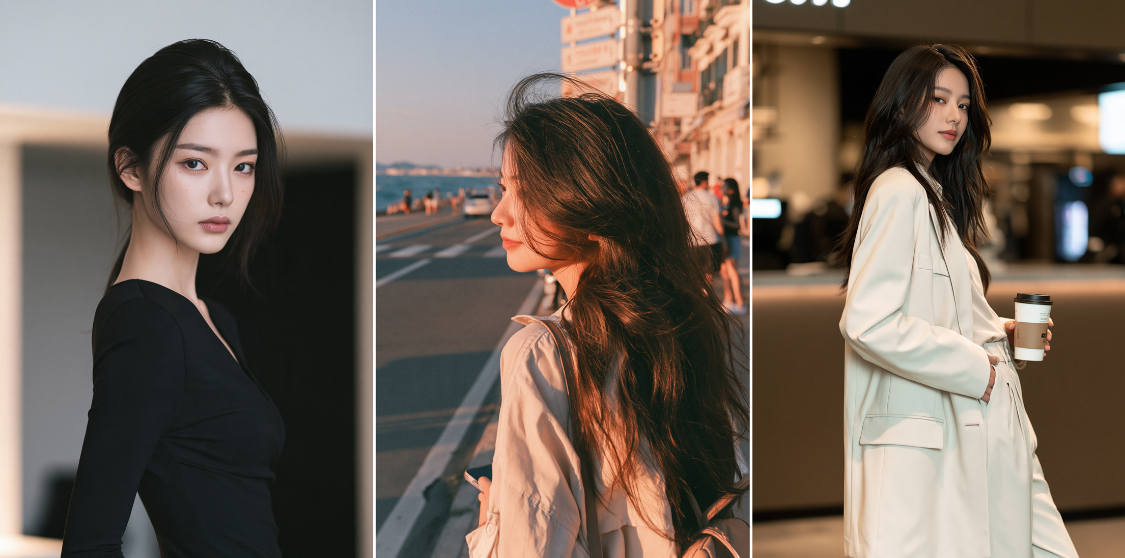
也就是说,
不是所有AI图片都必须追求同一种“真实感”。
我们真正需要告诉模型的是:
这张图为什么会被拍成现在这个样子。
三、视频提示词变化更明显:模型开始能够自己补全动作
相比图片,AI视频提示词的变化其实更加明显。
以前的视频模型理解能力比较弱,尤其是在处理人物动作时,我们经常会遇到一个问题:一句正常人类完全能够理解的话,模型不一定能够把中间过程做完整。
比如:
女生听见有人叫她,于是转身。
由老模型可灵2.1生成
对于人来说,这句话非常清楚。但早期模型可能出现很多问题。
所以过去我们经常需要把一个动作不断拆开:
人物先停止原本动作,随后视线向后移动,头部开始旋转,肩膀跟随转动,上半身继续旋转,脚步调整位置,身体逐渐完成转身……
这种方法过去有它存在的理由。
因为当模型无法理解动作之间的关系时,我们只能自己替它把过程讲清楚。
但现在情况已经开始变化。
新的视频模型对动作、惯性、人体关系和事件连续性的理解能力越来越强,一个正常的转身、回头、走路、停下或者伸手,它已经能够自动补全其中相当一部分过程。
这个时候如果仍然把一个非常简单的动作拆成七八条甚至十几条指令,反而可能产生另一个问题。
因为你写得越细,模型同时需要满足的条件就越多。
头部有自己的变化要求,肩膀有自己的要求,双手有要求,腿部又有另一套时间顺序。当这些细节之间存在轻微冲突时,生成出来的人物就容易出现停顿、卡顿或者一段一段执行动作的感觉。
最终看上去不是更自然,而是更机械。
所以现在写视频动作时,重点可以逐渐从:
“这个动作到底每一步怎么做?”
转向:
“这个动作为什么会发生?”
例如:
女生转身。
可以进一步写成:
女生原本正在向前走,突然听见身后有人叫她,她停下脚步并向声音传来的方向转身,随后看到站在后方的人。
这时我们已经告诉模型三个关键关系。
人物原来在做什么。
为什么突然改变动作。
完成动作以后发生什么。
至于正常转身时头、肩膀、腰和双腿应该怎样互相配合,对于现在的模型来说,可以适当让它自己完成。
这也是为什么现在的视频提示词不是越短越好。
不是把过去二百字的动作描述删成“人物转身”四个字。
而是把原来用于重复控制动作过程的文字,重新放到更加重要的内容上。
四、视频提示词真正应该写清楚的,是整个视频的方向
当模型能够自己补全一部分动作以后,创作者真正需要承担的工作其实没有减少。
只是控制重点发生了变化。
以前我们可能花大量时间规定人物的身体怎么动,现在更应该提前确定:
这是一条什么视频?
故事发生在哪里?
发生在什么时候?
以什么方式拍摄?
人物接下来为什么行动?
这一镜结束以后又进入什么内容?
这些东西模型无法替你决定。
比如你告诉AI:
一个女生走进车站。
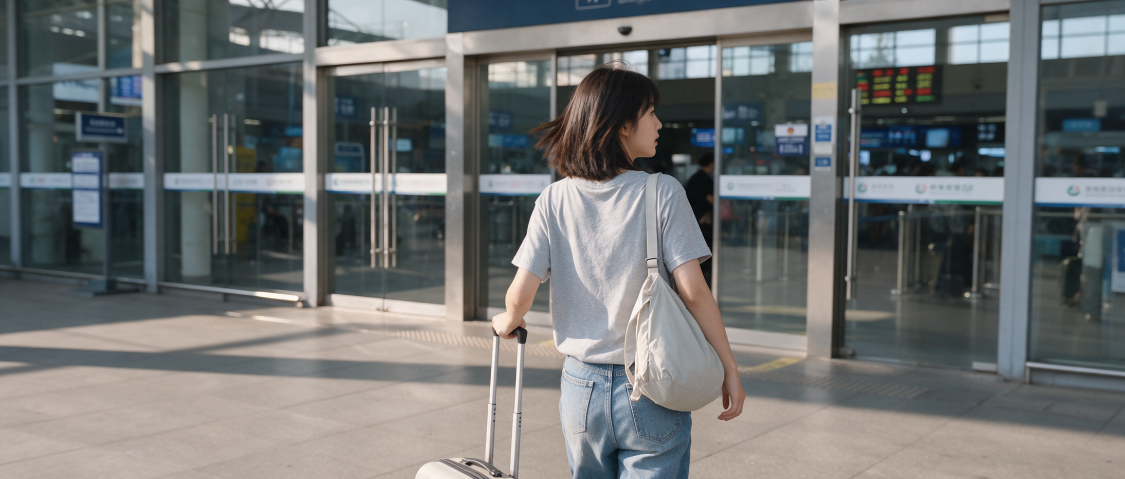
模型当然能够让她往前走。
但它不知道你是在拍一条生活记录短片、悬疑短片、广告片还是剧情片;不知道这是清晨还是晚上,也不知道摄影机应该像路人一样在旁边观察,还是像跟拍摄影师一样一直贴着人物。
这些都属于视频方向。
同样是一个转身,如果前面是“听到广播提示列车即将进站”,它的动作逻辑是一种状态;如果前面是“突然听到身后有人叫自己的名字”,又会产生另一种状态。
因此现在写视频提示词,最重要的改变之一就是:
少花一点文字规定AI已经知道怎样完成的事情,多花一点文字告诉它你真正想拍什么。
但这里同样不能走向另一个极端。
如果是普通走路、正常回头,这些内容确实可以让模型适当补全;但如果你要求角色准确拿起一个指定产品、两个人交换某件物品、特效必须从手臂某个位置开始出现,或者动作本身就是视频最重要的视觉效果,那么这些过程依然需要写清楚。
所以新的思路并不是:
以后全部交给AI。
而是:
把需要创作者决定的方向控制住,把模型已经能够理解的自然过程适当放开。
五、现在的视频提示词,可以整理成四个真正重要的部分
如果不再把大量篇幅都花在身体动作上,一条完整的视频提示词应该写些什么?
可以把它整理为四部分:
内容设定、素材分工、整体基调、分镜。
这也是现在写多模态AI视频时,非常值得固定下来的结构。
首先是内容设定。
在提示词开头先告诉模型,这到底是一条什么样的视频。例如:
生成一段10秒的写实人物短片。故事发生在夏日下午的城市商业街,一名女生结束购物后独自走向街边。整条视频采用手机跟随拍摄的方式完成。
这一部分主要解决的并不是某一个镜头怎么动,而是整条视频的基础信息。
视频类型是什么,故事发生在哪里,是什么时间,以及使用什么方式或者设备进行拍摄,都应该尽量在这里提前确定。
因为这些信息会影响后面的所有镜头。
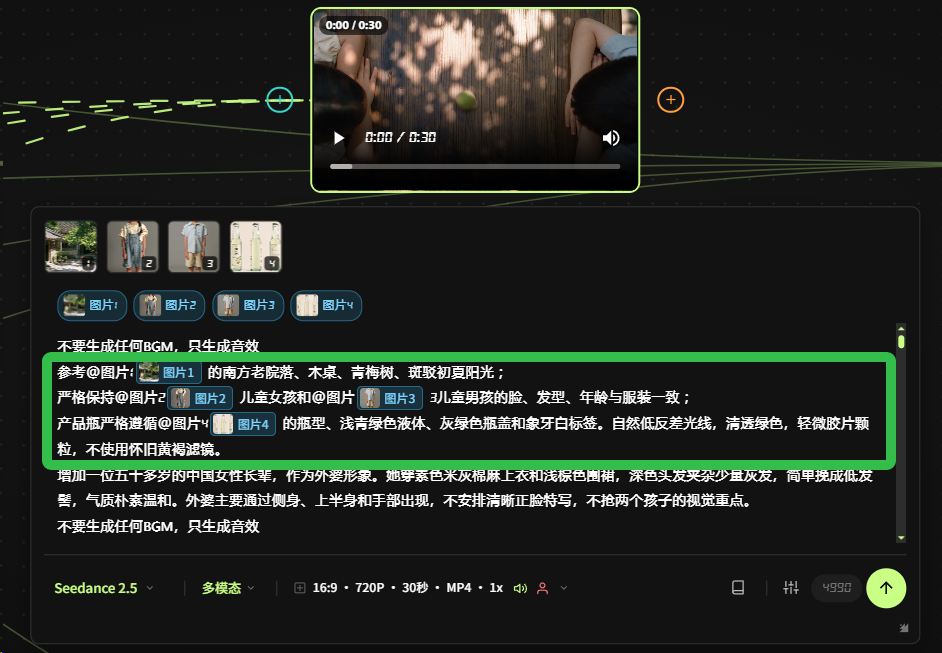
第二部分是素材分工。
现在很多视频生成已经不再只有一张参考图,我们可能同时提供人物图、场景图、服装图、产品图,甚至动作参考。
素材多了以后,最大的问题就是模型需要判断:
到底哪张图片负责什么?
所以不要只写:
参考以上图片生成视频。
而应该把它们分别说明。
例如:
图1用于参考女主的五官、发型和人物身份;图2用于参考商业街的环境、建筑和道路关系;图3只用于参考女主服装;图4用于参考手中购物袋的外观。人物素材不要改变场景结构,场景素材也不要改变人物外貌。
复制
素材分工写清楚,本质上是在减少不同参考信息之间互相干扰。
第三部分是整体基调。
也就是整条视频应该始终保持什么样的状态。
例如:
写实电影级商业广告质感,清透自然的初夏空气感,柔和低反差,暗部通透,高光细腻不过曝,色彩克制,青梅绿、象牙白与温暖木色自然融合。真实细腻的皮肤、果皮纤维、水珠、玻璃折射和冷凝水质感,轻微胶片颗粒,柔和高光晕染,画面干净、湿润、清新,有真实生活温度,同时保持高品质饮料广告的精致感。
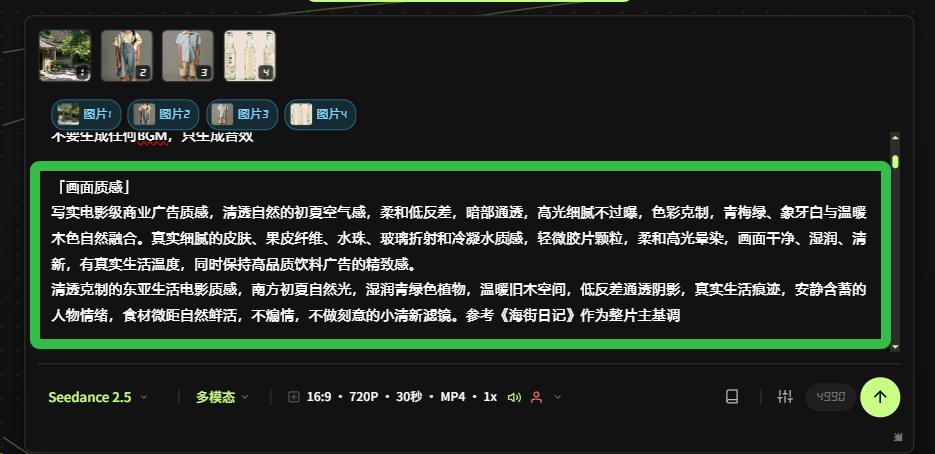
这一部分和过去单独写一句“电影感”不一样。
它需要确定的是整条视频共有的视觉和表演方向,让后面的多个镜头不会各自生成成完全不同的感觉。
完成这三部分以后,最后才进入分镜。
六、分镜依然要设计,但不要再替模型完成所有中间动作
到了分镜部分,创作者真正需要控制的,是事件顺序和镜头结构。
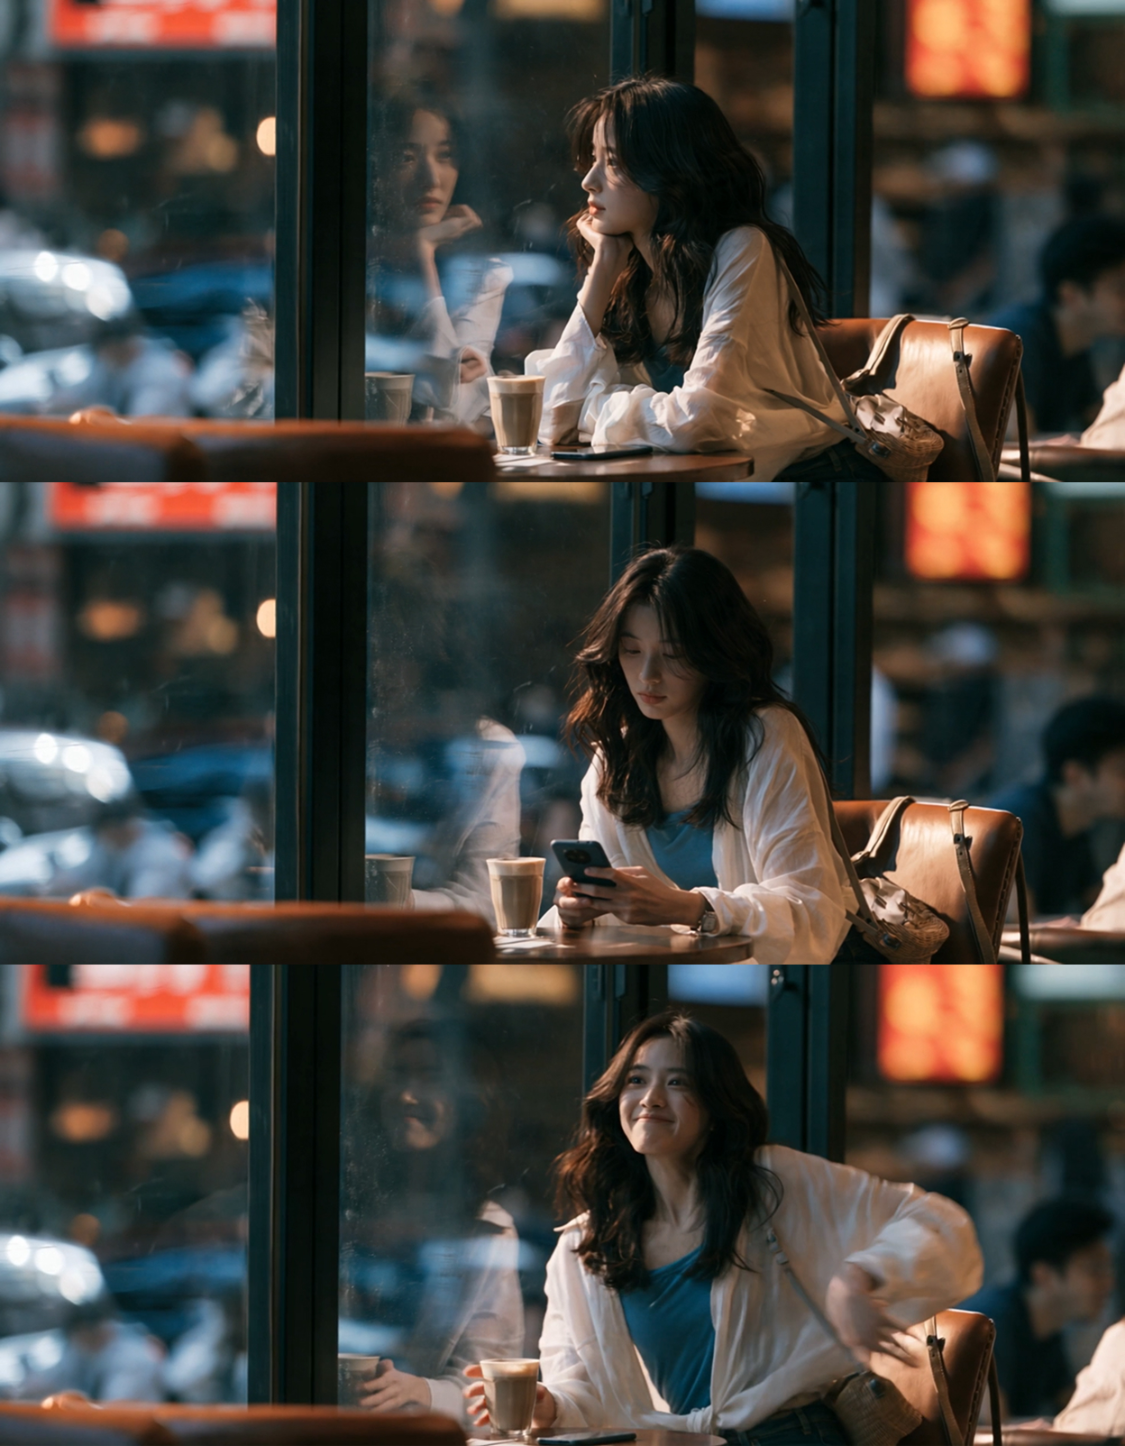
例如一条简单的人物短片可以这样写:
女生独自坐在咖啡店靠窗的位置,左手托着脸看向窗外,桌上放着咖啡和手机。手机突然亮起收到消息,她的注意力被吸引,低头拿起手机查看,看到消息后神情逐渐放松。随后她放下手机,拿起咖啡喝了一口,再次看向窗外,这时发现正在等的朋友已经出现在街对面。她立刻坐直身体,神情明显变得开心,放下咖啡,拿起椅背上的包准备起身离开。摄影机前半段保持人物斜前方中近景观察,在她准备起身时轻微后退并横移,为人物动作留出空间。
这里依然有动作,也有摄影机变化。
但是我们没有继续写:
人物先把头低下多少度、右手什么时候伸向手机、手指如何握住咖啡杯、起身时哪只脚先负责支撑。
因为对于这些正常动作来说,它们已经属于模型能够根据前后关系自行补全的部分。
分镜真正需要我们明确的是:
第一镜人物在做什么,什么事情改变了她的状态,下一步行为是什么,以及镜头什么时候进入下一段内容。
也就是说,过去我们习惯设计的是:
动作的每一个步骤。
现在更应该设计的是:
整段动作为什么连续发生。
这其实也是现在提示词最值得重新理解的一件事。
AI能力变强以后,我们不是没有东西可以写了,而是提示词开始从“操作说明书”慢慢变成“创作说明”。
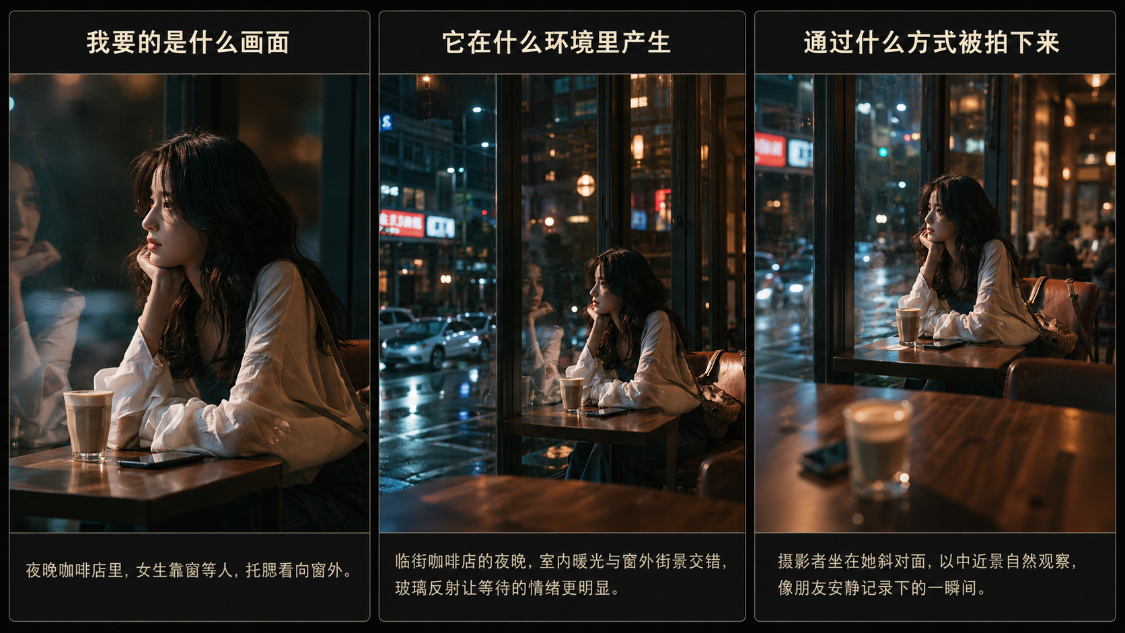
生图也是一样。
以前我们反复告诉模型:
高清一点,再高清一点,再精细一点。
现在应该开始告诉它:
我要的是什么画面,它在什么环境里产生,通过什么方式被拍下来。
所以以后写完提示词,可以先问自己一个非常简单的问题:
我写的这些内容,是在帮助AI理解我的创作意图,还是只是在重复提醒它完成本来已经会做的事情?
如果是后者,就可以适当删掉。
如果有一些决定画面方向的信息还没有写清楚,就应该优先补上。
提示词并不是字数越多越专业,也不是越短越先进。
真正发生变化的,是它的写作重点。
以前更多是在弥补模型能力。
现在则需要把模型已经具备的能力利用起来,把有限的提示词空间留给真正决定最终结果的信息。
这才是现阶段生图和生视频提示词最值得更新的地方。