

做一张好看的AI图片并不难,生成一个不错的5秒镜头,现在也越来越容易。
真正困难的是,当一个人物需要连续出现十几个镜头,当故事从室内走到室外,当人物开始换衣服、受伤、说话、和其他角色互动以后,画面还能不能保持稳定。
很多人遇到这些问题,第一反应都是继续修改提示词。
人物变脸,就增加更多外貌描述;场景改变,就把环境写得更详细;声音不稳定,就重新上传参考音频。
但项目越长,你越会发现:
提示词写得更长,并不代表AI理解得更准确。
真正有效的方法,是先把一个复杂的视频项目拆成几种可以反复调用的资产,再让提示词负责调用和控制这些资产。
这一节我们就从 人物、声音、场景和提示词 四个部分,把这套方法完整讲清楚。
一、人物一致性:不要只做一张三视图,要建立人物资产
制作AI视频时,人物几乎是最容易发生变化的部分。
尤其进入中景、全景或者多人镜头以后,经常会遇到脸型变化、五官漂移、身材比例改变、服装细节丢失等问题。
很多人会觉得,是不是三视图做得不够详细。
于是开始往同一张图里不断增加内容:
正面、侧面、背面、人物头像、表情、服装细节、道具……
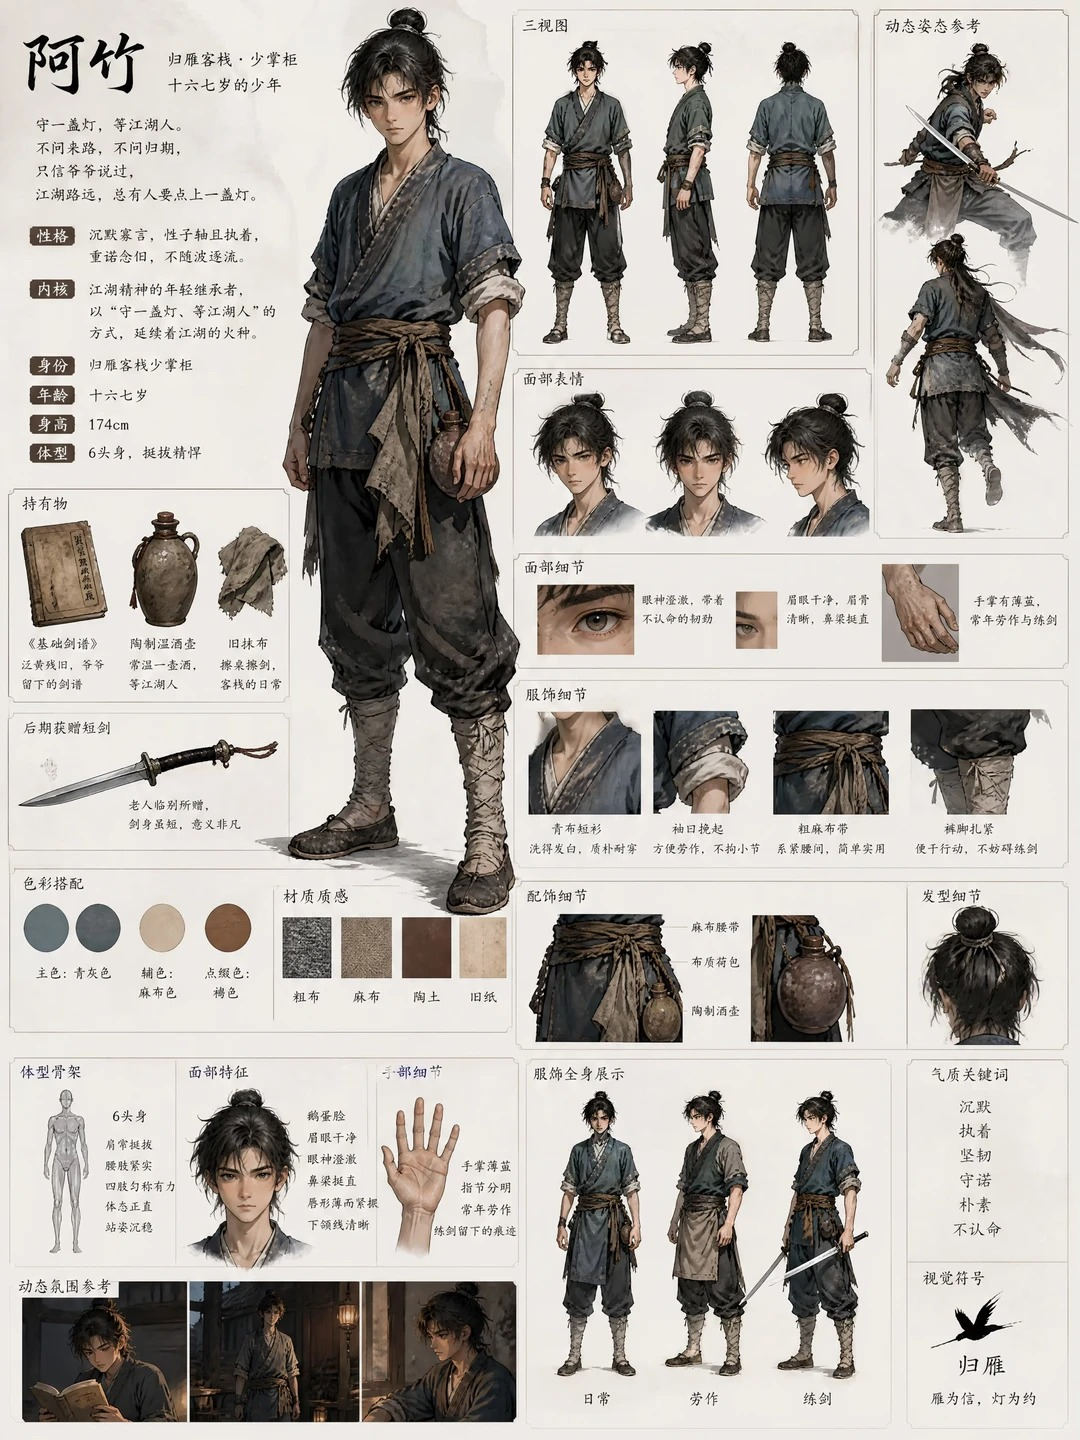
极其繁杂的人物图
看起来信息越来越多,但对于AI来说,不一定更容易读取。
因为一张参考图的面积是有限的。
如果三个人物视角全部挤在一张图片中,每张脸在整张参考图里的占比就会非常小。
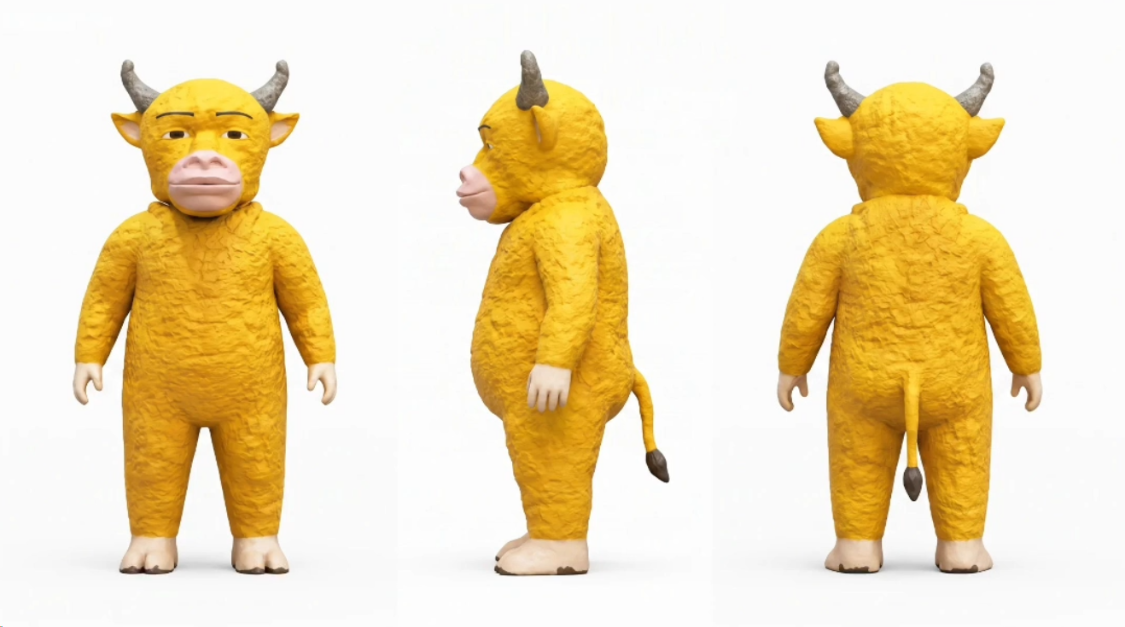
生成近景时可能还看不出明显问题,但一旦进入全景或者复杂镜头,AI能够获得的准确面部信息就会减少,只能自己补充。
人物自然更容易发生变化。
更稳定的方法,是把“脸”和“身体”分开
可以把人物资产简单理解成两个部分。
第一部分负责人物长什么样。
准备一张清楚的面部参考,让脸在画面中的占比足够大,重点锁定脸型、五官比例、眼睛、鼻子、嘴巴、肤色、发型和发际线。
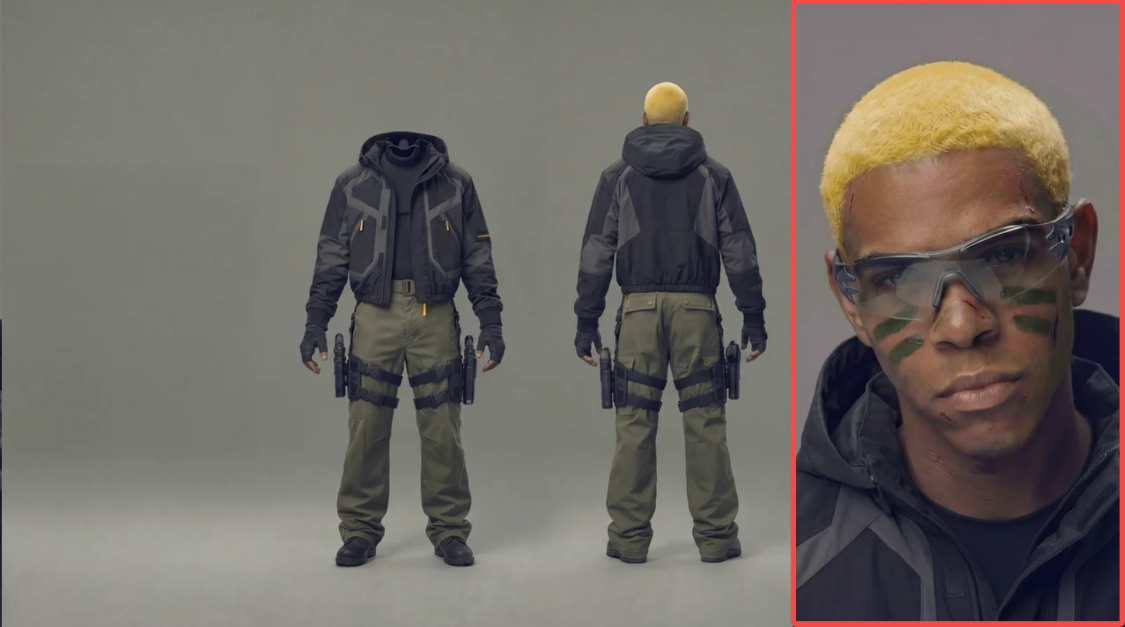
来源于higgsfield 人物参考图中的面部参考
第二部分负责人物身体和服装。
单独准备全身参考,重点控制身高、肩宽、腰身、四肢比例、服装轮廓、鞋子以及服装前后结构。
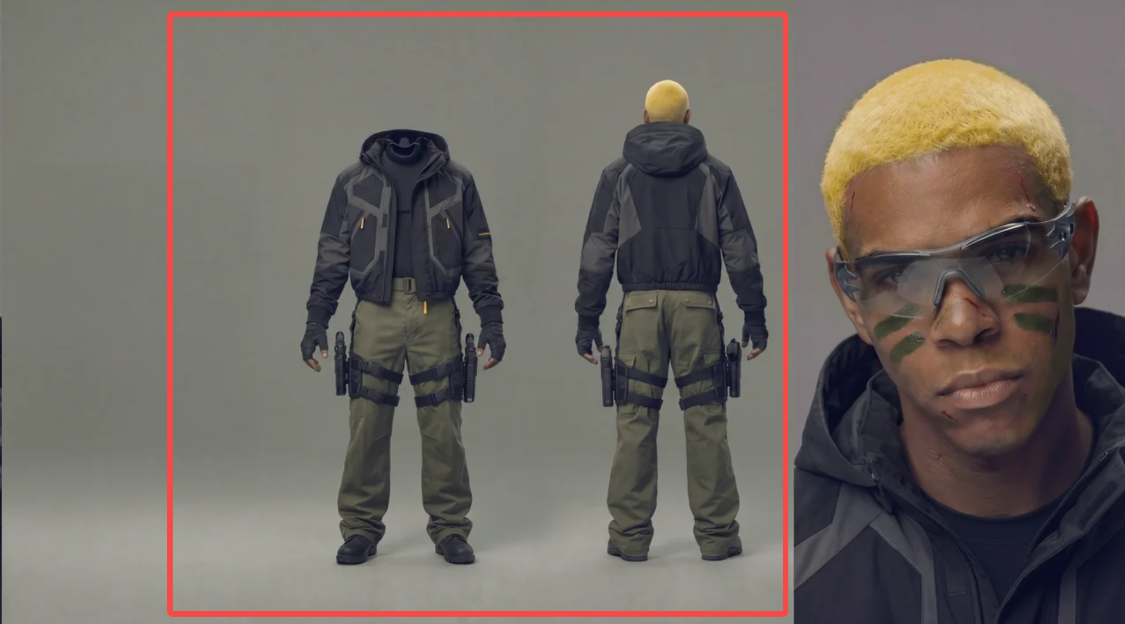
来源于higgsfield 人物参考图中的全身参考
一份参考素材只负责一个主要任务,AI反而更容易理解。
这也是做AI视频时非常重要的素材思路:
不是参考图越多越好,而是每一张参考图的职责越明确越好。
同一个人物,还要提前准备不同剧情状态
人物资产也不能只停留在“标准三视图”。
因为真正进入剧情以后,一个人物很少能够从头到尾保持完全相同的状态。
例如一场动作戏可能经历:
正常状态 → 衣服沾灰 → 面部受伤 → 衣服破损。
或者剧情中还会出现换装、淋雨、衰老、战斗、变身等变化。
如果每一次生成时才告诉AI:
“保持这个人物不变,但是现在让他受伤。”
模型就需要重新推导一次这个人物受伤以后应该是什么样子。
生成次数越多,随机性越高。
所以更稳妥的方法,是把重要剧情状态提前做成独立人物资产。
例如:
角色A|正常状态
标准发型、标准服装、面部干净。
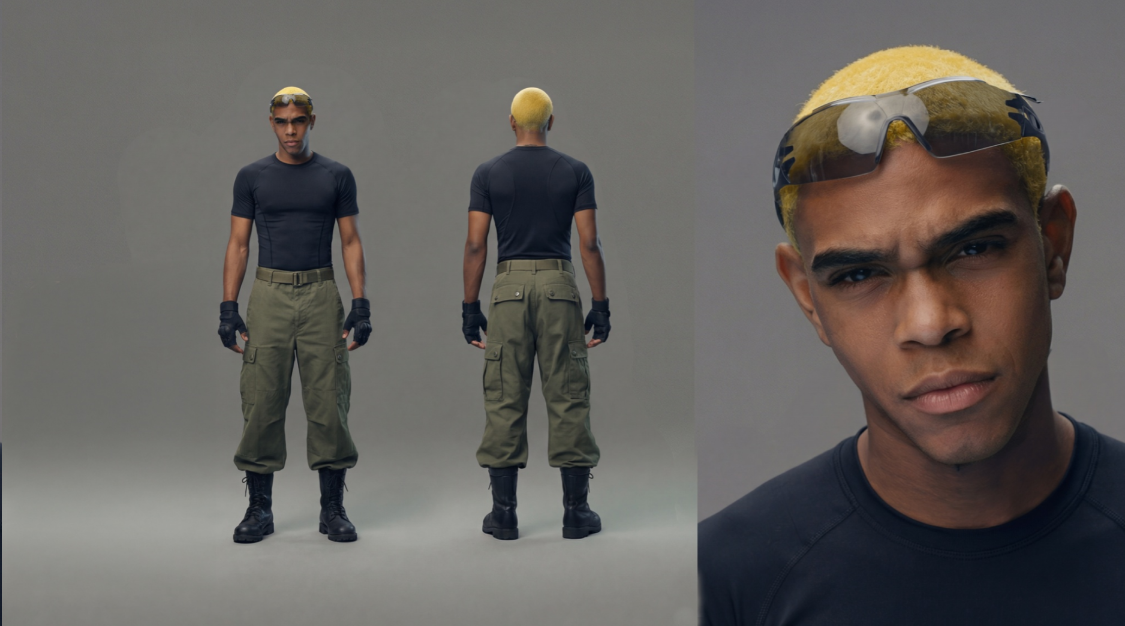
来源于higgsfield
角色A|重伤状态
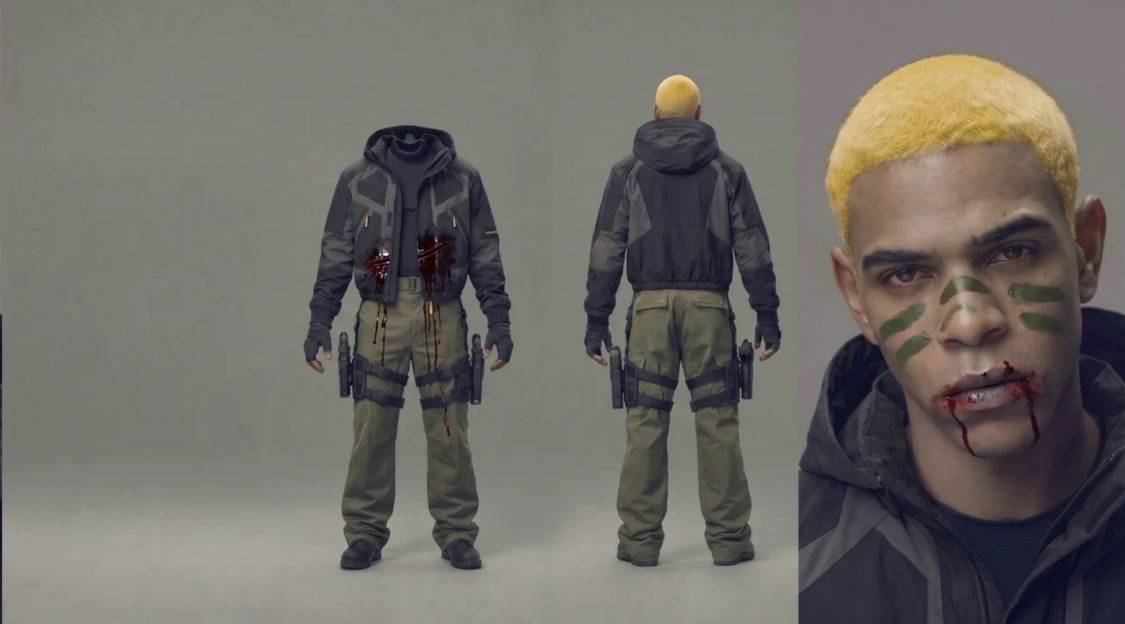
来源于higgsfield
角色A|换装状态
人物面部、发型和身体比例不变,只替换剧情中的服装。
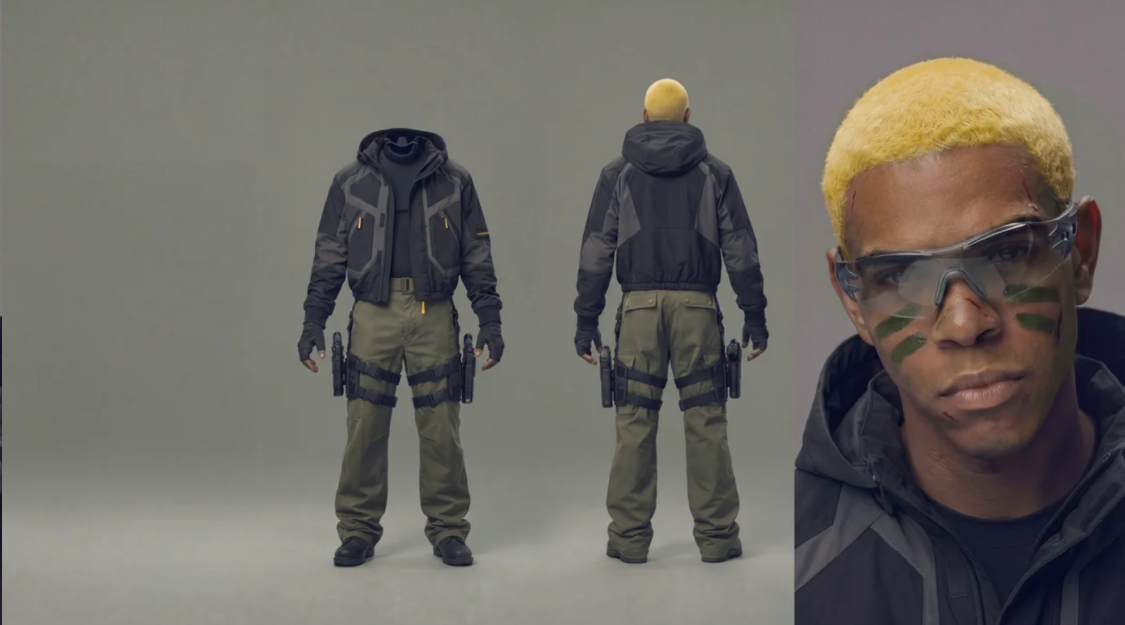
来源于higgsfield
之后生成具体镜头时,直接调用对应状态。
这样做,本质上是在把原本需要AI现场判断的问题,提前变成已经确定好的素材。
人物一致性的关键,不是把一个角色描述得越来越长,而是提前把这个角色拆得越来越清楚。
二、声音一致性:不要只固定音色,还要固定“怎么说话”
人物解决以后,第二个容易发生变化的是声音。
很多人现在做角色声音,会准备一段参考音频。
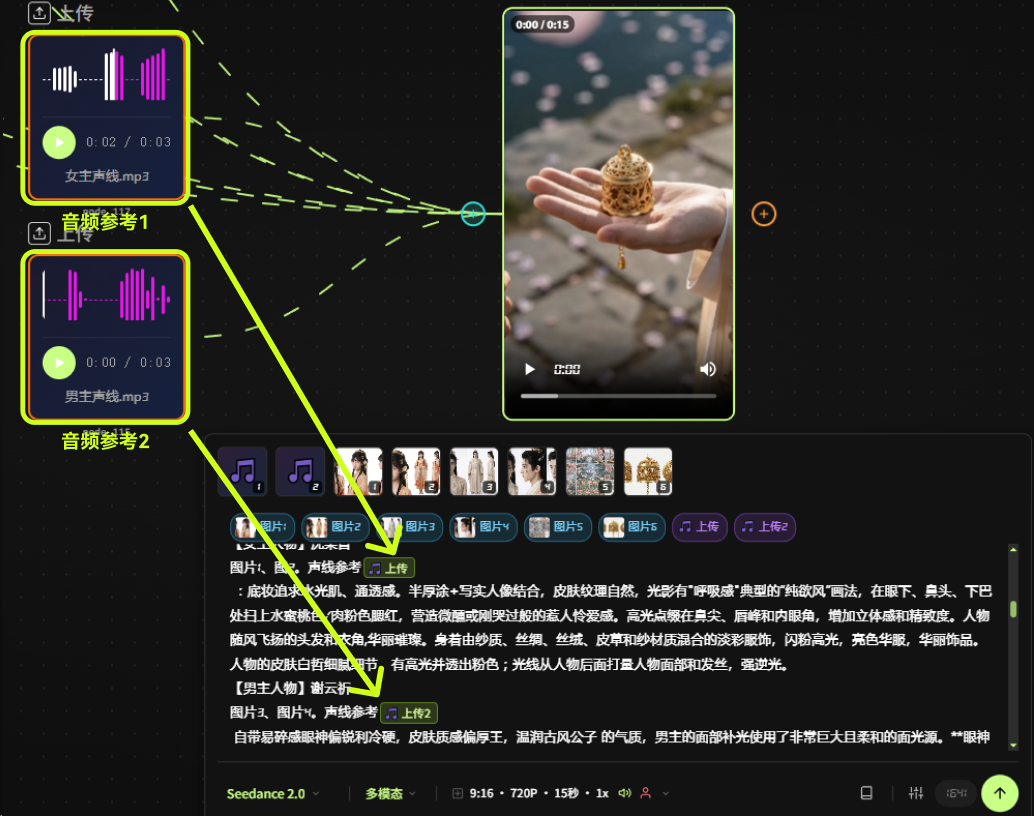
这种方法确实可以让不同镜头中的音色接近。
但如果制作的是连续剧情,你会慢慢发现:
同一个人物虽然听起来还是那个声音,说话方式却可能完全不同。
原因就在于:
音色只是声音一致性的一部分。
一个真正完整的角色声音,至少还应该包含:
音高、语速、停顿习惯、情绪变化、说话力度、口音以及语言习惯。
因此制作重要角色时,可以在参考声音之外,再固定一段文字版声音说明。
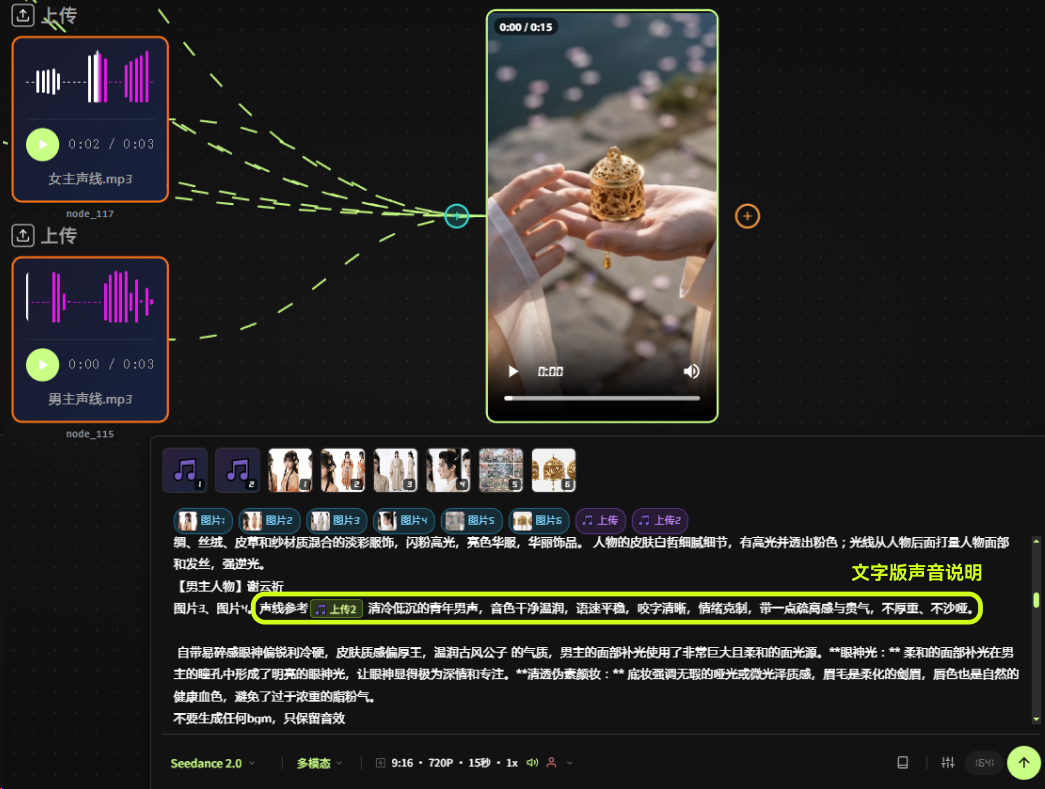
例如:
清冷低沉的青年男声,音色干净温润,语速平稳,咬字清晰,情绪克制,带一点疏离感与贵气,不厚重、不沙哑。
复制
注意,这里没有描述一句具体台词。
描述的是:
这个人物平时是怎么说话的。
以后无论人物说什么台词,都可以继续调用这一套声音设定。
声音资产还需要提前测试
写完声音设定以后,不建议马上开始生成整部视频。
可以先准备几句不同类型的测试台词。
三、场景一致性:先让AI看懂空间,再安排人物怎么演
场景一致性的问题,和人物其实非常相似。
很多人做场景设定图时,第一个要求通常是:
“我要一个很好看的电影场景。”
但对于AI视频来说,一张很好看的图,不一定是一张很好用的场景参考。
因为场景参考还有一个非常重要的任务:
告诉AI这个空间到底是什么结构。
例如同样是一个客厅。
如果完全正面拍摄,画面可能非常工整,但是AI只能看到一面墙。
左边有什么、右边有什么、沙发前后距离是多少,都不明确。
如果使用略微侧面的 3/4角度,情况就会完全不同。
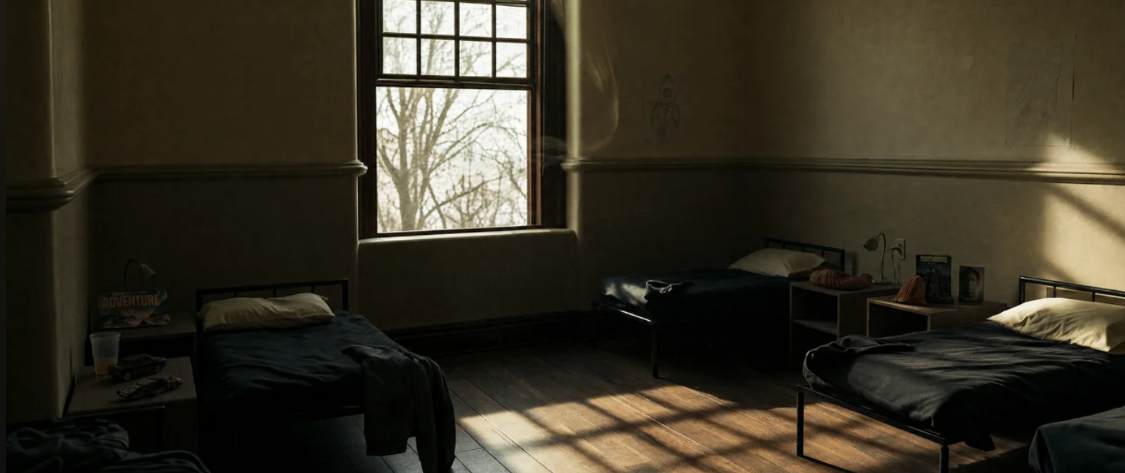
画面可能同时看到:
左侧窗户,床位。右侧俩个床位。
空间的纵深和物体之间的位置关系都会更加明显。
AI也就更容易判断人物应该站在哪里。
所以做场景参考图时,不要只考虑:
这一张好不好看。
还要考虑:
这一张能不能让AI看懂整个空间。
场景复杂时,给AI设置一个固定参照物
除了场景角度以外,还有一个非常好用的方法:
在场景里找一个明显的固定物体。
例如:
一根柱子。
一张黄色沙发。
一盏落地灯。
一张长桌。
一棵大树。
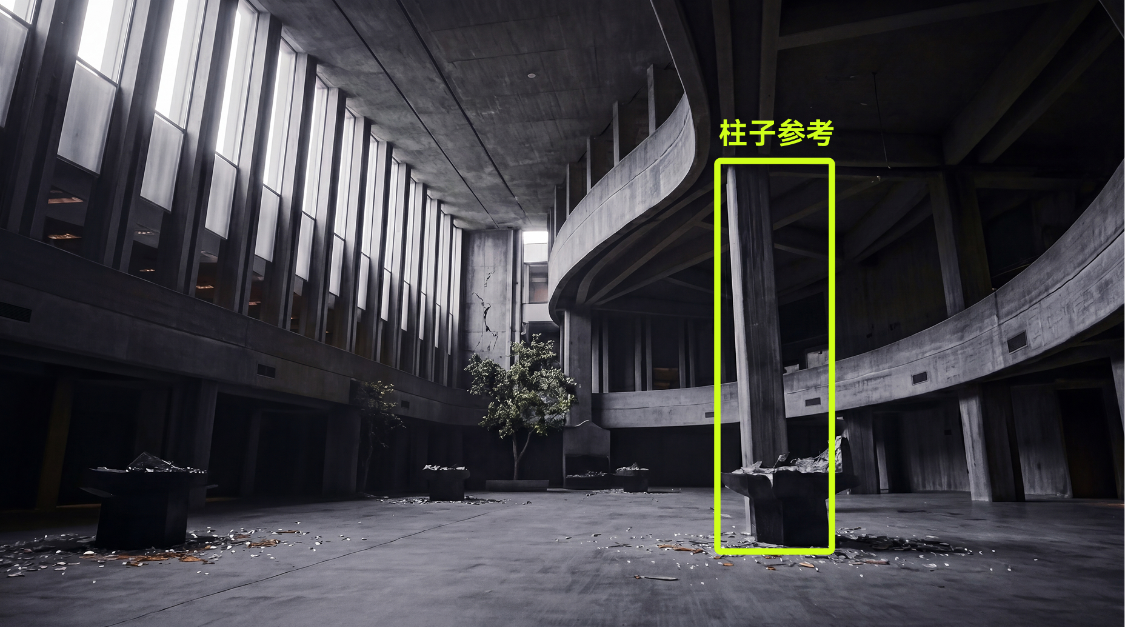
之后写人物位置时,不要一直使用“左边、右边、房间中央”这种比较抽象的说法。
假设房间里有一张黄色沙发。
第一镜可以写:
人物站在黄色沙发左侧约一步的位置。
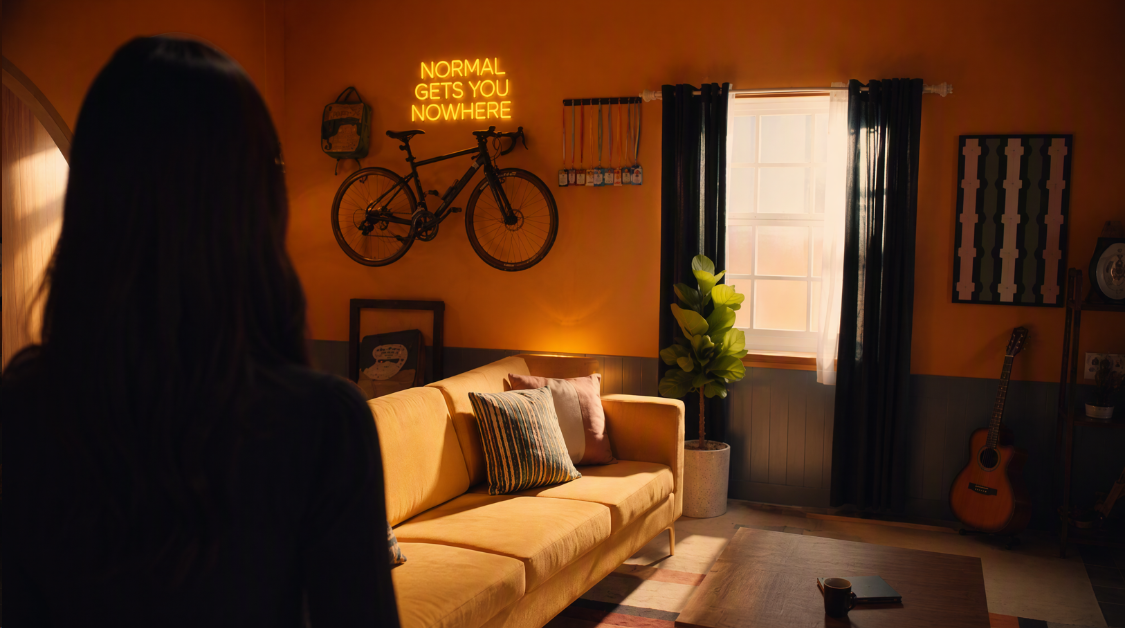
下一镜:
人物从黄色沙发左侧向右移动,从沙发前方经过。
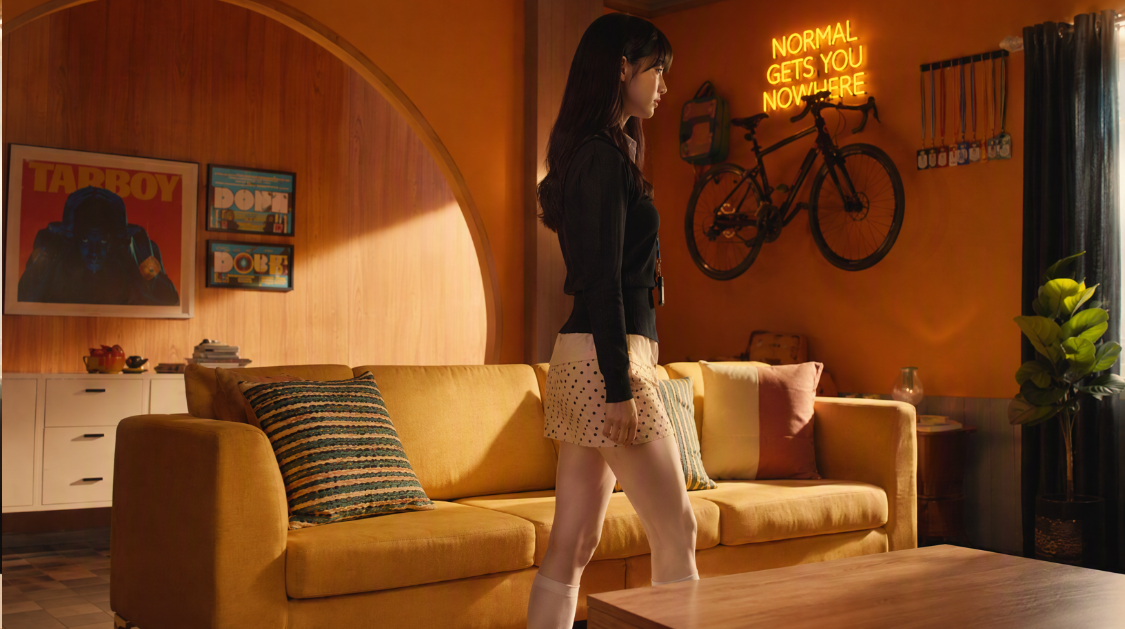
再下一镜:
人物停在黄色沙发右侧,转身面对另一名角色。
这样三个镜头都围绕同一个固定参照物展开。
这张沙发实际上就变成了这个场景里的一个“坐标”。
AI不需要每次重新判断人物到底在哪里。
多人场景,再增加一张“空间地图”
当一个场景里只有一个人物时,其实没有必要写得特别复杂。
但如果同时出现三四个人,只写:
“几个人站在房间中交谈。”
站位就很容易发生变化。
这时候可以先在提示词最前面写一段简单的空间说明。
例如:
画面中央偏后是一扇通向室外的大面积玻璃门,左右两侧是橙棕色窗帘;右侧区域是一组黄色L形沙发,沙发前方摆放圆形茶几,右后方是一整面木质百叶窗;左侧是单人椅和矮柜,前景还摆放着坐垫和小凳。
复制
这就是最简单的文字版空间地图。
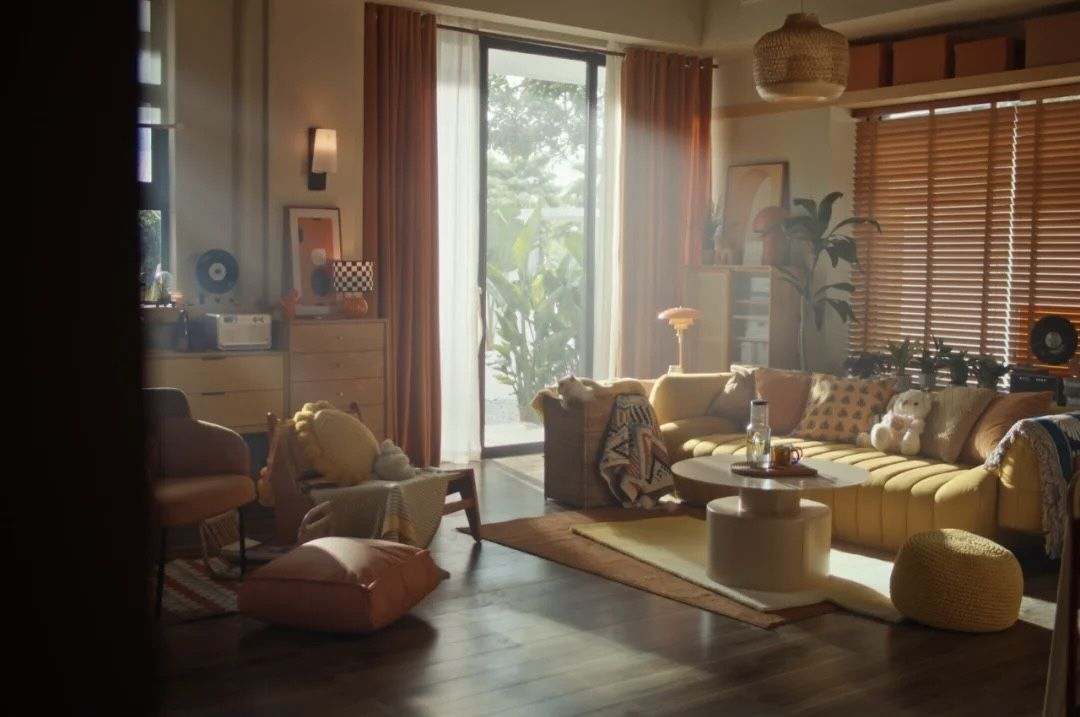
确定完位置以后,再写具体镜头:
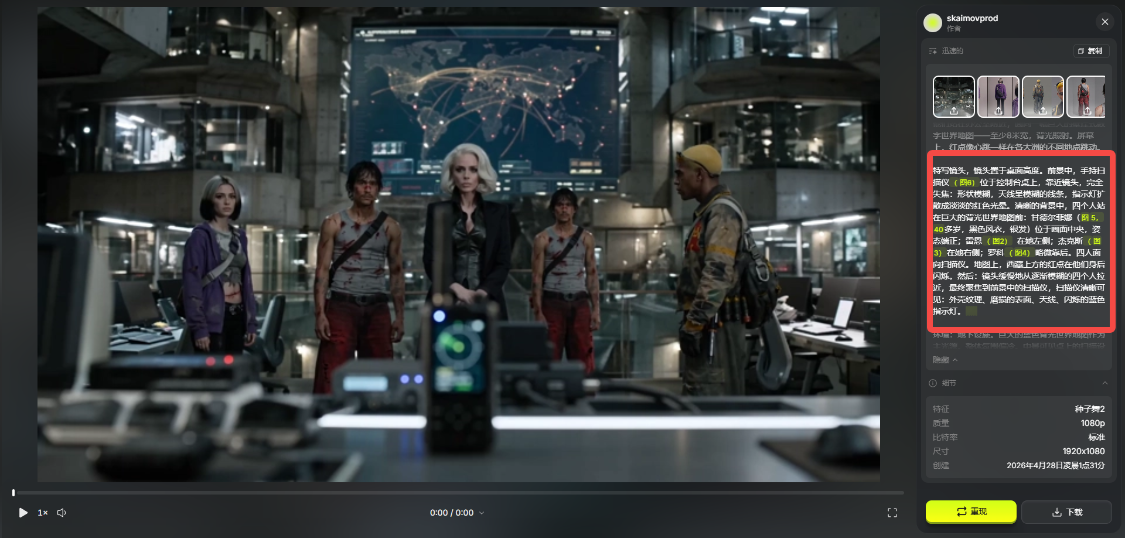
higgsfield的提示词
角色A站在黄色沙发左侧,靠近玻璃门的位置;角色B坐在黄色沙发右侧;角色C站在左侧单人椅附近。圆形茶几始终位于沙发前方,作为整个客厅中央的固定参照物。
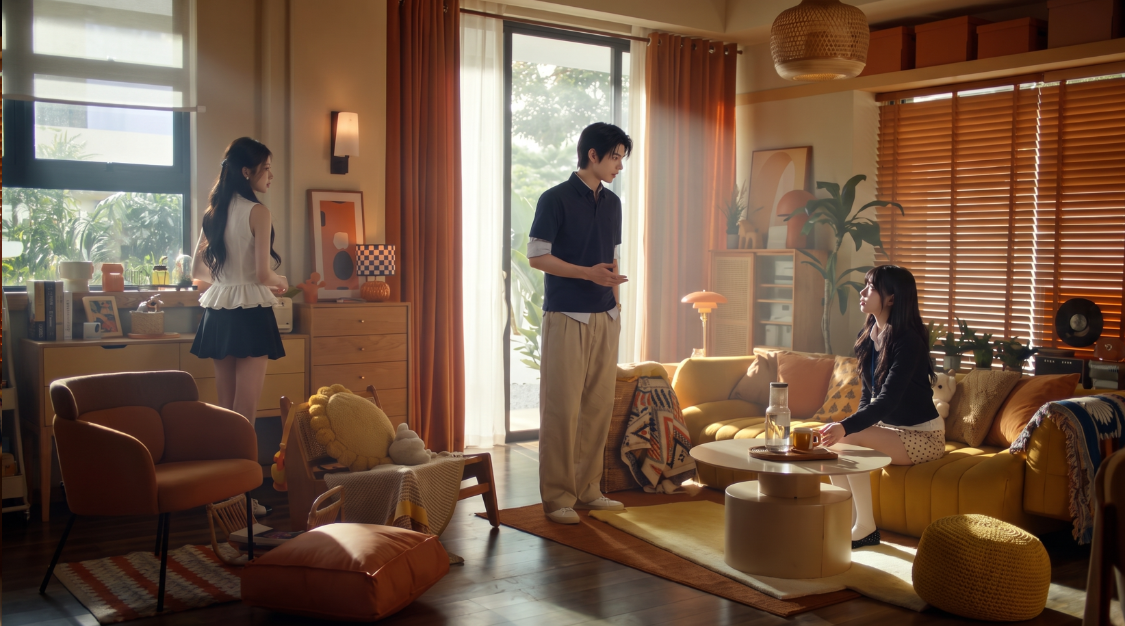
人物就不会再漂浮在一个抽象空间里。
如果人数更多,还可以在正式进入近景以前,先给一个很短的全景。
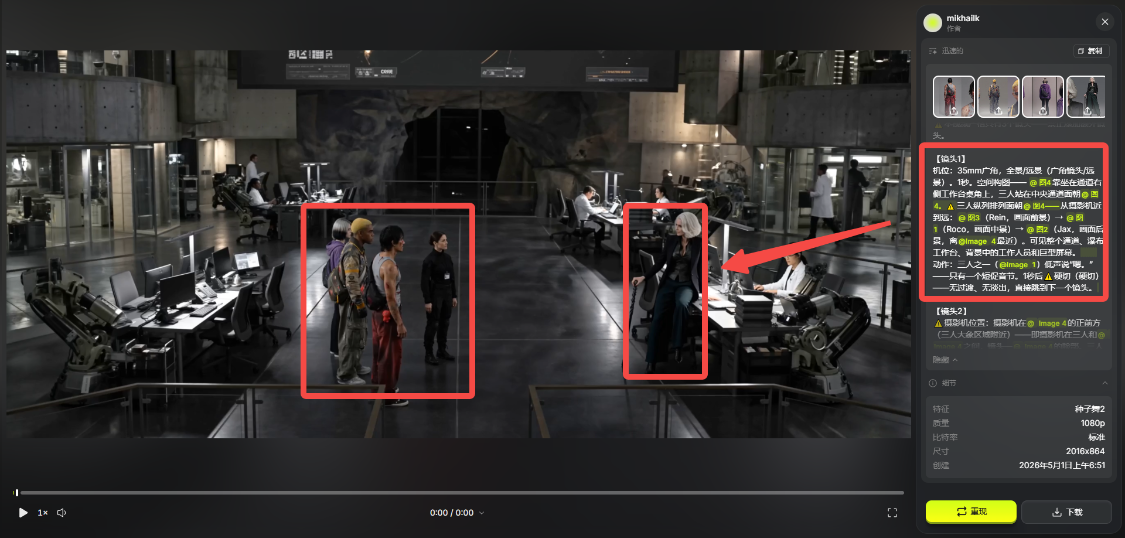
不用很长,一秒左右就可以。
先让观众和AI都看到:
谁在左边。谁在右边。谁坐着。谁站着。
然后再进入近景、中景和过肩镜头。
这样后面的空间关系会稳定很多。
所以场景一致性可以记住一个非常简单的顺序:
先建立空间 → 找固定参照物 → 确定人物站位 → 最后再设计镜头。
四、提示词怎么写:少用抽象形容词,多写可以被看见的关系
人物、声音和场景都准备完成以后,最后才真正进入提示词。
而这里最容易犯的错误,就是认为:
提示词越长、形容词越多,效果就越好。
例如想表现一个巨大的怪物,很多人会写:
“一个极其巨大、非常高大、拥有强烈压迫感、震撼、宏伟的怪物。”
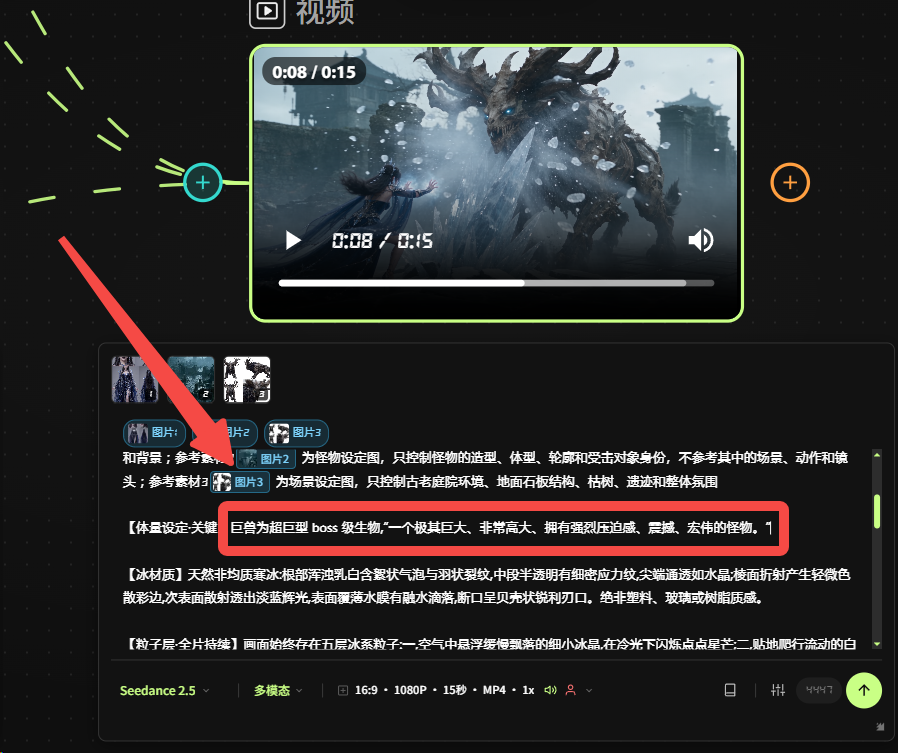
看起来描述很多。
但真正能告诉AI怪物有多大的信息,其实只有一个:
很大。
问题是,“很大”究竟是多少?
AI并不知道。
所以相比抽象形容词,模型往往更容易理解具体关系。
例如可以改成:
女主站立时头顶仅到它爪子大小,怪物单只脚掌的宽度接近人物身高。
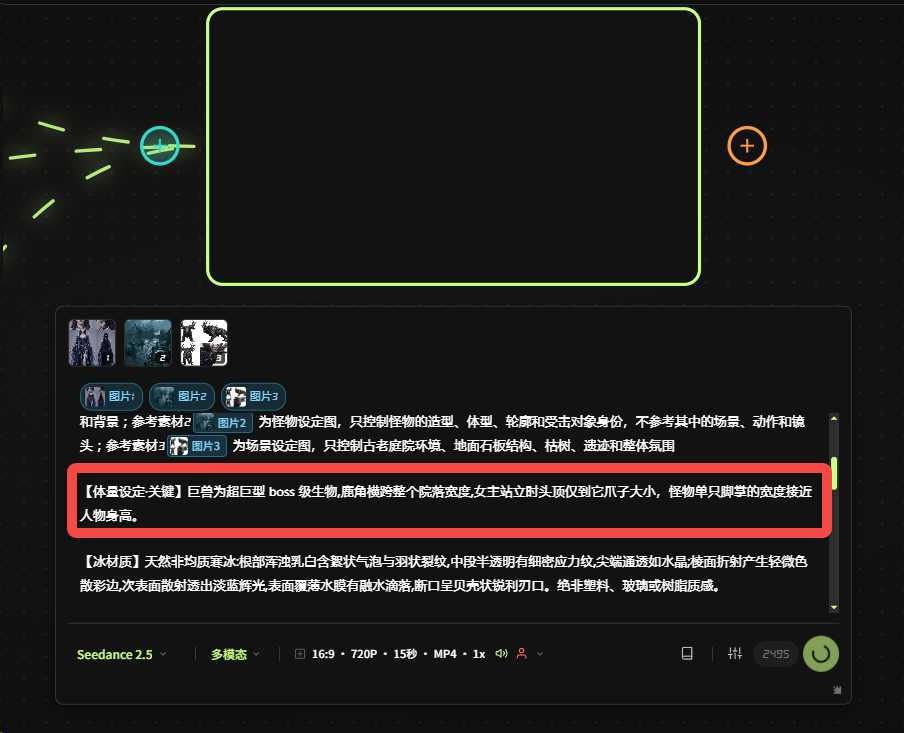
这时我们没有一直强调“巨大”。
但观众一定能感受到巨大。
因为画面里出现了清楚的比例关系。
这个方法还可以用在很多地方。
不要只写:
两个人距离很远。
可以写:
两个人之间相隔一张长餐桌的距离。
不要只写:
门很窄。
可以写:
人物必须侧身才能通过,肩膀几乎贴近两侧门框。
不要只写:
人物非常疲惫。
可以写:
人物停下后双手撑住膝盖,上半身明显前倾,连续快速呼吸,抬头时动作缓慢。
AI更容易理解的是:
可以直接画出来的东西。
“真实感”也是一样
很多提示词为了增加真实感,会不断增加:
真实。超真实。电影级。照片级。写实质感。
这些词当然有作用,但真正决定一个物体是否看起来真实的,往往是它有没有遵守现实中的物理规律。
例如我们需要人物身上出现黏液。
普通写法:
人物身上覆盖着非常真实的黏液。
模型知道要有黏液。
但这个黏液可能就像一层塑料贴在人物身上。
如果换成:
半透明黏液附着在人物脸颊和脖颈表面,液体受到重力影响缓慢向下流动,较大的液滴沿下巴边缘聚集后滴落。部分黏液接触衣领,在布料表面留下颜色更深的湿润痕迹。人物转头时,表面的细小液丝因为惯性短暂拉伸,随后断开。
这里真正产生真实感的是:
重力、重量、接触、惯性、形变和结果。
动作也是一样。
不要只写:
人物快速奔跑,然后突然停下。
可以写:
人物快速向前奔跑,发现前方异常后立即刹住脚步。身体因为惯性继续向前倾,右脚向前跨出半步支撑重心,外套下摆继续向前摆动,随后逐渐落下。
整个动作仍然只是:
跑 → 停。
但因为加入了动作产生的身体反馈,生成出来就会自然很多。
所以以后写AI视频提示词,可以尽量从这个顺序思考:
发生了什么 → 为什么发生 → 影响了什么 → 产生什么反馈 → 最后停留在什么状态。
这比单纯堆大量“电影感、真实感、震撼、高级”的词更有效。
总结:真正需要建立的不是万能提示词,而是一套生成系统
做到这里,其实会发现人物、声音、场景和提示词看起来是四个问题,本质上解决的是同一件事情:
减少AI需要自己猜测的信息。
人物资产提前告诉AI角色是谁。
声音资产提前告诉AI角色怎么说话。
场景资产提前告诉AI人物在哪里。
最后的提示词,只需要告诉AI:
这一镜具体发生什么
所以真正比较稳定的AI视频工作流,并不是每生成一个镜头,都从零开始重新写一遍提示词。
而是先把能够复用的信息全部固定下来。
人物拆清楚。
声音定下来。
场景关系确定。
最后再用具体的动作、比例关系和物理反馈控制镜头。
项目越长,这种方法的优势越明显。
因为真正决定长视频稳定性的,从来不只是某一条提示词写得有多好。
而是你有没有在点击生成之前,把AI原本需要猜的东西,提前替它决定好。
真正万能的不是某条提示词,而是一套可以不断复用的工作流。