



Higgsfield的AI电影《Anerneq》中,女子推起雪镜露出眼睛,双手护住刚出现的火星,追上父亲并拉住他。短短几个动作,却包含了人物状态、道具互动、情绪变化、镜头节奏与环境氛围等多层信息。正是这些具体而连贯的画面,为AI视频创作中的提示词设计提供了很好的案例。
在实际创作中,人物不只是“站在那里”,道具也不只是画面中的装饰。推起雪镜、护住火星、追赶并拉住父亲,每一个动作都对应着明确的身体姿态、行为目的和情绪表达。如果提示词只描述人物外貌,往往难以生成具有叙事感和连续性的画面;而将动作、关系、环境与镜头语言结合起来,才能让角色真正参与到故事之中。
本节将结合影片片段和展示的制作参考,拆解人物、道具与表演相关的提示词写法,讲清每种方法主要解决什么问题、适合在什么场景下使用,以及怎样将这些方法迁移到自己的创作中。无论是设计一个具有辨识度的角色,还是让角色完成自然可信的动作,都可以从这些具体案例中找到可复用的思路。
一、《Anerneq》的真实感,具体来自哪里
Higgsfield的AI电影《Anerneq》,把人物放进了一个寒冷的极地世界:毛皮衣服、积雪、木制雪镜、取火工具,以及被冷暖光照亮的脸。这些元素提供了观察真实感的具体对象。
在一组人物近景中,女子先戴着遮住眼睛的木制雪镜,随后抬手,把雪镜推到额头。毛皮袖子短暂挡住脸,眼睛重新露出,嘴形和眉眼随着说话变化。观众看到的是一个人在完成动作,衣物、遮挡和表情始终联系在一起。
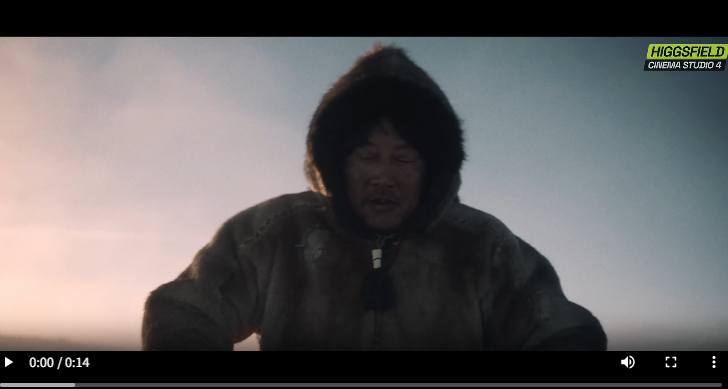
影片中的片段
另一组取火镜头,则从处理材料、放置工具,推进到摩擦、出现火星、护住引火物,最后切到女子看向火光的脸。画面让观众理解了动作过程,也让人物反应有了原因。
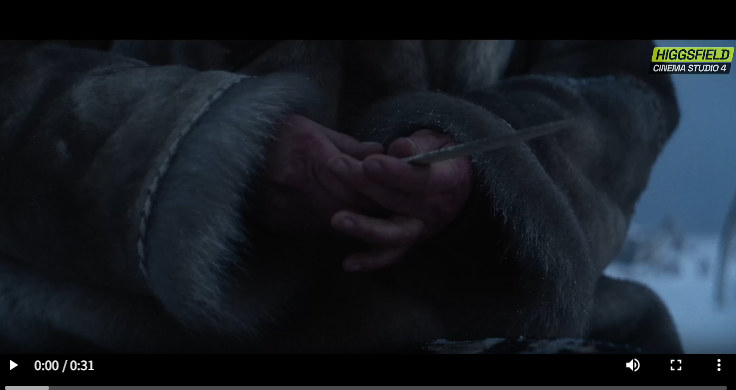
影片中的片段
这节课就从这些片段和展示的制作参考出发,学习怎样准备素材、组织镜头、描写表演。文中的提示词是围绕案例整理的练习写法,你可以把人物和环境换成自己的故事。
二、人物资产:把脸部身份与服装结构分别讲清
《Anerneq》的人物参考板很适合学习:
这张图可以固定成一个版式:上半张是完整的脸部特写,下半张并排放置不含头部的正面、背面身体图。上下各占50%
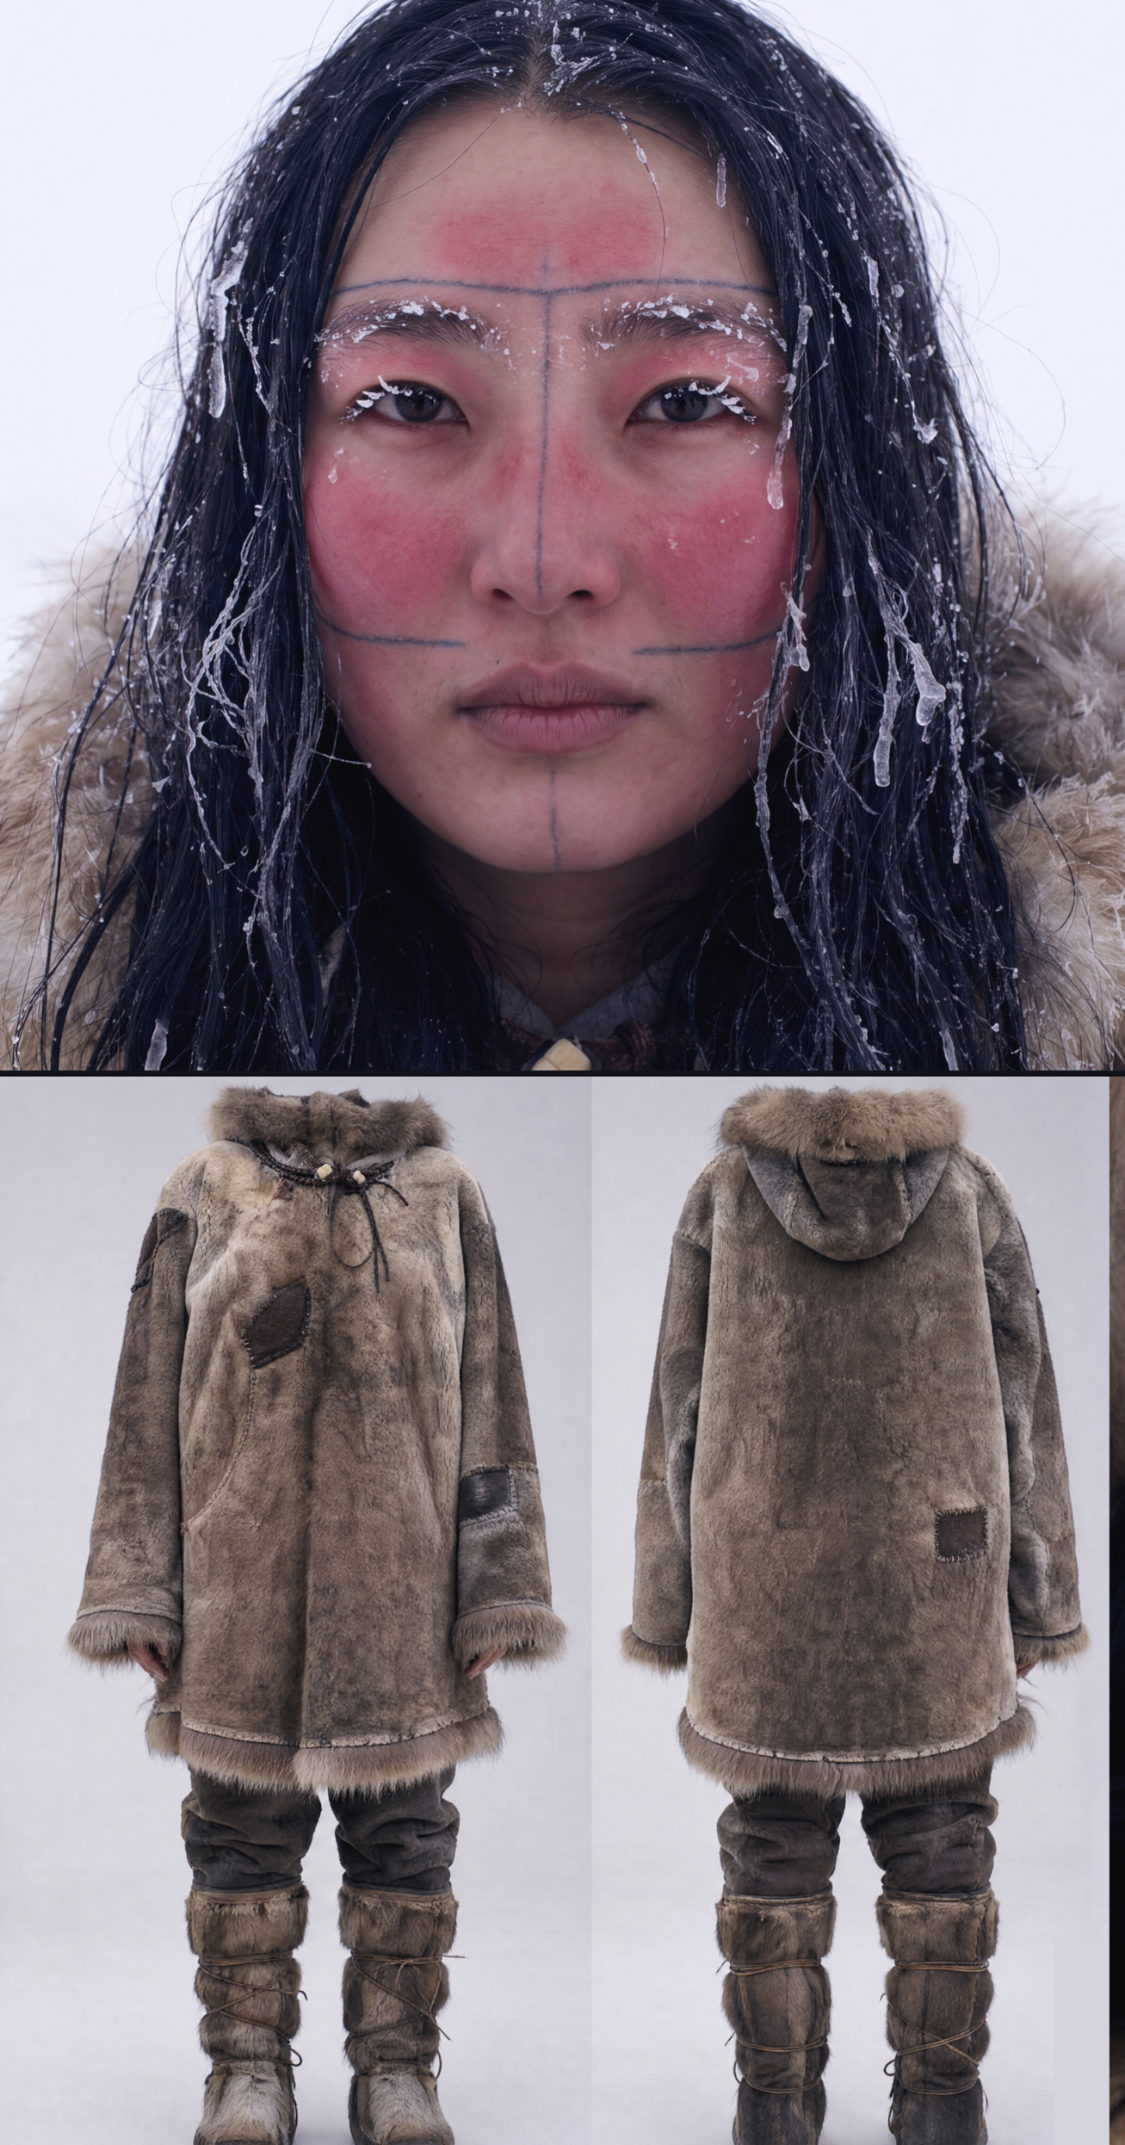
它的作用很直接:拍近景时有清楚的脸部参考,
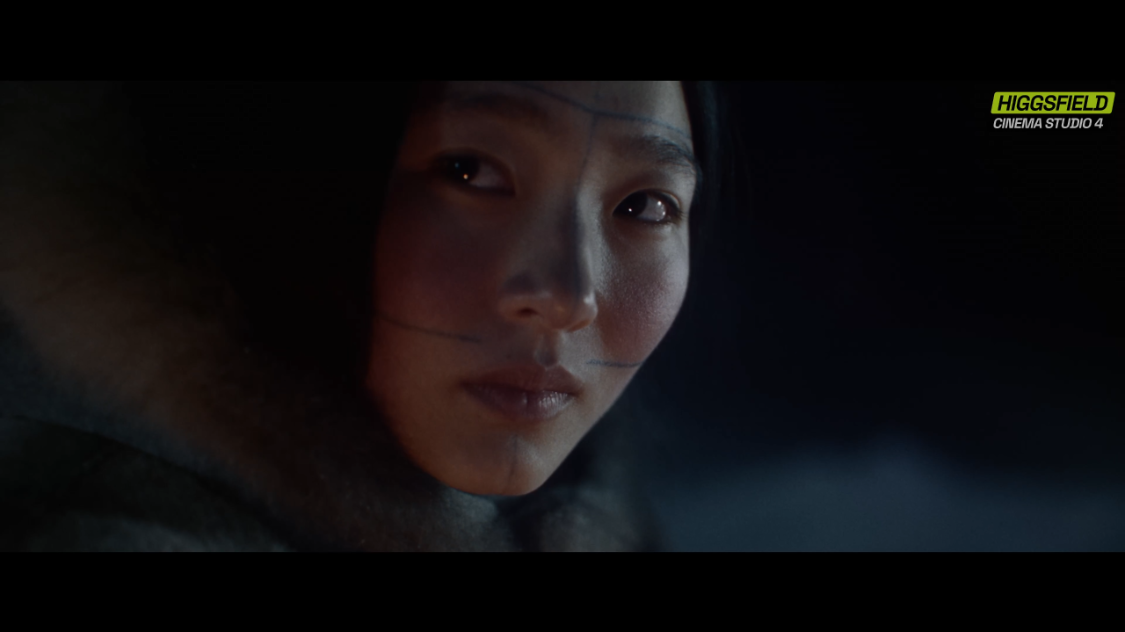
拍较远镜头或转身时,有身体和服装参考,有助于减少换镜头后变脸、换衣服的问题。
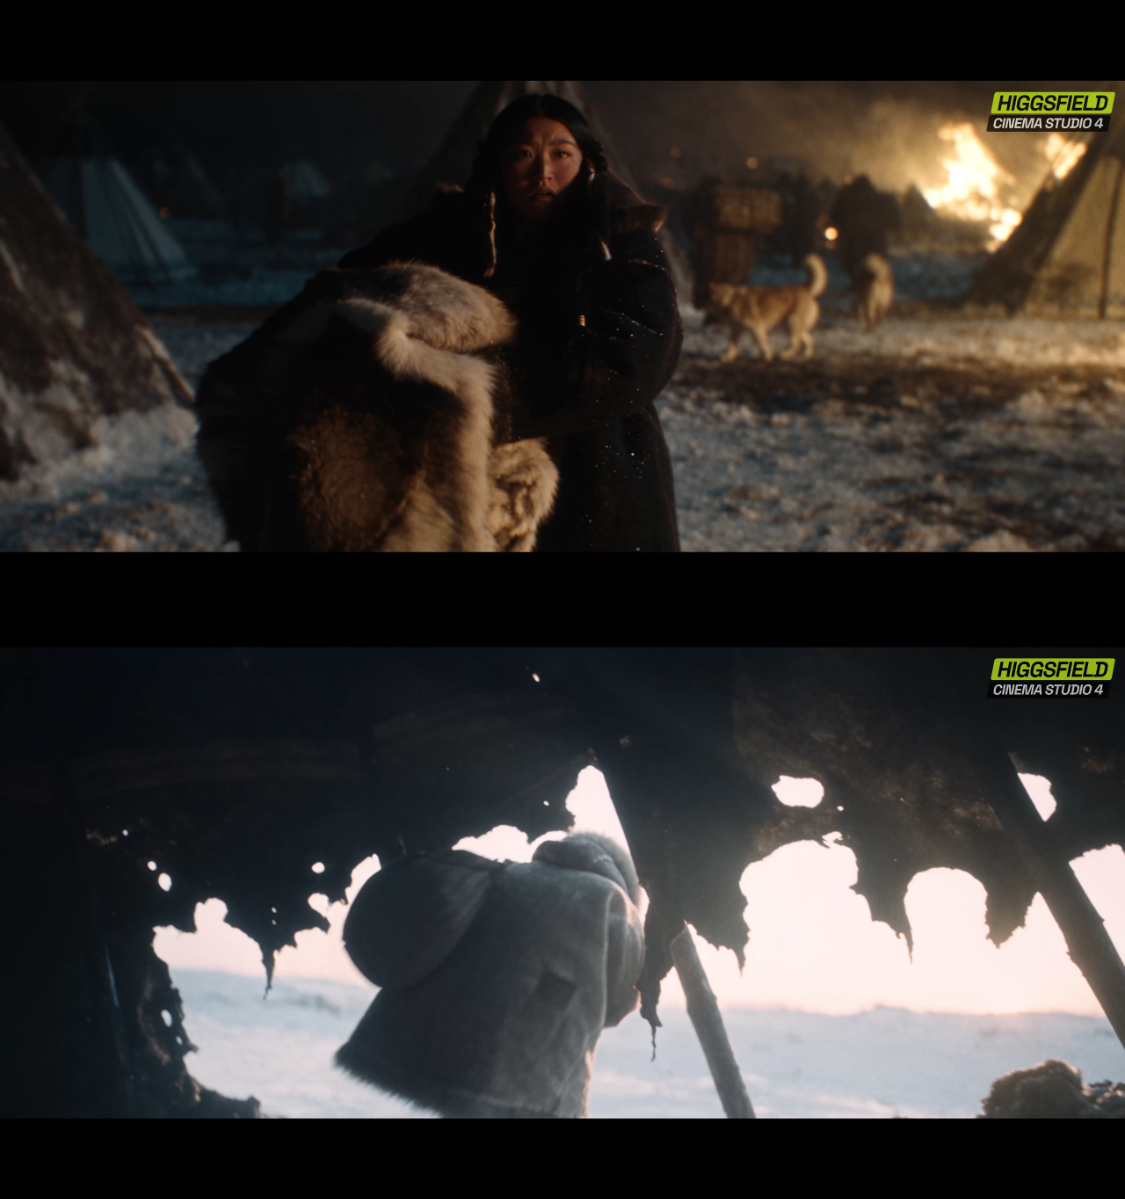
影片画面截图
制作时,上传一张人物全身图,使用固定提示词模板生成。检查上方是不是同一张脸,下方的服装、体型和鞋子是否对应;确认后,再把它用于后面的图片和视频生成。
我这里用我自己的角色进行演示。
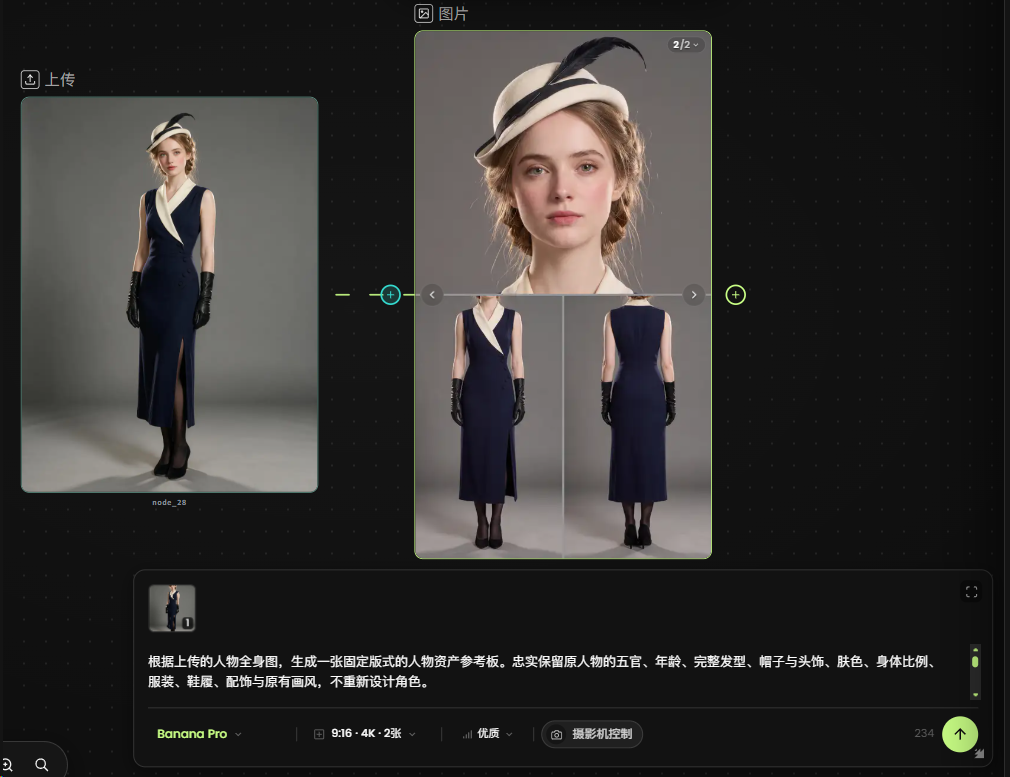
使用banana pro生成
提示词模板如下:
根据上传的人物全身图,生成一张固定版式的人物资产参考板。忠实保留原人物的五官、年龄、完整发型、帽子与头饰、肤色、身体比例、服装、鞋履、配饰与原有画风,不重新设计角色。
【严格限定画布与占比】
画布为竖版,宽高比1:2。
上半区与下半区的面积比例严格为1:1: 上半区占整张画布高度的50%,只放一张包含完整发型、帽子与头饰的正面头部特写。 下半区占整张画布高度的50%,并排放置正面、背面身体视图。
水平分界线必须位于画布高度的正中间,即50%位置,不允许上下区域大小发生变化。
下半区再左右等分:
左下正面身体图占整张画布面积的25%。 右下背面身体图占整张画布面积的25%。
最终严格只有三个视图:上方完整头部特写、左下正面身体、右下背面身体。
使用细直线分隔:一条位于画布高度50%处的水平线,以及一条仅位于下半区中央的竖直线。竖直线不得延伸至上半区。不增加其他图片,不设置宽边框或宽间隔。
【上半区:完整头部尽量放大的正面特写】
人物正对镜头,头部端正,目光平视,表情自然放松。
上半区展示的是“包含完整发型、帽子与头饰的头部特写”,不是只截取五官的局部面部特写,也不是普通半身照。
取景范围必须包含:
头发、帽子或头饰的最高点;
左右两侧完整的头部外轮廓、发型外轮廓,以及帽檐或头饰的最外缘;
完整的额头区域、眉眼、鼻子、嘴唇、双颊与下巴。
额头、耳朵等部位如果原本被头发或帽子自然遮挡,保持原样,不强行露出。
人物戴帽子时,完整展示帽顶、帽檐及原有装饰;不戴帽子时,完整展示头顶发型、发量与发型轮廓。不得新增、摘除或缩小帽子,不得压扁头发,不得改变佩戴位置来迁就构图。
【头部放大与防裁切规则】
将头部、发型、帽子和头饰作为一个完整主体,按原始比例整体缩放。在所有外轮廓都完整进入上半区的前提下,将这个主体尽可能放大。
放大至主体最高点、最外侧或最低点中的某一边接近分区边缘时停止,并保留少量清晰可见的安全留白。完整主体不得接触、穿过或被分区边缘裁切。
完整性优先于面部铺满:
如果帽子较高、帽檐较宽、发型蓬松或头饰突出,应适当拉远取景以完整容纳,不得继续放大脸部而切掉帽子、头顶或发型。 不再要求“额头至下巴占满上半区高度”,不要求脸颊贴住左右边缘。
保留原人物自然的头脸比例,不拉宽脸部,不拉长头部,不缩小帽子,不压缩发型,不通过局部变形填满画面。
头部整体居中,减少无意义的背景留白。不要为了保留完整头部而退成远景、普通半身照或胸像。
下巴下方仅保留必要的少量颈部。若长发、辫子或垂坠头饰延伸至下巴以下,应完整展示其自然轮廓,可按需要保留少量颈肩区域,但不得让胸部或大面积躯干占据上半区。不得截短长发或改变发型。
【面部与毛发细节】
准确保留参考人物的脸型、五官比例、年龄、肤色、发际线与原有面部特征,不美化换脸,不改变年龄,不增加新的纹样或装饰。
在完整头部构图内提高面部细节的清晰度,不通过进一步裁切头顶、帽子或下巴来表现细节。
对于写实人物,呈现自然的人像摄影质感:
鼻头、鼻翼与脸颊保留细小、疏密自然的毛孔;眼周、额头及唇部保留符合年龄的微细纹理。肤色有细微自然变化,皮肤反光柔和,不过度磨皮,不呈现蜡像或塑料质感。
毛孔应随面部区域自然变化,不均匀铺满全脸,不夸张成粗大孔洞,不用噪点或过度锐化冒充真实细节。
眉毛与睫毛具有自然生长方向、长短和疏密变化;面部汗毛细微克制,不凭空增加胡须。
头发兼具整体发束结构与局部独立发丝,发际线过渡自然,保留少量符合原发型的碎发。不要将头发画成实心块、塑料片或同样粗硬的线条。
帽子与头饰忠实表现原有材质、结构、接缝及装饰,不擅自添加细节。
所有细节与参考图的原有画风协调。非写实参考不强行叠加摄影皮肤纹理,不改变角色的视觉风格。
【下半区:占整张图50%的身体正背面】
左侧为同一人物的正面身体,右侧为同一人物转身180度后的背面身体。
两个身体视图都省略头部,仅展示肩部、领口至鞋底。领口与肩部结构自然完整,下半区不出现脸、头发或头模,不出现血腥断面。帽子及头部佩戴物统一在上半区展示,不在下半区另行悬空摆放。
人物自然直立,双臂略微离开躯干,双手放松,双腿自然站立。完整展示服装、手部、裤装或裙装及鞋履,不裁切肩部、手指或鞋底。
正背面身体各自占下半区高度的90%左右。两者采用相同展示比例,肩线、腰线、膝部和鞋底高度对应,鞋底位于同一水平线上。保持自然身体比例,不拉长、不压缩。
正背面分别居中放置在各自区域内,不跨越分隔线,不互相遮挡。
正背面保持完全一致的服装款式、颜色、材质、长度、拼接和配饰。原图未展示的背面结构,根据可见服装合理延续,不擅自增加图案、文字、背包或其他装饰。
【固定灰底与三点式打光】
三个视图统一使用干净的中性灰色摄影棚背景,无场景、无纹理、无明显渐变。
统一采用柔和的三点式打光:
主光位于人物左前方约45度、略高于眼睛的位置,塑造面部与服装体积。
辅光位于人物右前方,亮度低于主光,柔和补足阴影,保留细节。
轮廓光位于人物后上方,轻微勾勒帽子、头发、肩部和衣服边缘,使主体与灰色背景分离。
帽檐下的面部保持自然阴影,同时保留眉眼与皮肤细节,不为照亮脸部而移除帽子、抬高帽檐或改变佩戴方式。
三个视图保持一致的光色与曝光,不使用彩色灯光,不出现强烈过曝或大片死黑阴影,保留原图的画风与材质质感。
【必须遵守】
1. 画布宽高比严格为1:2,上下区域严格各占50%,不得改变固定版式。
2. 上方只有一张正面完整头部特写,完整保留发型、帽子、头饰与下巴。
3. 以完整头部及其佩戴物的整体外轮廓作为缩放依据,在不裁切的前提下尽可能放大。
4. 严禁切掉帽顶、帽檐、头饰、头顶发型或下巴;严禁只展示“下巴到额头中部”的局部脸。
5. 面部大小必须服从完整头部的容纳需求,不以裁切、挤压或改变发型和帽子尺寸来放大面部。
6. 上方保持近距离头部展示,不退成普通半身照,不出现大面积胸部或躯干。
7. 下方只有不含头部的正面、背面身体图,肩部、服装、手部和鞋履完整。
8. 上方头部与下方身体使用各自独立的展示比例;下方正背面身体之间比例一致。
9. 不添加侧面视图、额外人物、局部放大框、文字、编号、标题、水印或装饰。
三、场景资产:先理解雪地,再决定怎样拍它
从Higgsfield《Anerneq》的制作案例中,可以借鉴一个做法:准备场景参考图时,先把场景本身生成清楚,不急着添加背景虚化、镜头畸变和胶片颗粒。
具体可以分两步。
第一步,生成干净的场景参考图。
比如制作雪地场景,先让地形、积雪和远处环境清楚可见,保留自然的光影与材质,不提前叠加明显的镜头效果。
这里的“干净”,是方便看清场景,不是把画面做得没有细节。
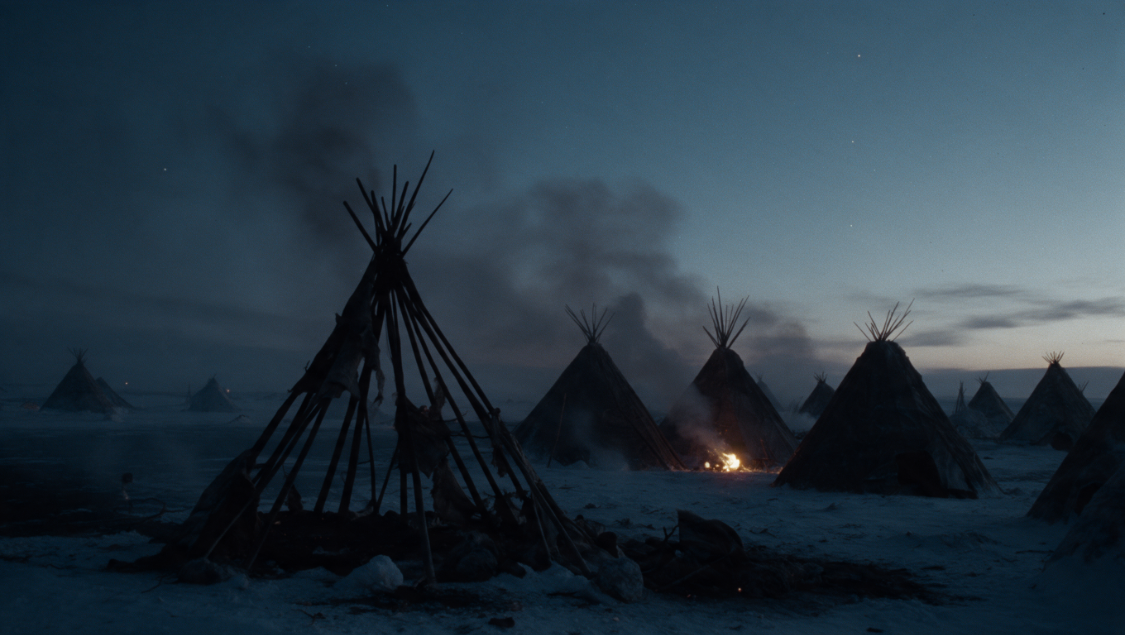
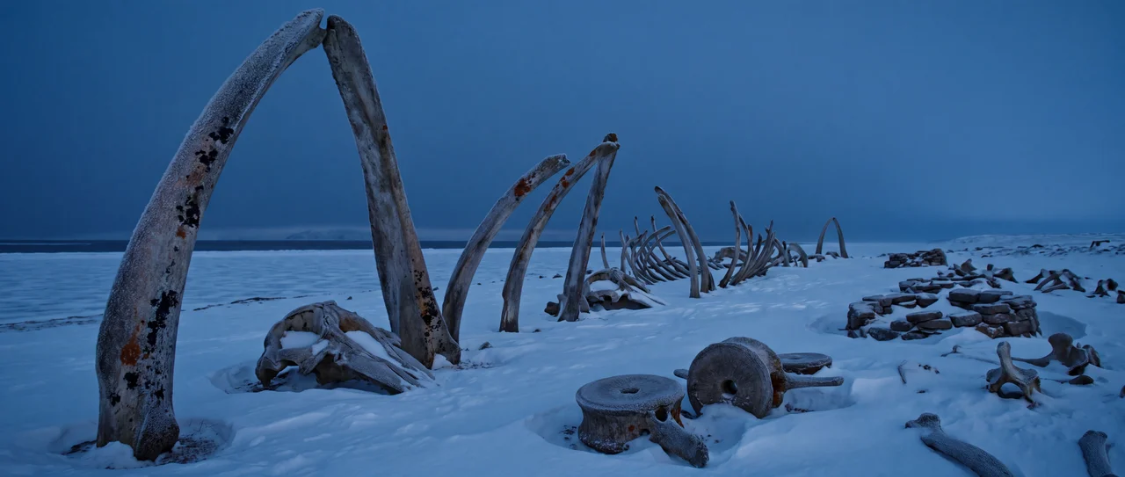
第二步,生成视频时,再用提示词控制镜头效果。
人物、动作和场景确定后,根据镜头需要,在视频提示词中补充:
影像质感:真实 65 毫米宽银幕变形胶片,画幅 21:9 纪实写实风格,极致真实,非渲染图;细腻流动的胶片颗粒,轻微光晕,极浅景深 —— 手与面部清晰,远景景物虚化;高光可控不溢,黑色深沉柔和;低饱和克制色调,仅点缀一丝柔和的暖黄色。
音效:全程仅使用现场原声,从第一帧到最后一帧 —— 风声与积雪流动的嘶响、她走远的脚步声、篝火低沉噼啪声、她攥手时毛皮袖的摩擦吱呀声、紧握时皮肤相贴的细微挤压声、父亲一次急促的吸气声、她轻柔的呼吸声。绝对禁止任何音乐—— 无配乐、无环境嗡鸣、开头结尾都不能有乐音。无人声、无口哨、无字幕、无画面内文字。
这些效果按需要选择,不必每次全部添加。
这样,同一张场景图就能配合不同镜头使用。想改变虚化程度或胶片质感,可以调整视频提示词,让场景准备和镜头效果各自有清楚的控制位置。
四、道具会被使用,就要写清楚怎样变化
道具静止时看着正常,动起来却容易出问题。比如杯子倒水时改变形状,信封打开后忽然换了尺寸,工具一碰到手就消失。
写这类镜头时,要说明两件事:道具哪些部分保持不变,使用时哪些地方会改变。
《Anerneq》有一段取火过程:女子先处理材料,再放置木板、钻杆和顶端支撑物,随后拉弓摩擦。后面切到她双手捧住引火物、靠近吹气,火苗出现,最后再拍她看向火光的脸。
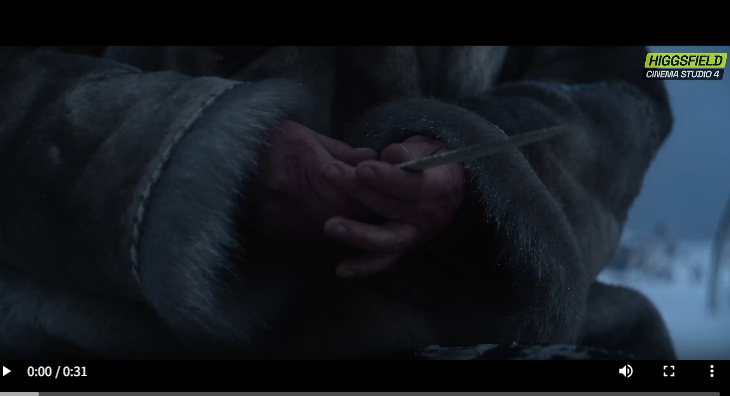
这段的重点,是让观众看懂事情怎样一步步发生。制作自己的镜头时,也可以把道具准备成三种状态:使用前、使用中、使用后。
以取火工具为例,使用前先确认木板和钻杆的形状;使用中表现同一位置受到摩擦、出现碎屑或薄烟;使用后保留接触处的焦痕。三个状态里的木板应当还是同一块,不能孔位、长度和材质都变了。
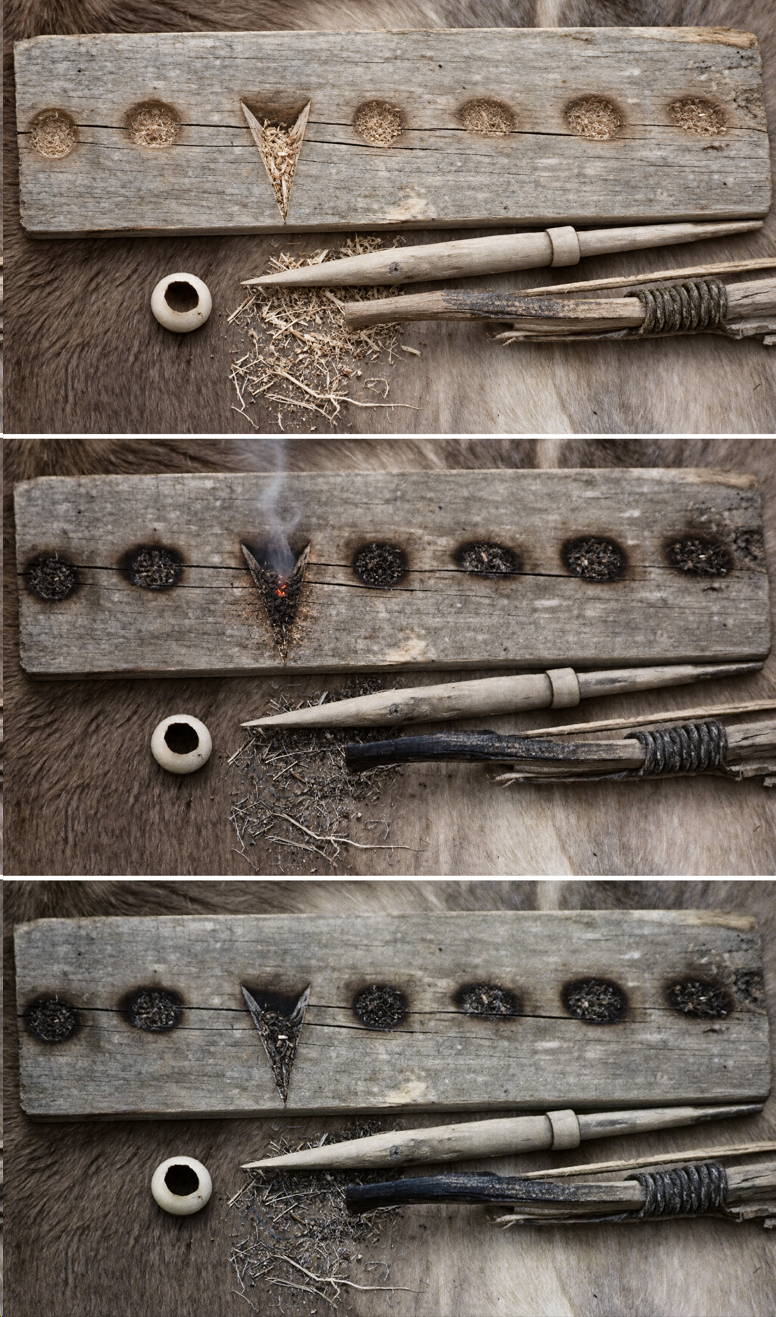
如果上传了多张状态图,要在视频提示词中说明用途
“第一张参考工具外形,第二张参考操作中的状态,第三张参考使用后留下的痕迹。”再告诉AI,这个镜头从哪一步开始,到哪一步结束。
这个方法也适用于日常题材。
比如制作火把镜头,可以提前准备三张参考图:未点燃时,头部材料完整;燃烧时,头部出现火焰和烧灼痕迹;熄灭后,头部焦黑,留下燃烧后的残余材料。
三张图保留同一根火把的手柄、绑扎方式和材质,只改变使用状态。生成视频时,再注明当前镜头参考哪一种状态。
五、镜头预演
遇到人物走位、多人互动或较复杂的动作,可以先做一段简单的动画预演。先确定人物怎么动、镜头怎么拍,再交给AI生成最终画面。
我们可以用Codex连接Blender完成这一步。连接后,用文字说明场景、人物位置和动作,让Codex在Blender中建立场景、摆放人物模型,再制作动作和相机运动。
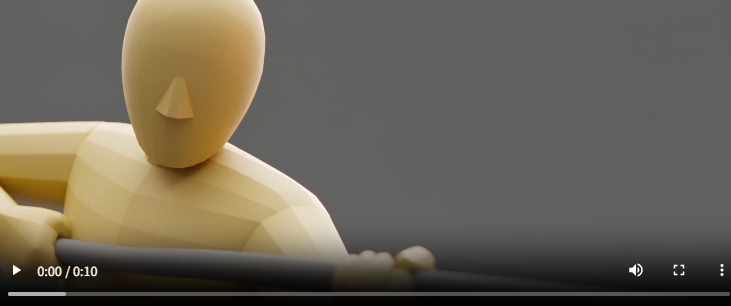
blender建模
确认以后,从Blender导出动画视频,再把它作为动作参考交给Seedance 2.5,配合人物、场景参考图和提示词生成最终画面。
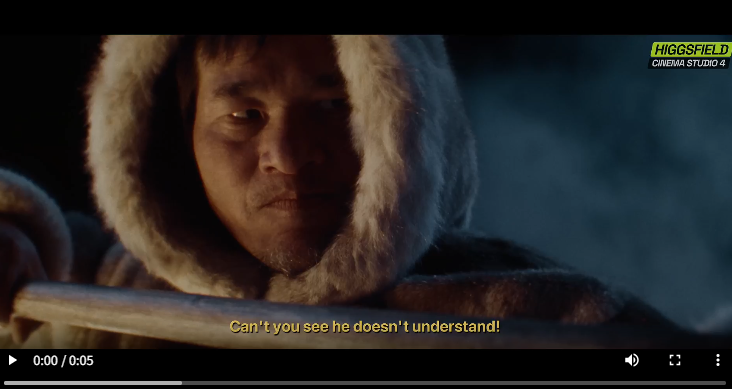
这样,人物的走位和动作就有了可参考的动画,不必只靠文字描述整段运动。
这套操作我们已经做过完整演示,连接、动作制作和导出过程,可以查看:Codex连接Blender制作动作,再交给Seedance 2.5生成。
六、眼神自然,先说清楚人物在看什么
很多人写人物时,会加“眼神自然、表情真实”。但AI仍然可能让人物一直盯着同一个点,或者不停眨眼。
可以把要求写得更具体:人物看向哪里,什么时候转移视线,遇到什么事情后,表情发生怎样的变化。
以《Anerneq》中年轻女子泰恩的这段画面为例:她躺在被烧毁的屋内,随后坐起,听到屋外父亲的声音。她没有开口回答,而是通过转头、抬眼聆听和低头沉思来表现反应。
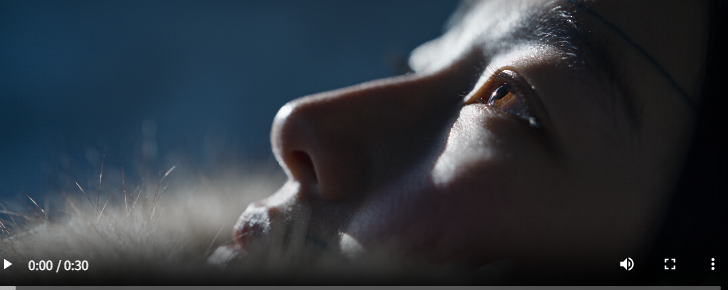
案例片段
这部分提示词可以这样写:
她睁着眼睛望向一侧,目光停留,眼球轻微移动,缓慢眨一下眼。听到屋外父亲的声音后,她先停住,头部朝声音方向微微转动,抬眼聆听。随后低下头,目光低垂。回忆母亲时,眼神短暂变得柔和,嘴角只有极轻微的变化,没有形成完整笑容。
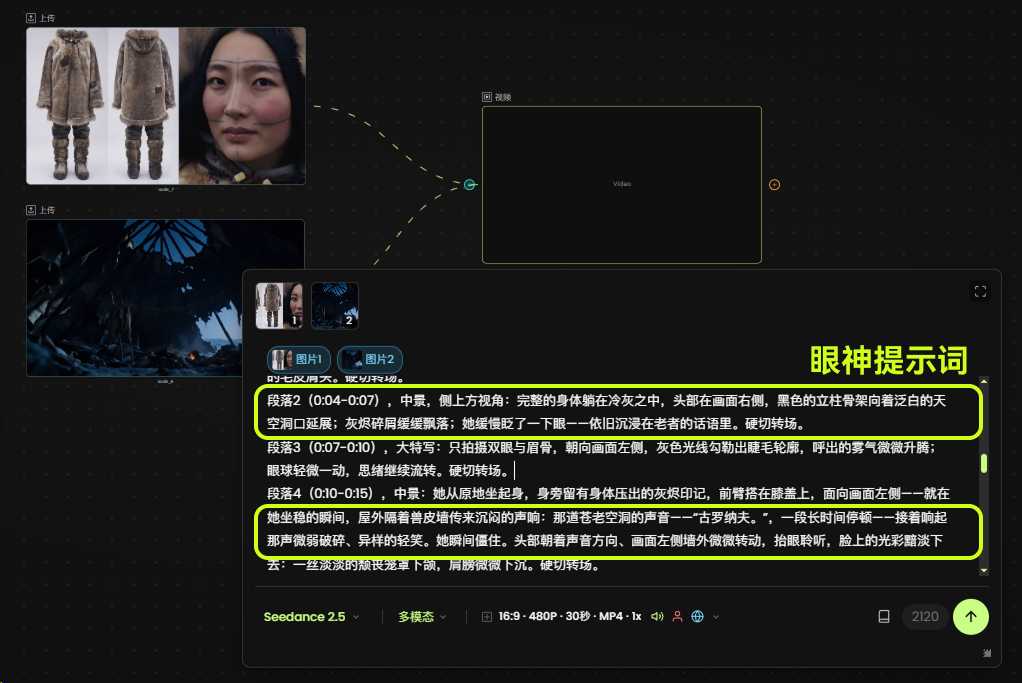
这里没有要求人物不停眨眼、不断变换表情,而是给每个变化安排了原因:听见声音,所以转头聆听;陷入回忆,所以目光和嘴角有了细微变化。
面部细节也不需要同时加满。根据镜头选择一两处变化,让眉眼、嘴角的反应有轻微先后,避免整张脸像按同一个节拍运动。
写自己的角色时,也可以按这个顺序想:他注意到了什么,先有什么反应,接着眼神和表情怎样变化。
把这些写清楚,比反复强调“自然、真实”更容易让AI理解
七、人多的时候,先确定观众应该看谁
多人画面里,如果每个人都同样清楚,都在做很大的动作,观众就容易不知道看哪里。
先确定这个镜头的重点人物,再安排其他人的位置和动作。主角可以更靠近镜头,脸部清楚;配角稍远一些,动作少一些,必要时让背景轻微虚化。
《Anerneq》有一个很容易理解的例子:穿毛皮兜帽的男子在前景,脸被暖光照亮;身后有人群和火光,但人物的脸较暗、较模糊。我们先注意到男子,再看到他所处的环境。
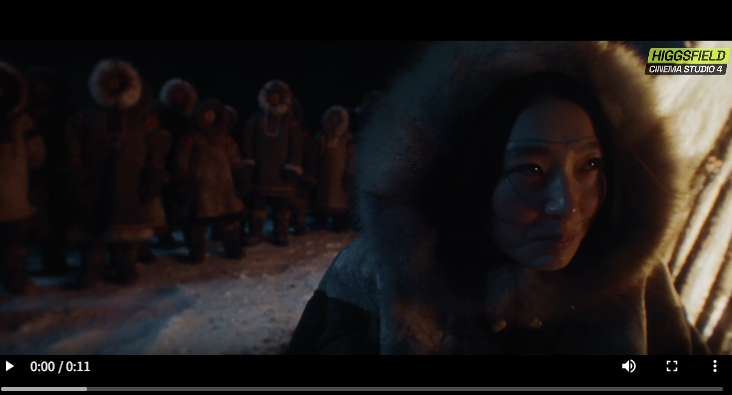
案例片段
可以照这个思路写:
焦点保持在前景男子的脸上,五官清楚。后方人群轻微虚化,不突出配角的面部细节,保留人物轮廓和背景火光。
重点是拉开主角与背景人物的清晰度,让画面有明确的观看重点。如果某个配角的表情需要被看见,再用后续镜头把他拍清楚。
八、别只写情绪,让人物为了什么去行动
非常焦急”“特别悲伤”可以告诉AI情绪方向,却没有说明人物应该做什么。想让表演更具体,可以先问:他现在想做成什么事?
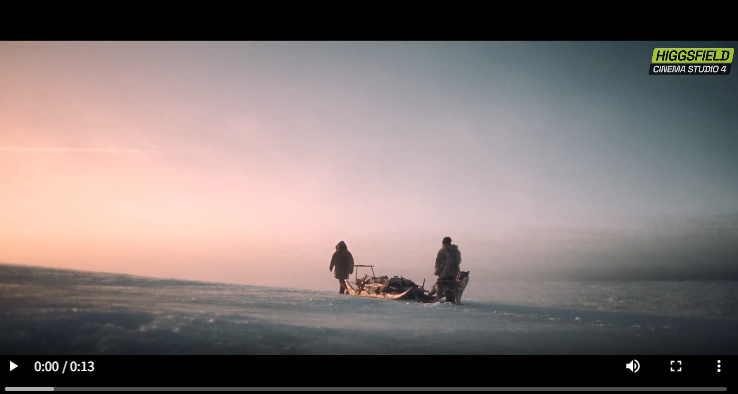
《Anerneq》里有一段女子追赶父亲的画面。父亲在前面,女子从后方赶上,伸手拉住他,弯身抬头,恳求他停下。即使不知道此前发生了什么,也能看懂她想阻止父亲继续走。
影片片段
这就是一个清楚的行动目标。焦急通过追赶、拉住和恳求表现出来,不必只靠皱眉或大哭。
比较两种写法:
简单写法:女子非常焦急,表情悲伤,演技真实。
具体写法:女子发现父亲继续向前,立刻追上,伸手拉住他的上臂。她抬头看向父亲,急切地请求他停下,注意力始终放在对方身上。
后一种写法给出了对象和动作,也交代了顺序。先追上,才能拉住;拉住以后,再看着对方恳求。不要把这些动作同时塞在同一个瞬间。
换成其他题材也是一样。
想写犹豫,可以让人物伸手去拿桌上的信,又在碰到之前停住;想写不舍,可以让人物走到门口,停下,再回头看屋里的人。
动作不需要多,但要和当前事情有关。一个人着急找钥匙,可以翻口袋、看桌面、重新检查外套。随便给他加摇头、眨眼、摸头发,却没有寻找对象,观众仍然不清楚他在做什么。
还要给反应留一点时间。人物发现火星,可以先停住确认,再护住引火物;听到回答,可以先看向对方,再决定是否开口。适当停顿能让动作前后的关系更清楚。
九、把提示词写成一件能看懂的事
写视频提示词时,可以依次回答五个问题:谁在画面里,在哪里,要做什么,动作怎样发生,镜头怎样拍。
发现问题后,一次先改一个主要地方。工具总被挡住,就先改角度;表情没有原因,就先补人物要做的事;镜头太乱,就先减少运动。每次比较修改前后的结果,逐步留下有效的写法。
练习时,不妨从一个人、一个道具、一个动作开始。先让观众看懂人物在做什么,再增加其他角色、复杂场景和风格效果。具体的参考与清楚的行动,会让提示词更容易使用,也更容易修改。