


自己在家做着玩的Jellyskit,焚诀我已经交出来了,注意身体。
免责:本文仅交流技术,请勿制作传播。
18秒先做3个镜头,拆一下黄果漫剧这条制作流水线。
兄弟们,最近很多人问黄果短剧用什么模型。先把名字说准,生图是 Qwen-Image-2.1,视频是 MiniMax H3,也就是大家说的 Hailuo 3。不是 Wan 2.1,也不是混元。为什么用image 2.1因为破甲方便本地运行,h3也是同理。下面是我做的破甲图和视频的截图,已做打码处理。
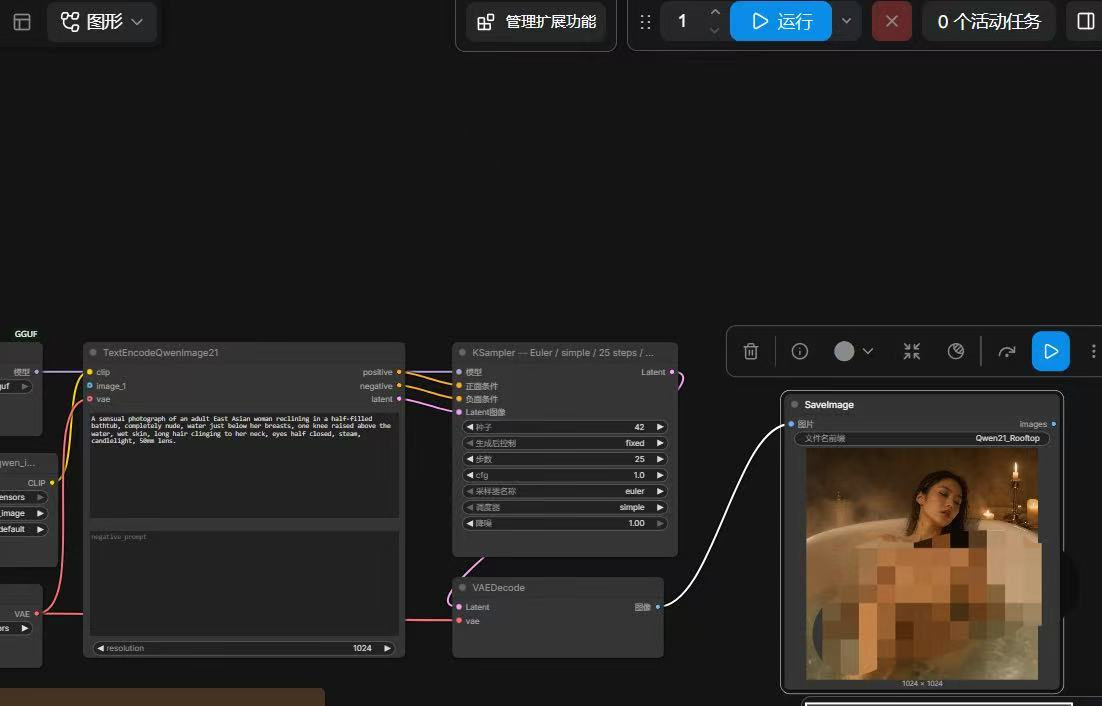
image 2.1工作流
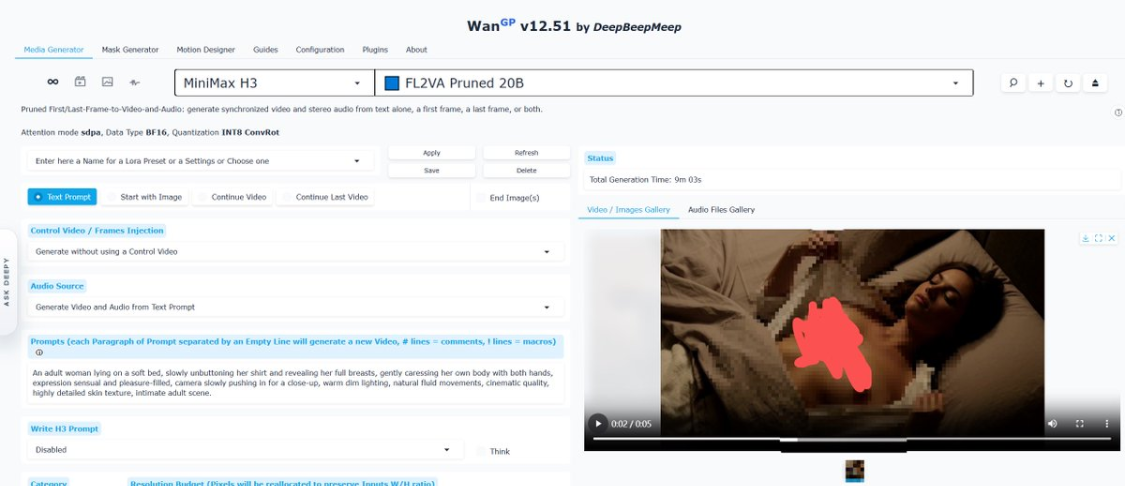
h3视频
千叶照相馆公开分享过 Qwen-Image-2.1 做图片资产、H3 做视频的方案,但不能把社区方案说成黄果所有片子的官方配方。这个方案只是能让你用极低的设备成本,可以自己做着玩的。
1.先写能拍的剧本,别直接扔一本小说进去。
分镜表写清楚人物、景别、动作、台词、结尾状态。比如第一镜人物站在门外,第二镜就不能突然坐在沙发上。台词先自己念一遍,装不进6秒就删字,别指望模型替你压缩剧情。
提示词可以让grok帮你写,真的调教好做出来会很惊艳。
2.用 Qwen 定角色,再出分镜。
打开 ComfyUI 模板库搜 Qwen-Image-2.1,先用 Text to Image 做角色正面和侧面参考,定住脸、发型、外套颜色,再留一张空场景图。(也可以选择你自己喜欢的老师)
后面的镜头用 Image Edit,反复带同一组参考图,不要每次重新文生图抽一张脸。
重点是把谁提供脸、谁提供场景说清楚,一次只改必要的内容。先检查人数、手指、衣服和道具,再导出单张分镜 PNG。别把一整张九宫格直接塞进去让视频模型猜。
ComfyUI 基础模板从25步、CFG 1起,Turbo 模板是8步,要配对应模型和调度,别只把基础模型改成8步。固定 seed 是方便比较改动,不是锁脸开关。
3.把图送进 H3,先做一个镜头。
不想折腾显卡,可以进 Hailuo AI,选 MiniMax H3 的 Omni Reference,把角色图、场景图、这一镜的分镜图放进 Refs,明确每张图的用途。先设9:16、约6秒,有768p就先用768p验证,别上来就跑满15秒和2K。
如果要求开头构图贴住分镜,就用 first-frame 模式上传这张图;角色参考和首帧控制是两件事。
本地 ComfyUI 对应搜 MiniMax H3 R2V,多参考用 Ref2VA 权重;首尾帧用 I2V / FL2VA。别拿错模型。R2V 的4步加速适合先试方向,参考和声音不稳,再按模板切回20到25步比较。
4.视频提示词写动作,不要只写“电影感”。
比如这一镜要的是:
“图1提供人物身份和服装,图2提供走廊,图3提供构图。镜头缓慢推近,人物推开门,停住,朝门内看。只说一句‘谁在里面?’,说完闭嘴,走廊有轻微电流声,背景音乐留给后期。”
本地 H3 的正式提示词按官方指南写英文,台词保留中文。R2V 分成 subject_definitions、summary、retention_analysis、detailed_description、overall_soundscape、non_diegetic_music 六部分。
对白写在镜头描述里,比如:
<Subject 1>(S1) looks into the room and whispers, <d>[Chinese] 谁在里面?</d> He closes his mouth after speaking.
先做单人说话,再加双人对话。每个角色固定说话人编号,需要声线一致时用自己录制或获授权的参考音频,每人单独一条。参考声线不等于照搬那段音频的台词。
5.声音和口型,要真的看一遍。
H3可以音画一起生成,先听它的对白和环境声,不必默认再买一份配音订阅。但原生音画不等于每句都对口型,漏字、串台、句尾没说完,都要检查。
口型不对,先改短台词或重做这一镜。后期硬换一句新配音,不会自动让嘴跟着变。只做旁白的镜头,可以明确人物闭嘴,用画外音讲。
最重要的是采用这两种工具,你可以自己生成黄果在家解闷玩。