



为什么同一个产品,单独生成时看起来很正常,放进不同镜头后,却突然变大或变小了?
为什么第一段视频中的道具细节非常完整,到了第二段视频里,外观却发生了变化?有时候,甚至连道具的结构、颜色和原本的尺寸关系都无法保持。
遇到这些问题,很多人会不断修改提示词,反复强调保持大小一致、符合真实比例。但即使写了很多限制,生成结果仍然可能出现偏差。
这是因为,道具的外观、实际尺寸,以及它在不同镜头中的呈现方式,是三个不同的问题。
想要提高道具的一致性,除了在提示词中明确要求,还可以从参考图入手。
本节介绍两种实用方法。
第一种是在制作道具资产时,增加手掌等尺寸参照,让 AI 更直观地理解道具与人体之间的相对比例。
第二种是在生成连续视频时,将上一段视频中已经生成好的道具截图下来,作为下一段视频的参考图,让 AI 尽可能延续已经确定的道具外观和尺寸关系。
这两种方法分别解决道具资产制作和连续视频生成中的不同问题。掌握之后,就能减少重复调整,让道具在不同镜头中保持更稳定的表现。
一、为什么同一个道具,换个镜头就变了?
先理解一个问题:AI 能够识别物体的外观,并不代表它已经准确掌握了物体的实际尺寸。
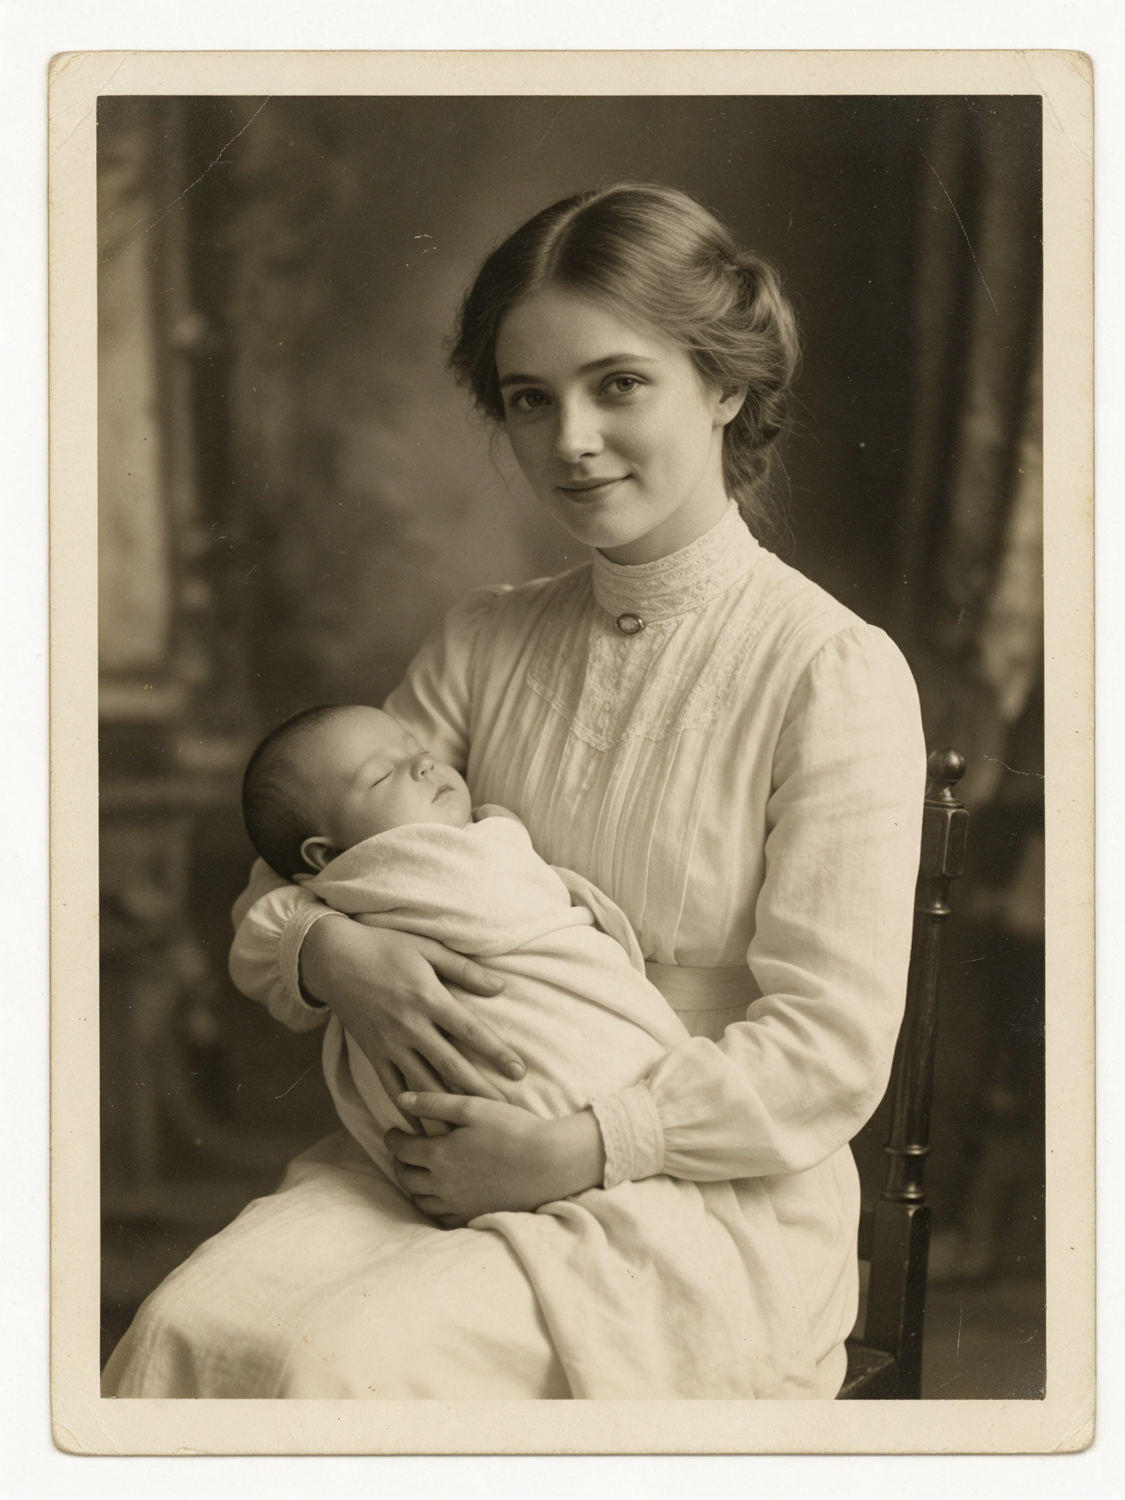
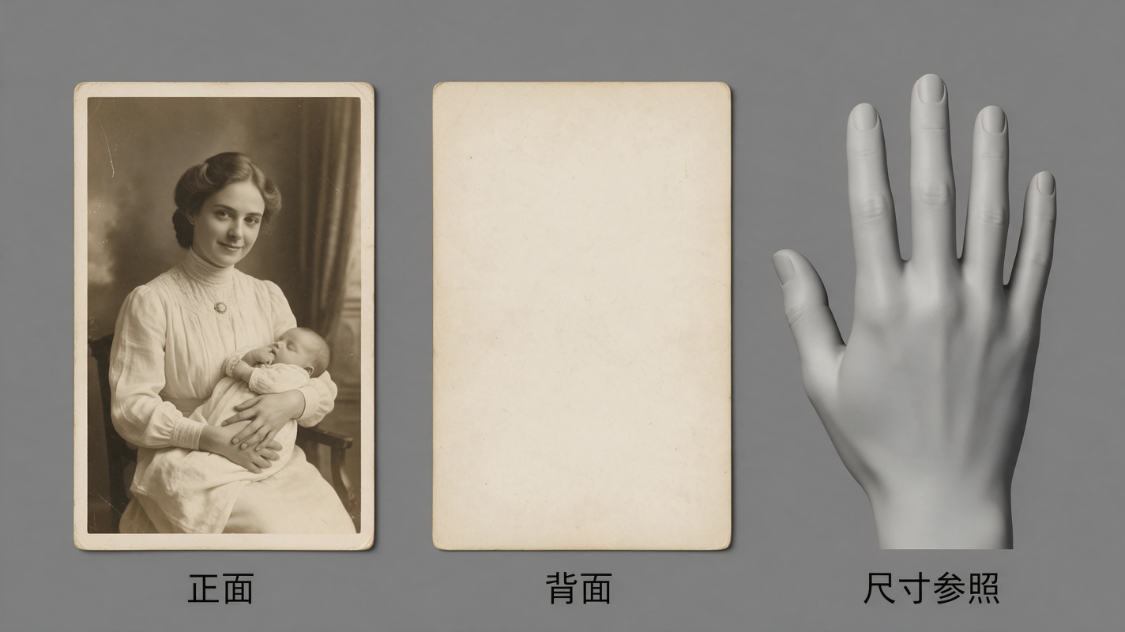
例如,你上传一张照片,希望 AI 生成一个人物拿着这张照片的画面。
参考图可以清楚地展示照片的颜色、边框、图案和纸张质感。这些信息能够帮助 AI 还原照片的外观,却不一定能明确告诉它,这张照片在现实中究竟有多大。
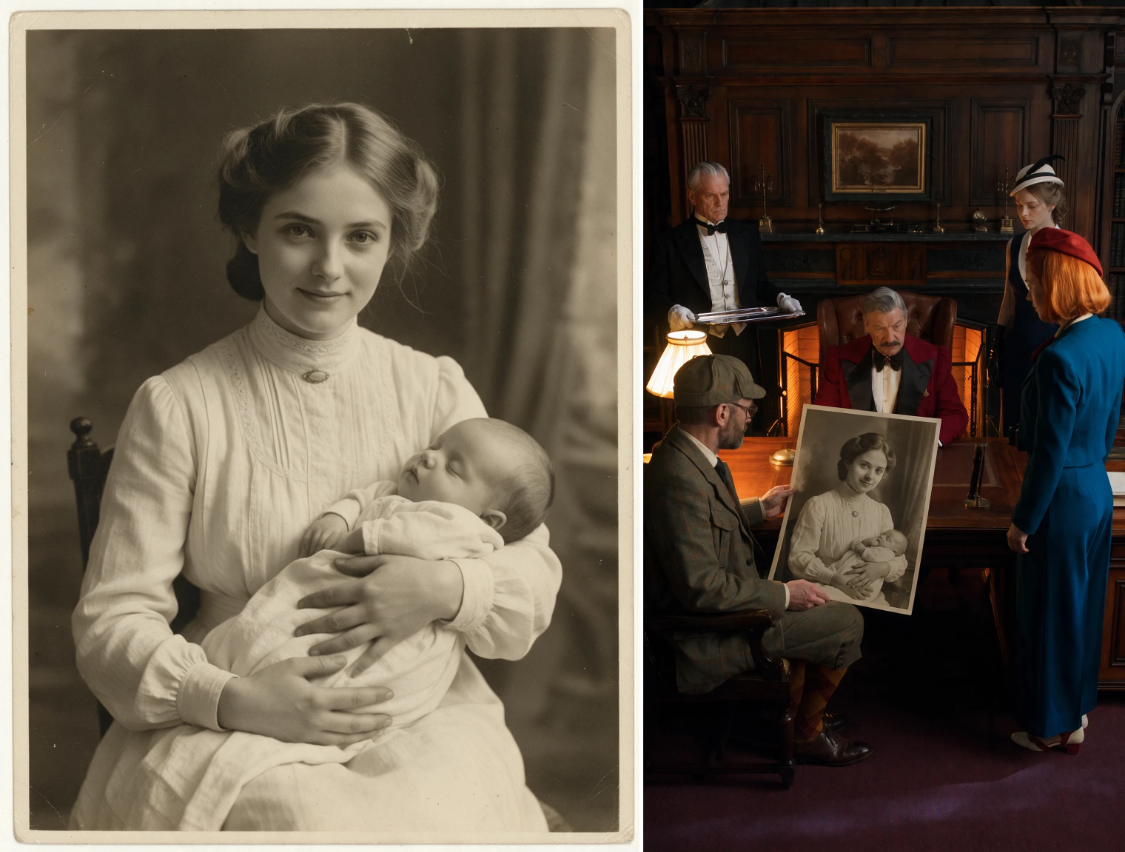
道具图
同样的情况也会出现在手机、杯子、书本、包装盒和其他产品上。
如果只提供一个独立物体的图片,AI 可能知道它是什么,却缺少判断它与人物、手掌以及周围物体之间尺寸关系的直接依据。
当道具进入完整场景后,人物姿势、构图、镜头景别和摄影机距离都会影响最终的画面表现。如果缺少明确的比例参照,模型就可能生成一个构图看起来合理、但实际比例不够自然的道具。
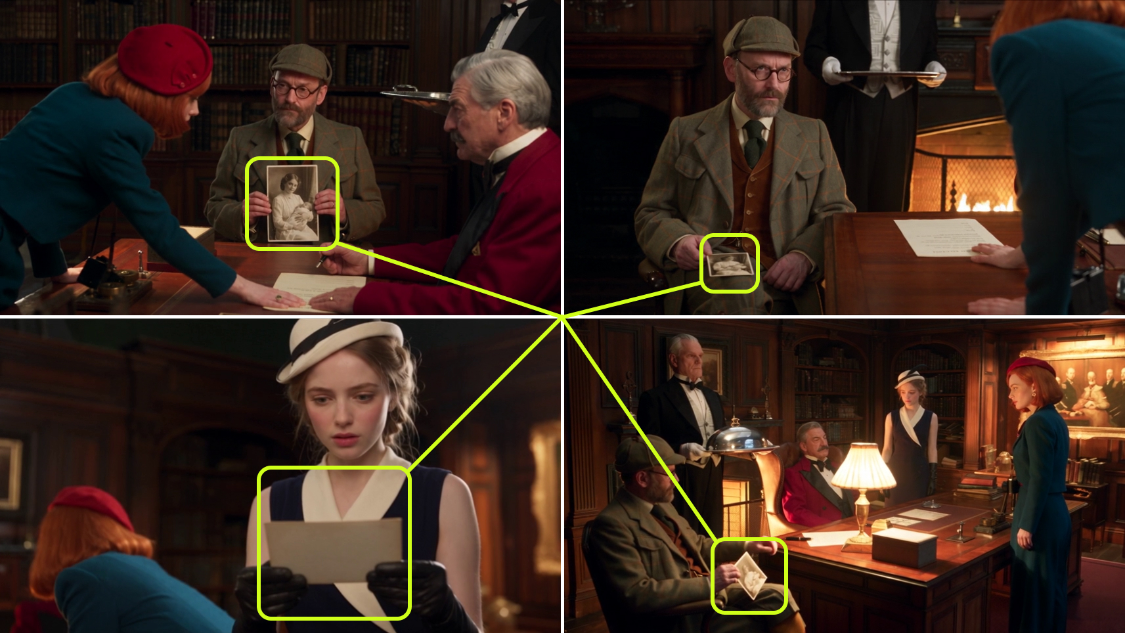
例如,一个人物拿着手机,手机的宽度应该与手掌相协调。如果生成结果中的手机大到接近整个手掌,人物的握持姿势就会显得不自然。
如果你继续生成下一个镜头,手机的外观可能基本没有变化,但它与人物手掌之间的比例却可能再次发生偏差。
这里需要区分两个概念。
第一,物体的实际比例。
例如,手机与手掌之间的尺寸关系,书本与手臂之间的尺寸关系。这些关系应该符合合理的现实尺度。
第二,物体在画面中的占比。
同一个手机,在远景中可能只占画面很小的一部分,在特写中则可能占据画面中央的大部分区域。这是正常的摄影表现。
我们真正需要解决的,不是让道具在所有镜头中看起来一样大,而是让它在不同景别中保持合理的物理尺度和外观连续性。
因此,想要提高道具的一致性,不能只关注提示词,还需要考虑参考资产应该提供哪些信息,以及这些信息如何在后续镜头中延续。
二、方法一:通过图生图,为道具增加可控制的尺寸参照
第一种方法适合在正式生成视频之前使用。
我们不需要重新制作道具,也不需要进行复杂的三维建模。
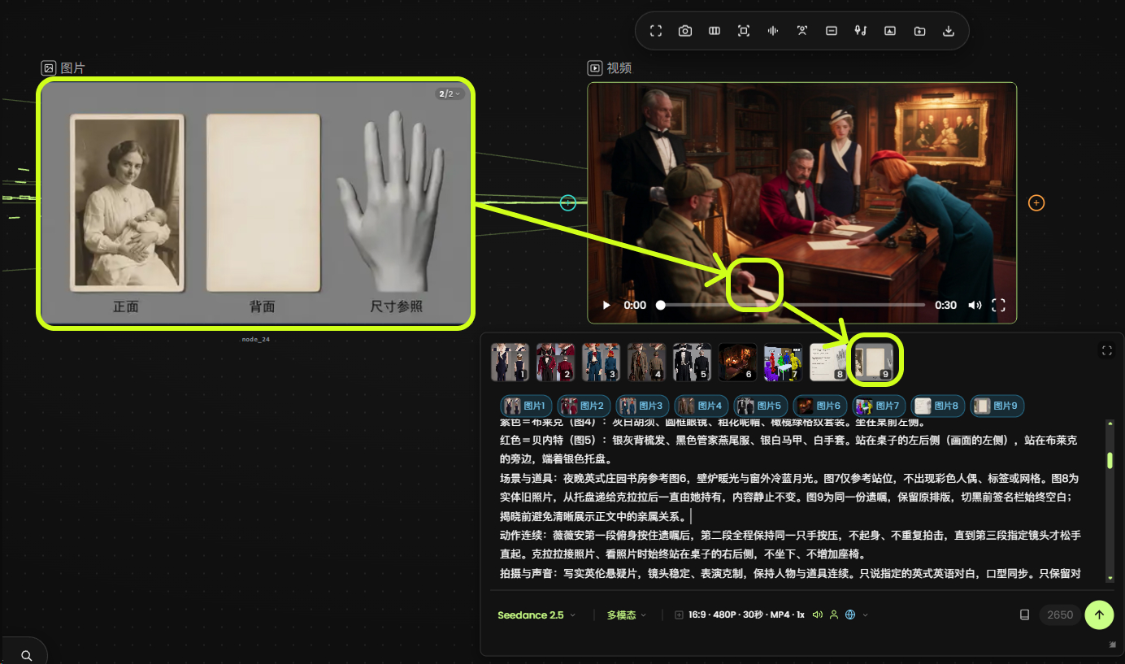
只要准备好原始道具图片,再通过图生图的方式,在旁边增加一只作为尺寸参照的手掌,就能够让AI获得更加明确的比例信息。
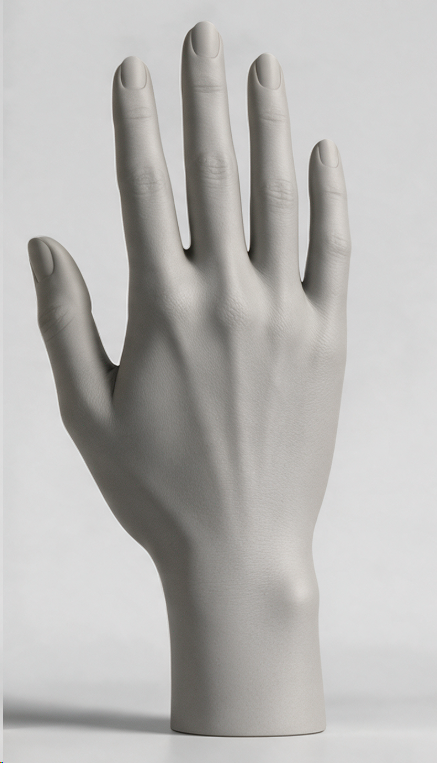
而且,手掌与道具之间的大小关系还可以通过提示词主动控制。
第一步:准备一张原始道具图片
首先,准备一张已经生成好的道具图片。
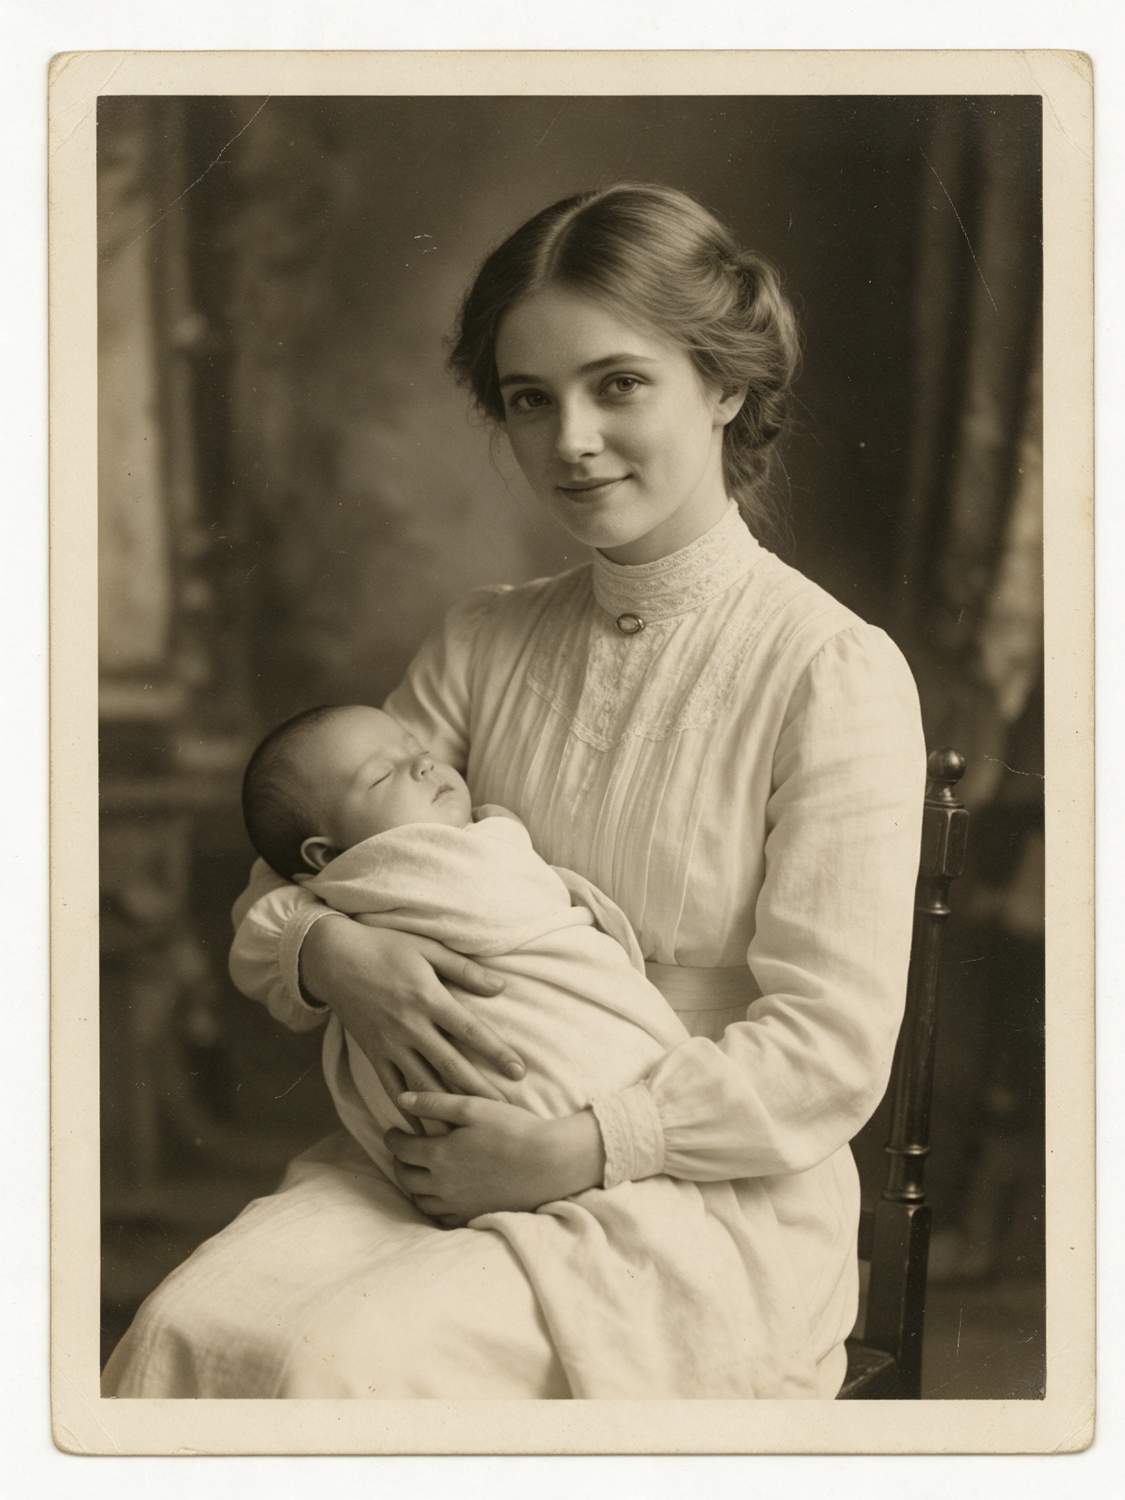
可以是一张遗嘱、一封信件、一本书,也可以是杯子、手机、包装盒或其他产品。
如果直接把它放进人物手中,AI就可能自行判断遗嘱应该有多大。
因此,我们可以先处理这张道具图片,为它增加一个尺寸参照,再用于后续的场景生成。
第二步:通过图生图,增加手掌并控制比例
接下来,将原始道具图片上传到seedream5.0 pro中。
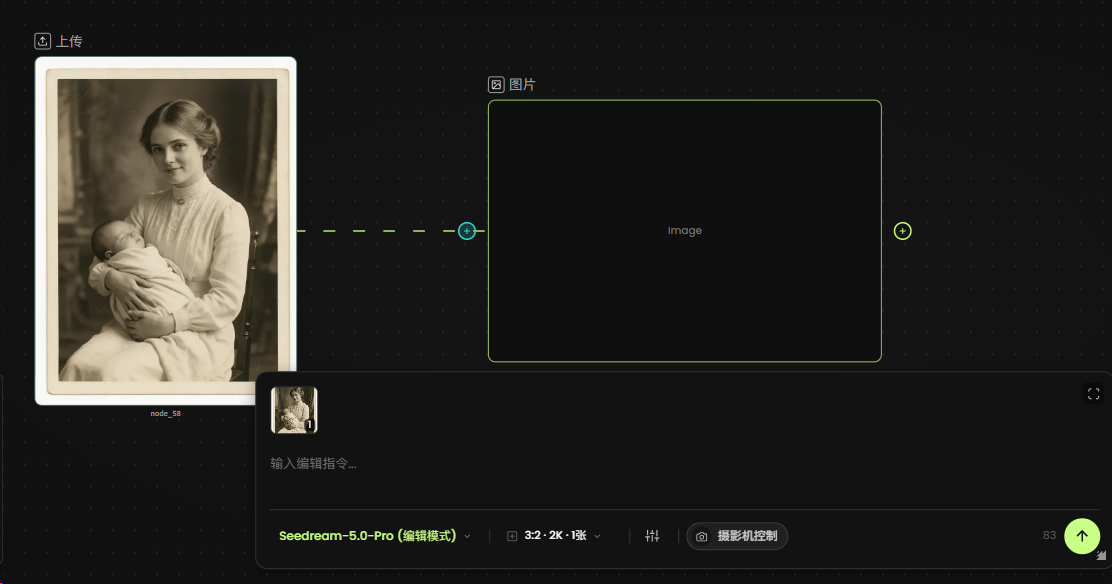
这一步的目标非常明确。
保留原有道具的外观,在旁边增加一只虚拟手掌,并指定道具相对于手掌的大小。
这里,我们采用统一的浅灰色虚拟手掌模型,而不使用真实人物的手。
因为虚拟手掌没有复杂的皮肤纹理、饰品和服装细节,能够更加清楚地承担尺寸参照的作用。
我们将成年女性虚拟手从腕部到中指指尖的长度设定为约18厘米。
接下来,只需要通过修改一个比例参数,就可以控制道具相对于手掌的大小。
例如:
0.5倍:道具最长边约为手长的一半,即9厘米。
1倍:道具最长边与手长相当,即18厘米。
1.5倍:道具最长边约为27厘米。
2倍:道具最长边约为36厘米。
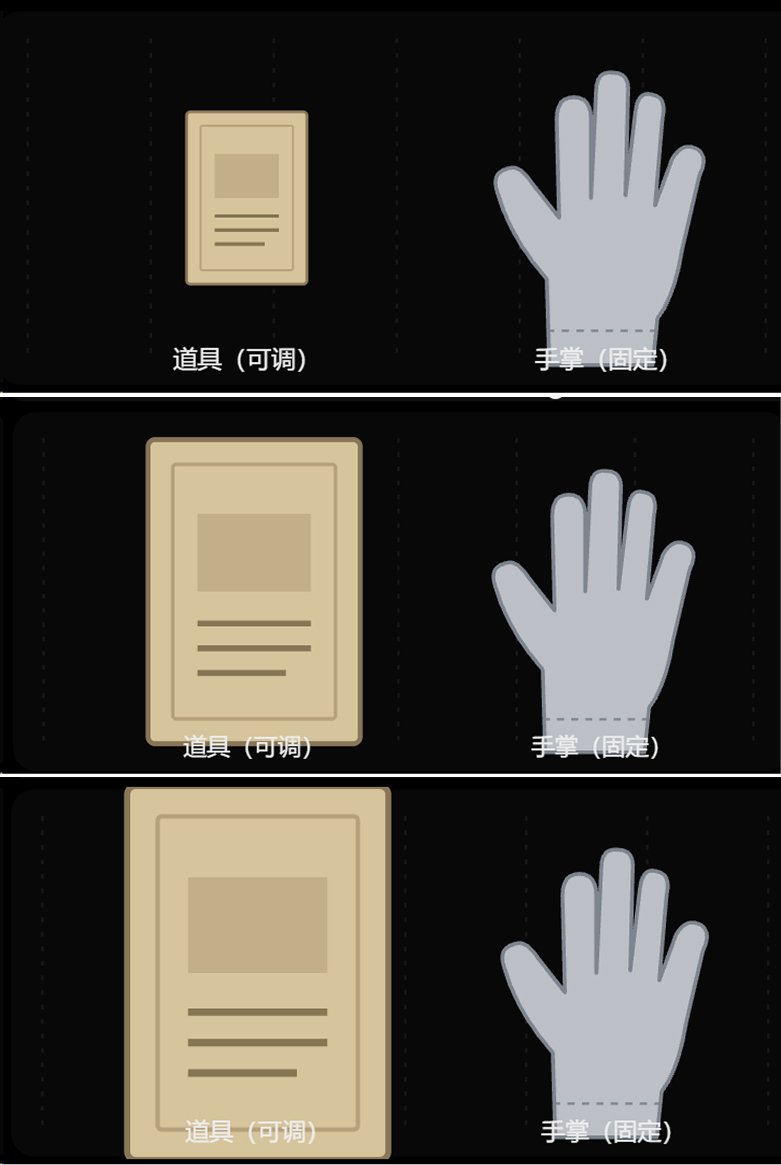
这样一来,我们就不必每次都让AI自行猜测道具的大小,而是可以通过修改比例参数,主动决定道具应该有多大。
例如,如果生成的是一张小型照片,可以尝试将比例设置为0.8倍。
如果生成的是一张较大的纸质文件,可以将比例设置为1.5倍。
如果生成的是一个更大的道具,也可以继续增加比例。
具体数值需要根据实际物体和创作要求调整,并不是所有道具都适合同一个比例。
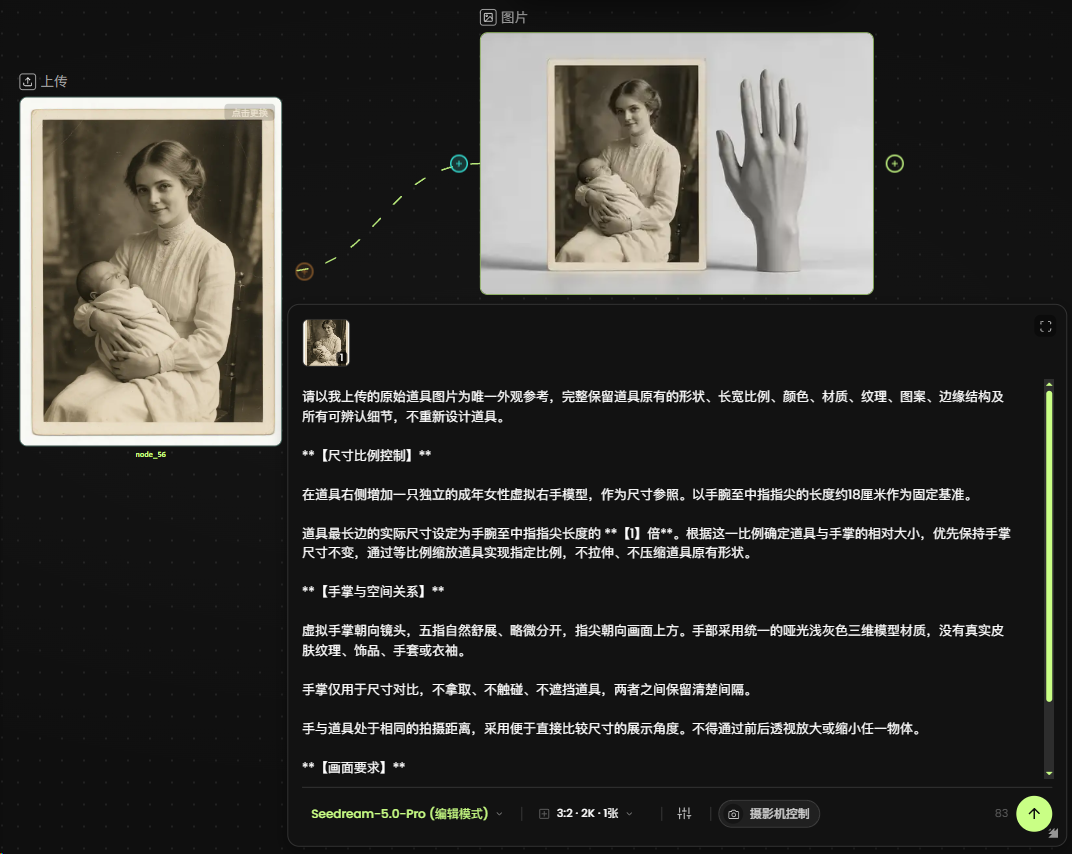
下面是可以直接使用的通用图生图提示词。
请以我上传的原始道具图片为唯一外观参考,完整保留道具原有的形状、长宽比例、颜色、材质、纹理、图案、边缘结构及所有可辨认细节,不重新设计道具。
**【尺寸比例控制】**
在道具右侧增加一只独立的成年女性虚拟右手模型,作为尺寸参照。以手腕至中指指尖的长度约18厘米作为固定基准。 道具最长边的实际尺寸设定为手腕至中指指尖长度的 **【1】倍**。根据这一比例确定道具与手掌的相对大小,优先保持手掌尺寸不变,通过等比例缩放道具实现指定比例,不拉伸、不压缩道具原有形状。 **【手掌与空间关系】**
虚拟手掌朝向镜头,五指自然舒展、略微分开,指尖朝向画面上方。手部采用统一的哑光浅灰色三维模型材质,没有真实皮肤纹理、饰品、手套或衣袖。 手掌仅用于尺寸对比,不拿取、不触碰、不遮挡道具,两者之间保留清楚间隔。 手与道具处于相同的拍摄距离,采用便于直接比较尺寸的展示角度。不得通过前后透视放大或缩小任一物体。 **【画面要求】**
适当扩展画面,完整容纳道具与手掌。保留道具原有的展示角度和外观特征,背景简洁干净,光线均匀柔和。 严格执行指定的尺寸比例,确保手掌与道具的相对大小直观明确,不额外增加其他物体。
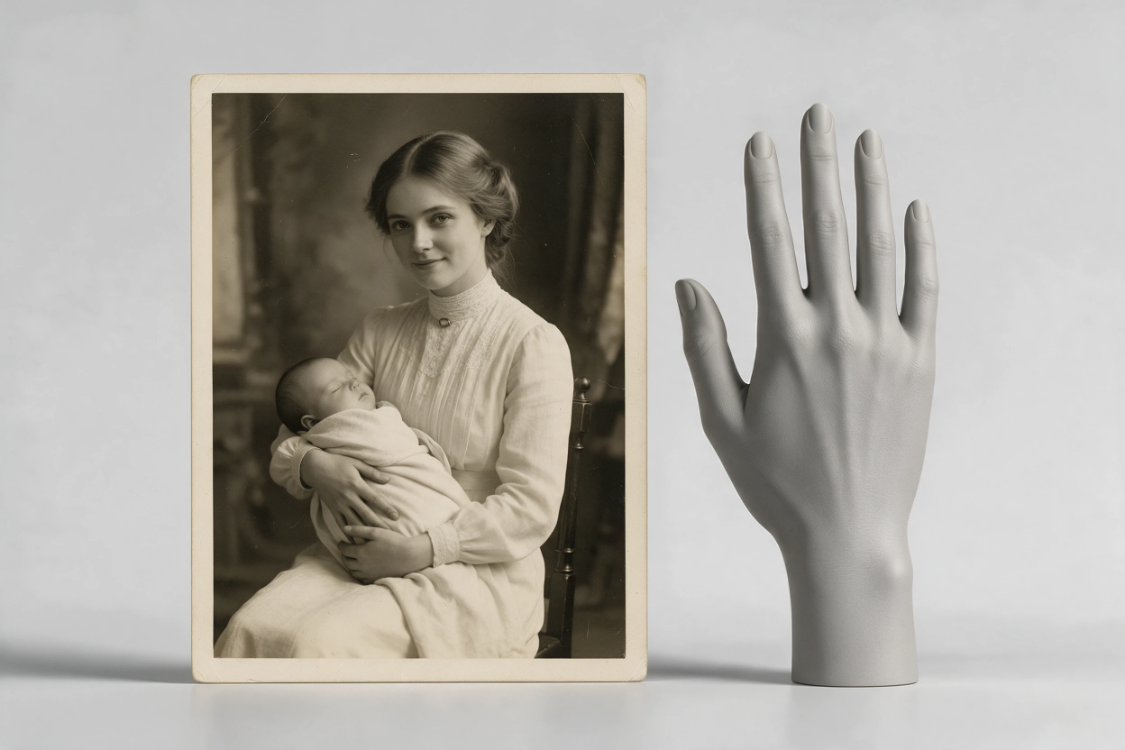
最后,把调整完成的图片保存下来。
这时,我们得到的就不再是一张只有道具外观的图片,而是一张同时包含道具外观与尺寸参照的资产图。
后续在生成正式视频时,可以将这张图片作为参考,并明确告诉AI:只参考道具的外观和尺寸关系,不需要把灰色虚拟手掌生成到正式画面中。
这样就完成了第一种方法。
三、方法二:把上一段视频中的道具截图,作为下一段视频的参考
第一种方法适合在道具资产制作阶段使用。
但如果我们已经生成了一段视频,而且还需要继续生成第二段、第三段视频,又应该怎样保持道具一致呢?
这时,就可以使用第二种方法。
核心思路是:
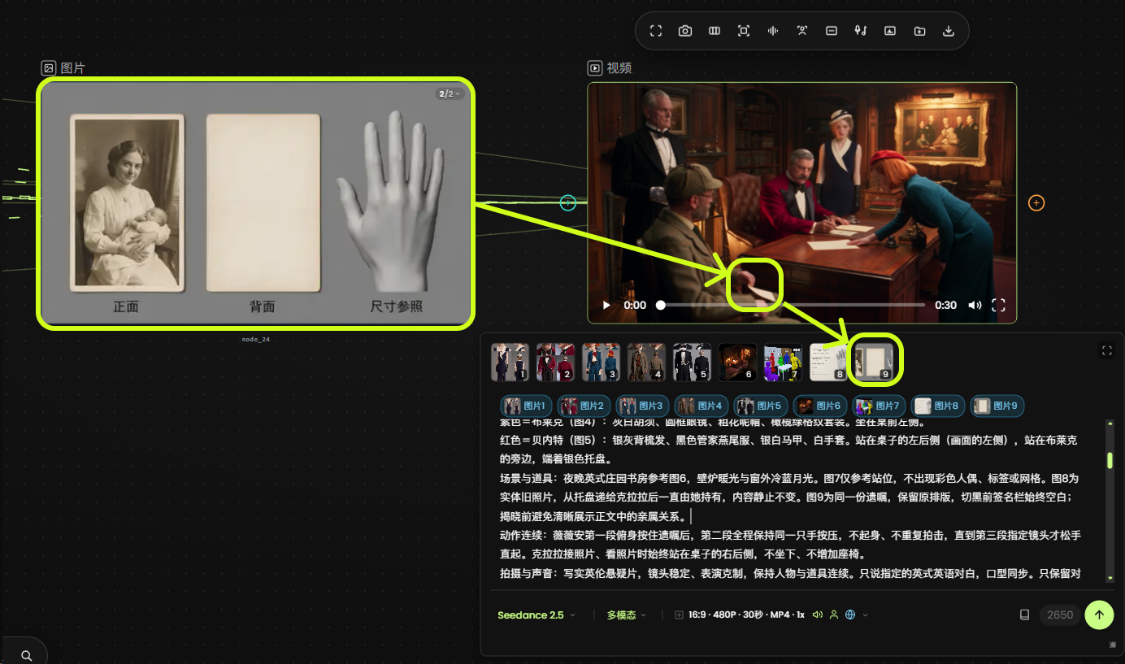
从已经生成的视频中提取一张道具清晰的画面,再将它作为下一段视频的参考图。
这种方法不需要重新制作带手掌的道具资产,而是直接利用上一段视频中已经确认的生成结果。
例如,我们正在制作一条悬疑短片。
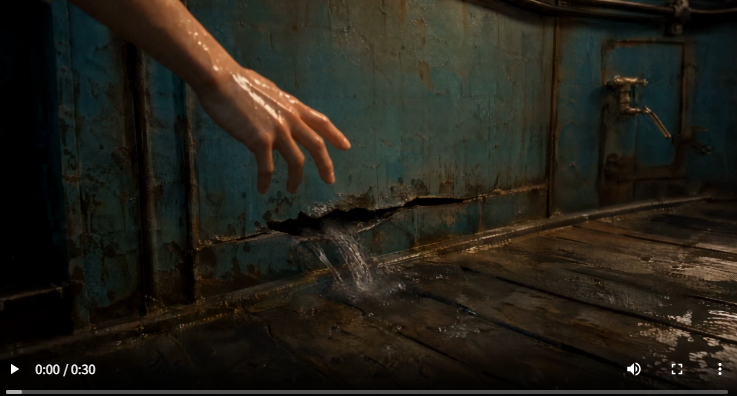
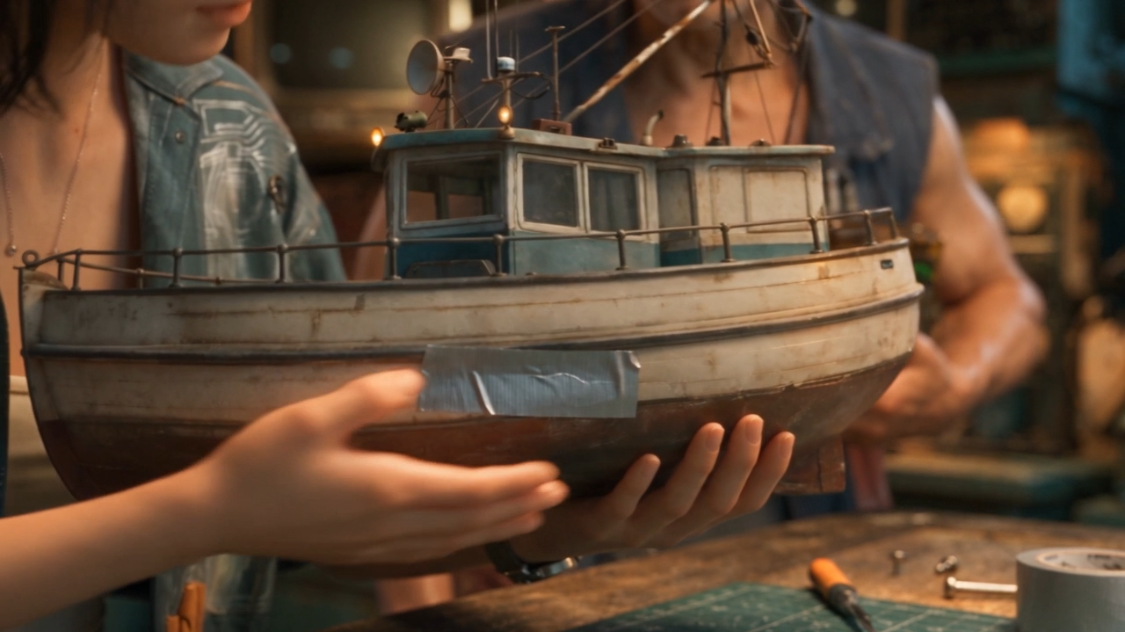
画面中,一名人物正在检查一艘旧式船模。
船模具有泛黄的白色船身、深色旧化痕迹、蓝绿色船舱、栏杆、天线以及其他细小结构。
在第一段视频中,这艘船模的外观和大小都已经符合要求。
接下来,我们需要生成第二段视频,让人物继续观察或操作同一艘船模。
如果只依靠文字重新描述,并且用原本的道具资产人物手拿道具的方向,还有道具贴粘胶的细节,以及道具的大小都会不一致。
即使整体看起来仍然是一艘旧船模,它也不一定是前一个镜头中的同一件道具。
这时,最简单的方法就是从第一段视频中选择一张清晰的画面,将它截图保存。
第一步:从第一段视频中提取道具关键帧
首先,打开已经生成好的第一段视频。
找到道具展示比较清晰的时刻,将画面截图下来。
这里需要注意,并不是随便截取一帧就可以。
尽量选择道具轮廓完整、主要结构清楚、没有严重运动模糊的画面。
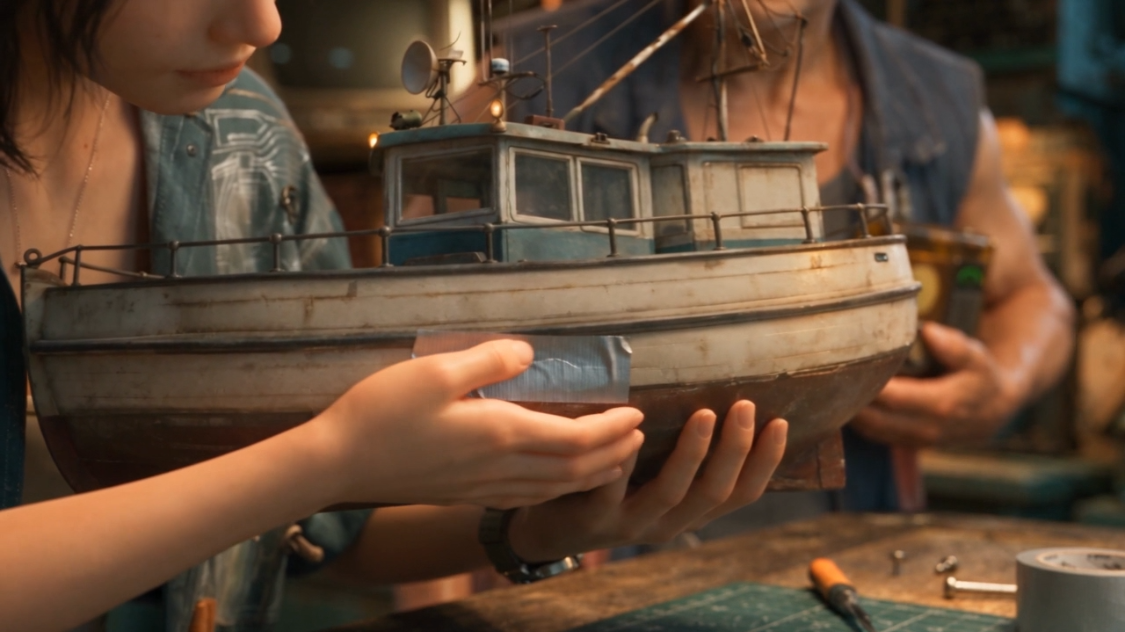
第二步:将截图作为下一段视频的参考图
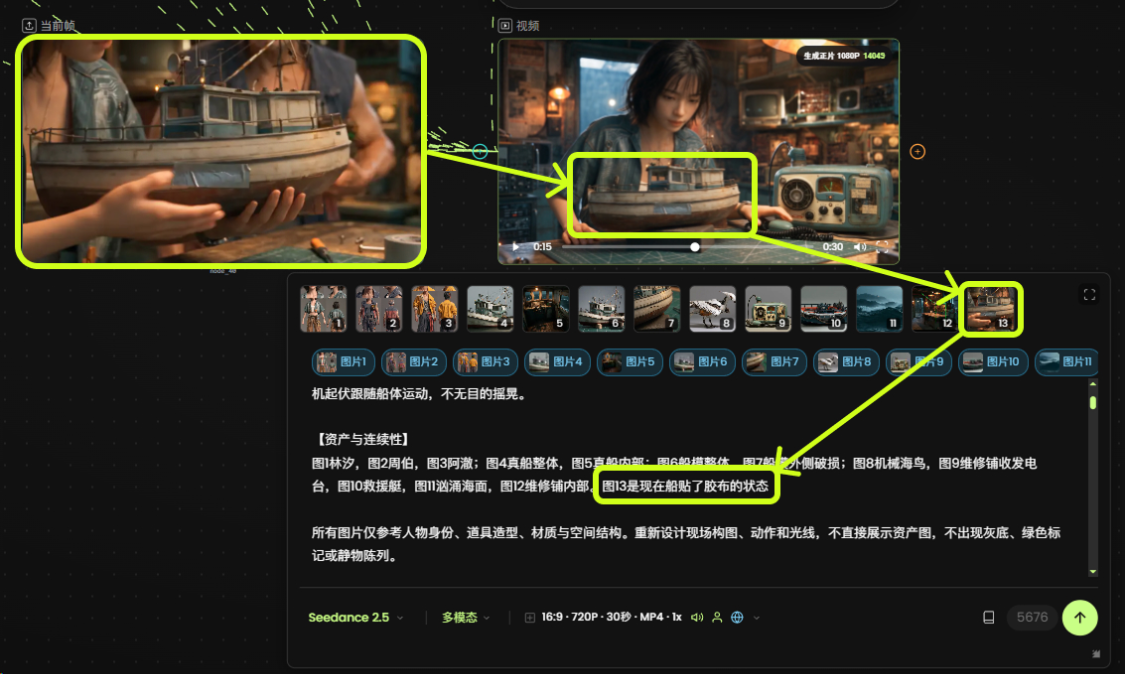
截图保存后,在生成第二段视频时,将这张图片上传到支持图片参考的视频生成工具中。
然后告诉AI,参考图中的道具就是上一段视频中已经出现过的同一件物品。
第二段视频需要延续它的外观、结构、材质、颜色和尺寸关系。
第三步:明确指定参考图的作用
在视频生成提示词中,建议增加一段道具的描写
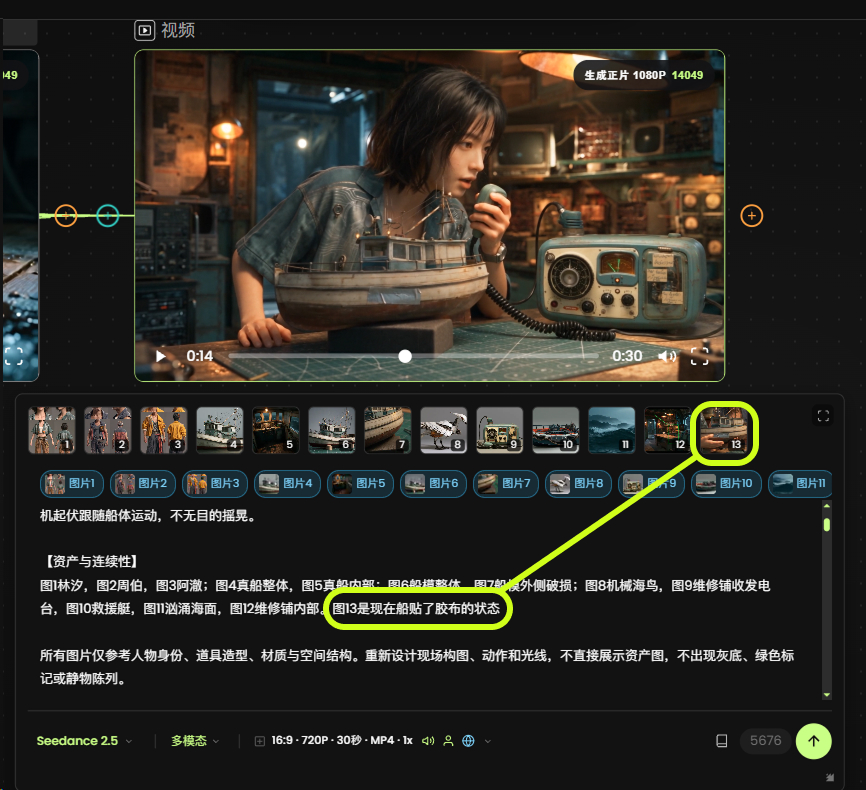
比如这里就简单地说明,图13是现在船贴了胶布的状态
它的主要作用,是告诉AI:这张参考图提供的是道具信息,而不是整张画面的复刻要求。
这样,在生成第二段视频时,模型就能够获得更明确的视觉参考。
第四步:检查前后视频的道具一致性
第二段视频生成完成后,我们还需要对比前后两个片段。
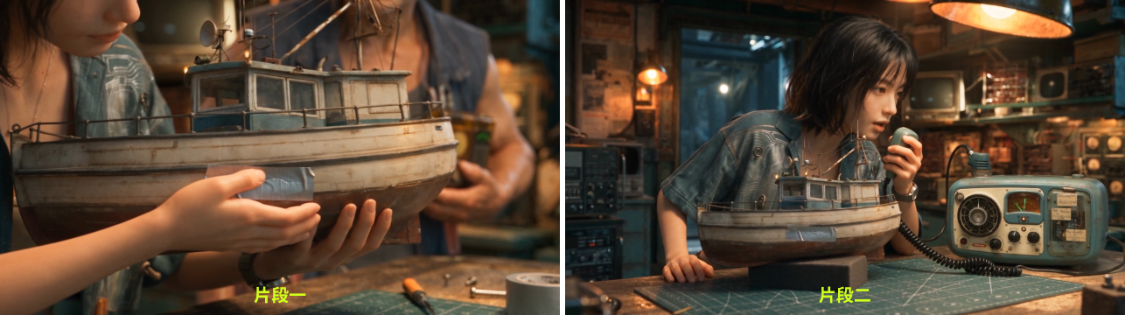
四、为什么第二种方法能提高连续视频的一致性?
理解第二种方法之后,我们还需要知道它为什么有用。
原因其实很简单。
已经生成好的画面,本身就可以成为后续生成的视觉参考。
当我们只使用文字描述一个道具时,AI需要根据这些文字重新理解物体的外观。
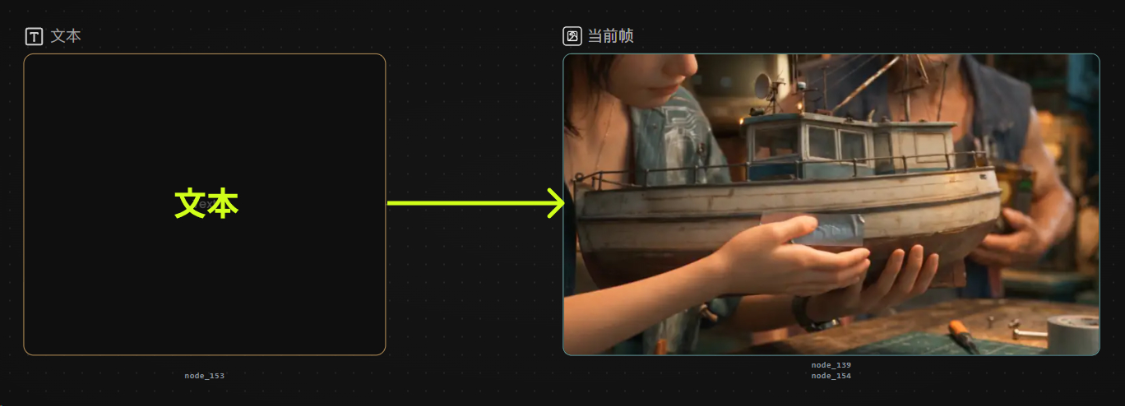
即使我们已经写清楚了颜色、形状和材质,也很难完整描述一个复杂道具的所有细节。
例如,一艘船模可能有多层甲板、不同形状的栏杆、特殊的船舱结构以及大量细小的装饰部件。
如果每一段视频都重新描述这些内容,不仅需要较长的提示词,还容易遗漏细节。
但如果使用已经生成的画面作为参考,模型就可以直接看到这些结构。
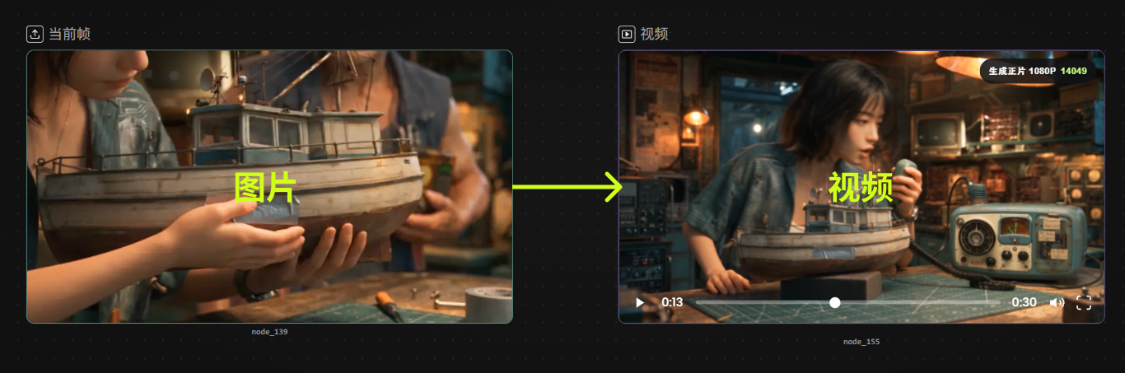
同样,参考图中如果包含人物手部与道具的关系,也能够为后续生成提供一定的尺寸依据。
这就相当于把上一段视频中已经确认的结果,继续传递到下一段视频。
不过,这种方法也有一个需要注意的问题。
如果前一段视频中的道具已经出现了比例错误,直接把错误画面当作新的参考,也可能让偏差继续延续。
所以,应该优先选择外观正确、尺寸关系合理的关键帧。
五、两种方法分别适合什么情况?
虽然这两种方法都能够帮助我们控制道具一致性,但使用阶段有所不同。
第一种:还没有生成视频
如果你已经准备好了道具图片,但还没有把它放进正式的场景中,就可以优先使用手掌参照法。
通过图生图,为道具增加一个固定尺寸的虚拟手掌。
再根据道具实际需要,修改比例参数,主动控制道具的大小。
当道具比例调整完成后,就可以把它保存为标准资产,供后续图片或视频生成使用。
这种方法更适合解决道具初始资产缺少尺寸信息的问题。
第二种:已经生成了一段视频
如果第一段视频已经生成,而且其中的道具外观、结构和大小都符合预期,就可以直接从视频中提取清晰的关键帧。
随后,将关键帧作为下一段视频的参考图。
这种方法不需要重新制作道具,而是直接延续已经生成好的视觉结果。
它更加适合多镜头、连续剧情和产品视频等场景。
六、建立一套更稳定的道具创作流程
对于需要连续生成多个镜头的项目,可以把这两种方法整理成一套固定流程。
首先,准备原始道具图片。
如果道具没有明确的尺寸参照,就通过图生图增加虚拟手掌,并通过比例参数确定道具大小。
接着,将处理好的道具图片保存为标准参考资产。
然后,使用这张资产生成第一段视频,并检查道具的外观、结构和相对比例是否符合要求。
当第一段视频生成成功后,从中选择一张道具清晰的关键帧。
之后,在生成第二段视频时,将关键帧作为新的视觉参考,并明确要求保持同一道具的外观和尺寸关系。
如果后面还有第三段、第四段视频,也可以继续使用这种方法。
但要记住,后续生成不一定每次都必须使用上一段视频的截图。
如果最初保存的标准道具资产更加清晰,或者后续截图出现了细节偏差,就应该优先使用已经确认过的标准资产。
结语
AI视频中的道具一致性,并不是一句“保持大小不变”就能够完全解决的。
当道具还没有进入场景时,我们可以通过图生图,为它增加一个固定的手掌参照,再通过比例参数控制道具大小。
当第一段视频已经生成后,我们又可以直接提取其中的道具关键帧,作为下一段视频的参考,尽可能延续已经确定的外观、结构和尺寸关系。
前者解决的是道具初始尺寸的控制问题,后者解决的是连续镜头中道具信息的延续问题。
将这两种方法结合起来,就能够减少AI在不同镜头中重新猜测道具大小和外观的情况。
记住,想让AI更稳定地生成同一个道具,不仅要告诉它道具是什么,还要给它明确的尺寸依据,并让已经确认的视觉信息在后续镜头中继续发挥作用。