



为什么有时候,提示词写得很详细,AI 生成的画面还是不符合预期?
明明要求蜘蛛停留在人物眼前,结果却跑进了眼睛里;明明要求炮弹击中船尾,每次生成的爆炸位置却不一样;人物明明可以逃跑,却突然做出一个毫无理由的动作。
遇到这些情况,很多人的第一反应是继续修改提示词,不断添加新的形容词和动作描述。
但问题可能根本不在于描述不够详细,而在于我们没有找准生成偏差的原因。
不同的问题,需要采用不同的修正方式。有些问题需要重新明确镜头,有些需要通过参考图锁定位置,还有些则需要补充人物动作的前后关系。
本节就从这三个方向入手,学习如何定位问题、修改提示词,让每一次调整都更加有针对性。
一、先判断问题,再修改提示词
在修改之前,先不要急着重新生成。
我们需要明确:当前画面究竟是哪里出了问题?
可以先将常见的生成偏差分成三类。
第一类:画面表达不准确。
你想要的是一个特定镜头,但 AI 理解成了另一种画面。例如,你希望观众通过人物的视线看到眼前的蜘蛛,结果蜘蛛却出现在人物眼睛上。
这类问题需要优先检查镜头视角和动作描述。
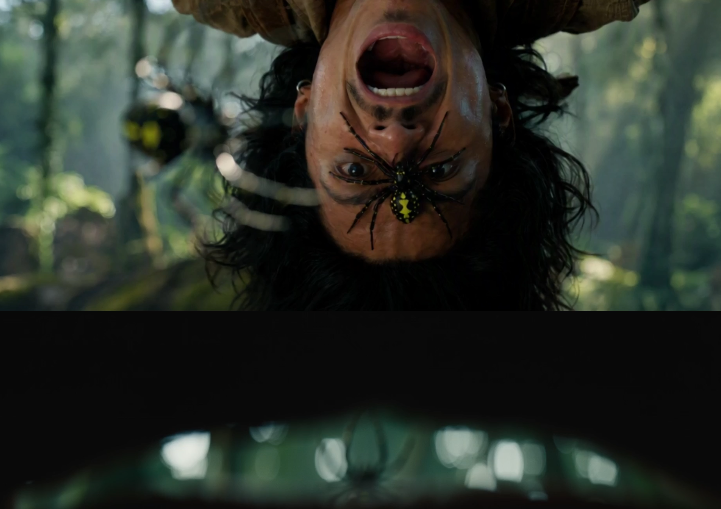
第二类:空间位置不准确。
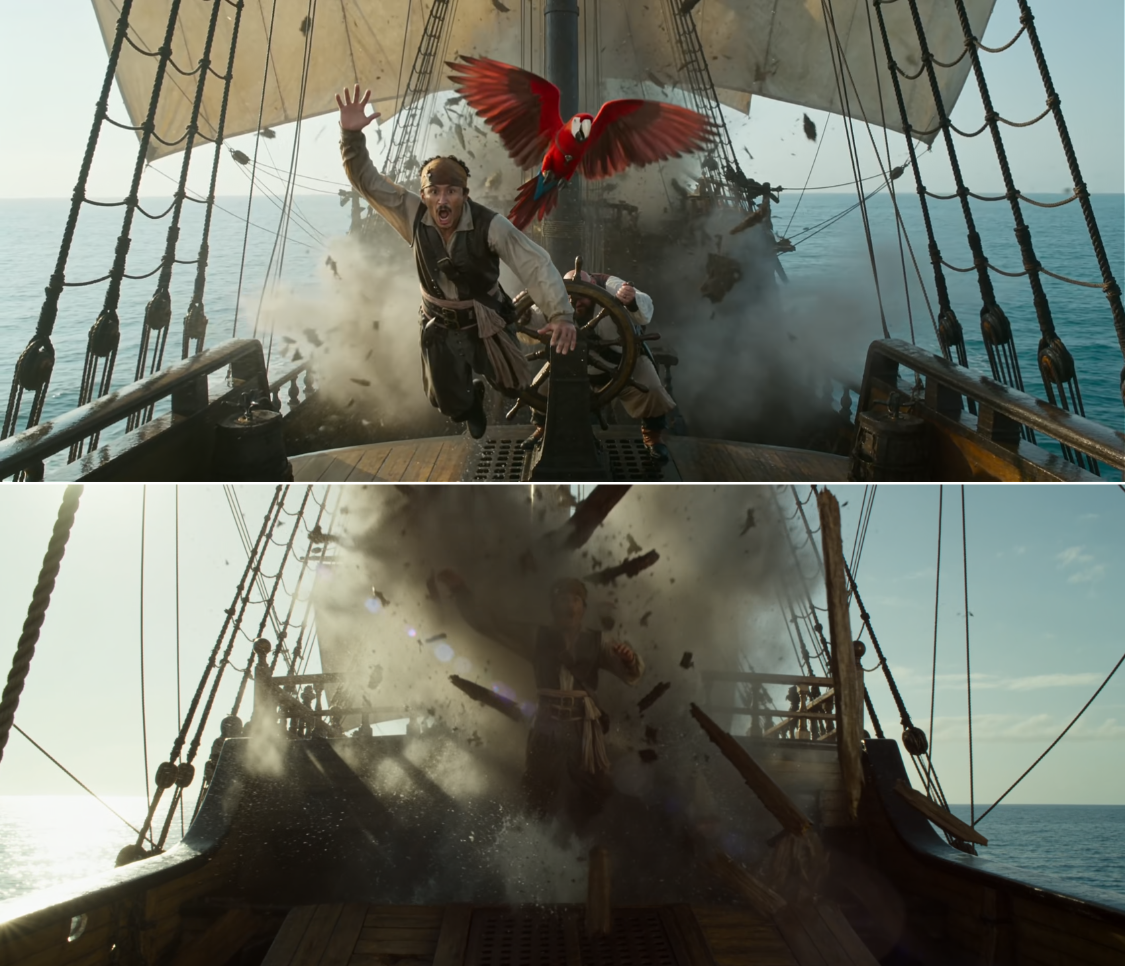
画面中的物体、人物或特效出现了,但没有出现在指定位置。例如,爆炸发生在船身中部,而不是你要求的船尾。
这类问题需要明确物体之间的位置关系,必要时使用参考图标注。
第三类:人物动作不合理。
人物完成了动作,但这个动作与当前情境不匹配。例如,危险已经出现,人物却没有躲避,反而做出一个缺乏理由的动作。
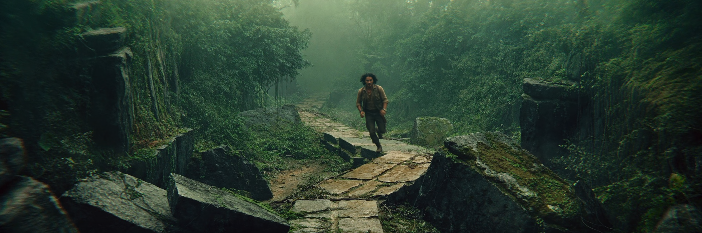
这类问题需要检查人物的行为动机,以及动作发生前后的关系。
这三类问题不能全部用同一种方法处理。
如果是镜头视角的问题,一味增加情绪词没有用;如果是空间定位的问题,不断强调画面要准确,也未必能解决;如果是行为逻辑的问题,单纯要求人物更加自然,同样很难得到稳定的结果。
先确定问题类型,再选择对应的修改方法,才是修正提示词的第一步。
二、方法一:镜头不符合预期,就把动作拆开
AI 视频生成中,一个很常见的问题是:提示词里的每个要求单独看都没有问题,但组合在一起之后,画面却发生了偏差。
这通常与镜头表达和动作安排有关。
1. 不要让一个镜头承担太多任务
假设我们想生成一个人物发现蜘蛛的画面。
原本的想法可能是:
人物睁开眼睛,以第一视角看见一只蜘蛛靠近,随后挥手赶走蜘蛛,再迅速拔出武器。
从剧情上看,这是一段完整的动作。但从画面生成的角度看,它包含了多个不同的任务。
首先,人物睁眼可以通过面部特写来表现。
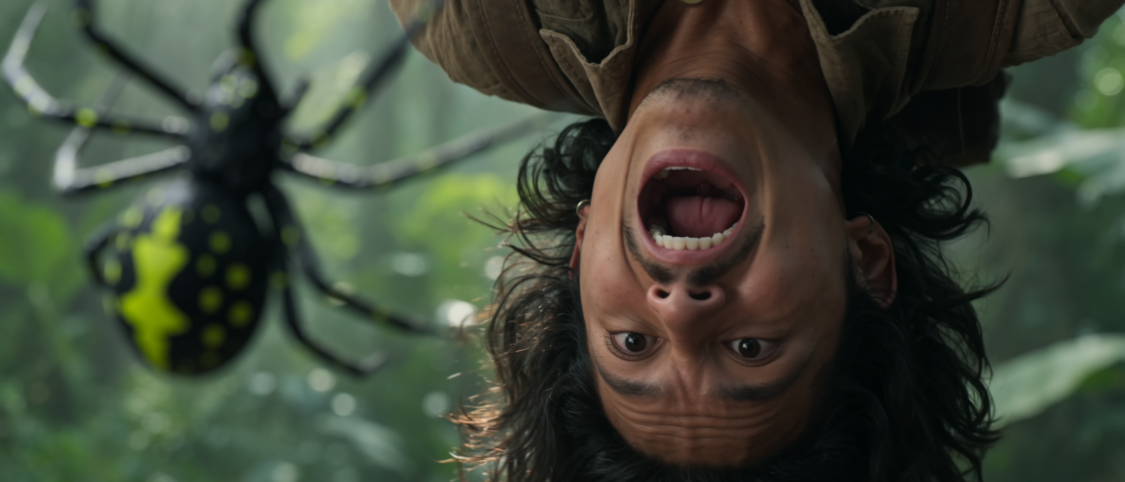
其次,第一人称视角需要呈现人物眼前的环境。
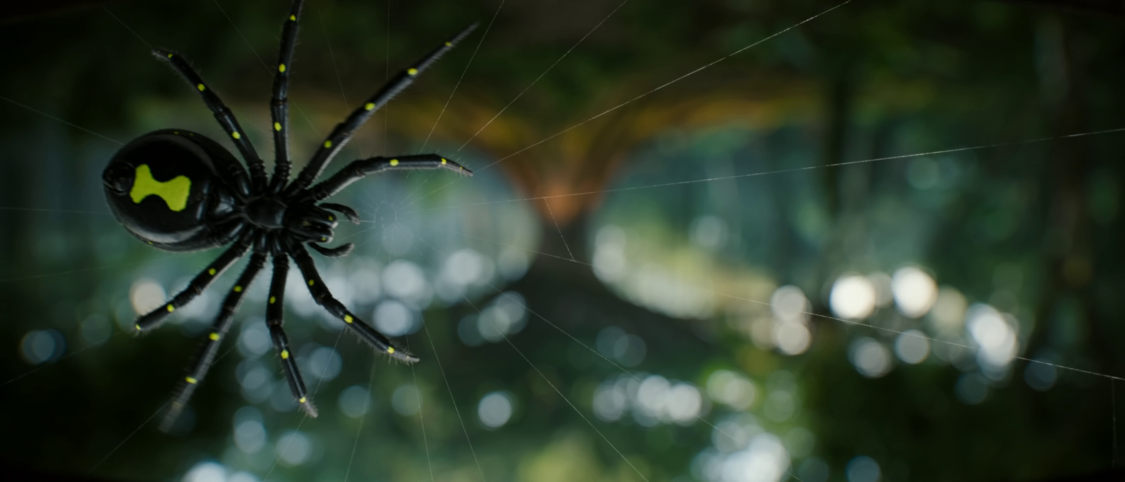
然后,蜘蛛靠近、人物挥手以及拔出武器,又分别涉及不同的动作状态。
当这些内容全部挤在同一个镜头里时,AI 可能无法准确判断应该优先表现哪一个动作,也可能混淆人物眼睛与主观视野之间的关系。
因此,动作越多,不代表画面越完整;只有明确每个镜头的主要任务,画面才更容易按照预期生成。
2. 先确定镜头视角
修改这类提示词时,第一步不是增加更多动作,而是先确定镜头究竟从哪里拍摄。
如果希望观众看见人物睁眼,就采用外部面部特写。
如果希望观众看见人物眼前的蜘蛛,就采用第一人称主观视角。
两种画面可以在同一段视频中先后出现,但不应该在同一个镜头里混淆表达。
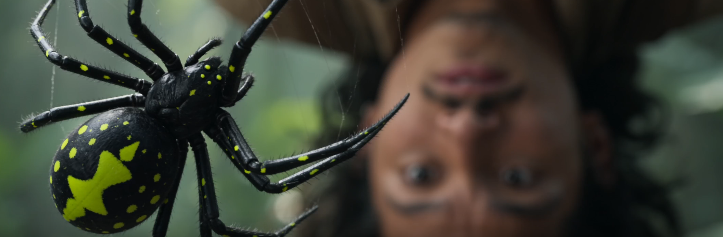
例如,可以把原本的动作拆成两个镜头。
镜头一:人物睁眼。
提示词:
分时段多镜头拍摄,仅在指定节点切换镜头,摄影机不自行裁切画面。 0.0秒至4.0秒 — 镜头1,CU 29°,倒置构图:人物 挂在蛛丝上位于前景,对焦清晰,缓慢旋转,前腿朝着男孩的鼻子方向弯曲。在它后方是 @char_jungle4 倒置的脸,双眼已经睁开,一动不动地盯着蜘蛛。 2.5秒时,焦点从蜘蛛快速移至男孩的面部——焦点落在他身上的瞬间,他猛地张嘴尖叫,双眼圆睁,脸颊颤抖。片段中间无焦点偏移。
镜头二:看见蜘蛛。
提示词:
首帧 / 站位调度 第一帧为纯黑——眼睛完全闭合。整个镜头全程画面铺满21:9画幅的每一处边缘。睁眼的视觉效果完全呈现为形似眼缝弧度的柔和黑色遮光片:两块光滑无细节的暗块从画面中央向两侧分开——一个干净的眼形渐晕效果展开,无任何解剖学细节,仅传递出眼睛睁开的观感。 百叶窗刚一打开时,一道狭长的深绿色阴影在画面中部划过,一团模糊的深色蛛形物体停在它那张同样模糊的蛛网上,位置在画面左三分之一处,保持着固定距离,昏暗的倒置丛林在它后方晕成一片柔和的模糊色块。
这两个提示词的区别在于:第一个镜头展示人物,第二个镜头展示人物所看到的内容。
镜头任务明确以后,AI 就不需要同时处理相互冲突的视觉要求。
3. 再决定动作应该如何衔接
镜头确定之后,才是动作安排。
如果人物看见蜘蛛后还需要挥手驱赶,可以将这个动作放在后续镜头中。
例如:
镜头2,WS 63° 全景展开:他倒挂着——粗壮的绿色藤蔓只缠绕在他脚踝处的靴子上,藤圈只箍在靴筒上,除此之外没有任何接触;脚踝以上的小腿、膝盖、大腿和躯干完全没有被藤蔓碰到,完全悬空;一根带着粗糙绿色植物表皮的藤蔓,从被缠住的靴子一直向上延伸到2米高处的固定点。 他倒悬的头部离丛林地面很近,因恐惧而尖叫、颤抖,身体不受控制地小幅乱颤、摇晃,原本悬垂的手臂胡乱挥动。蜘蛛强制位置:同一只@char_spider 挂在自身蛛丝上,与他的脸和头部齐平,位于他脸前方10-15厘米处——位置不得偏高或偏低。 6.5秒时,他用左手手腕背面出击——在面部高度猛地反手一弹,以指节和手腕外侧领先——将蜘蛛从蛛线上弹飞:这只重50-70克的蜘蛛呈下落轨迹飞出,呈弧线坠向地面,落在落叶层上,随后朝着画面左侧边缘的灌木丛快速爬动,钻进叶片缝隙消失不见;在这只小巧的浅色蜘蛛从下方穿过的全程,灌木丛纹丝不动,每一片叶子、每一根枝条都没有被碰动分毫。 男孩不停发抖,呼吸粗重,目光追着蜘蛛消失的方向,绿色的藤曼在他的体重下持续发出吱呀声、微微弯折,一直持续到镜头结束。镜头中段无偏移。
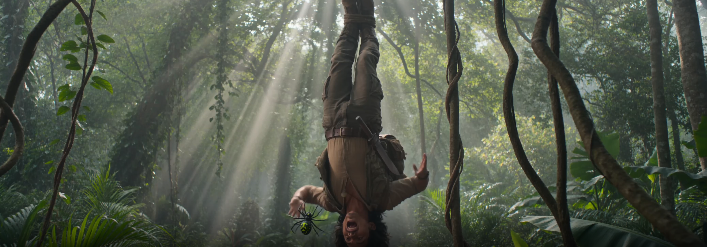
注意,这里不需要再加入拔刀、翻身、逃跑等后续动作。
如果这些动作确实属于剧情的一部分,可以继续拆分为独立镜头。
4. 如何判断动作是否需要拆分?
可以用一个简单的方法:读完提示词后,问自己三个问题。
这个镜头最重要的画面是什么?
观众应该从哪个角度看到它?
这个镜头是否同时要求人物完成多个不同的动作?
如果一个镜头同时承担了人物反应、物体运动、镜头切换和后续攻击等多项任务,就应该考虑拆分。
但拆分并不意味着所有动作都必须单独生成。
如果多个动作连续、简单,而且不会造成视角混乱,可以保留在同一个镜头中。只有当动作之间存在明显的镜头差异、空间冲突或表达歧义时,才需要进一步拆分。
核心原则:先把当前镜头讲清楚,再安排下一个镜头。
三、方法二:空间位置总出错,就用参考图标注
第二种常见的问题是,画面整体看起来没有明显错误,但关键物体的位置始终不准确。
例如,我们需要生成一段海战画面:一艘帆船正在海面航行,炮弹飞向船只,并准确击中船尾。
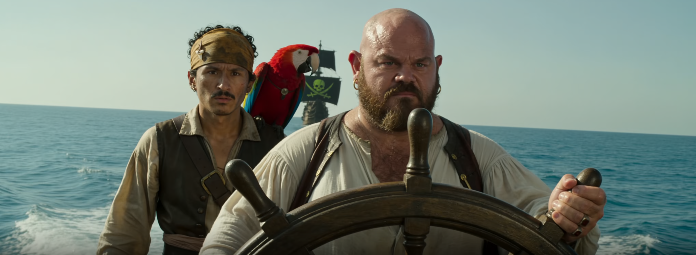
结果生成多次后,爆炸的位置可能出现在船身中部,也可能出现在船只旁边的海面上。
这时候,继续重复“炮弹必须击中船尾”,往往不是最有效的办法。
1. 为什么文字描述不一定够用?
因为空间位置不仅是一个名称,还包含具体的视觉关系。
“船尾”说明了大致区域,但没有直接展示目标位置在画面中的具体坐标。
尤其当船只存在透视变化、镜头角度变化,或者船体本身具有复杂结构时,AI 对目标区域的理解可能与我们不同。
如果提示词同时包含人物、船只、炮弹、爆炸和镜头运动,位置要求就更容易被其他信息干扰。
因此,我们可以直接利用参考图,将目标位置标记出来。
2. 第一步:准备一张清晰的参考图
选择一张船体结构清楚、能够看清船头和船尾的参考图。
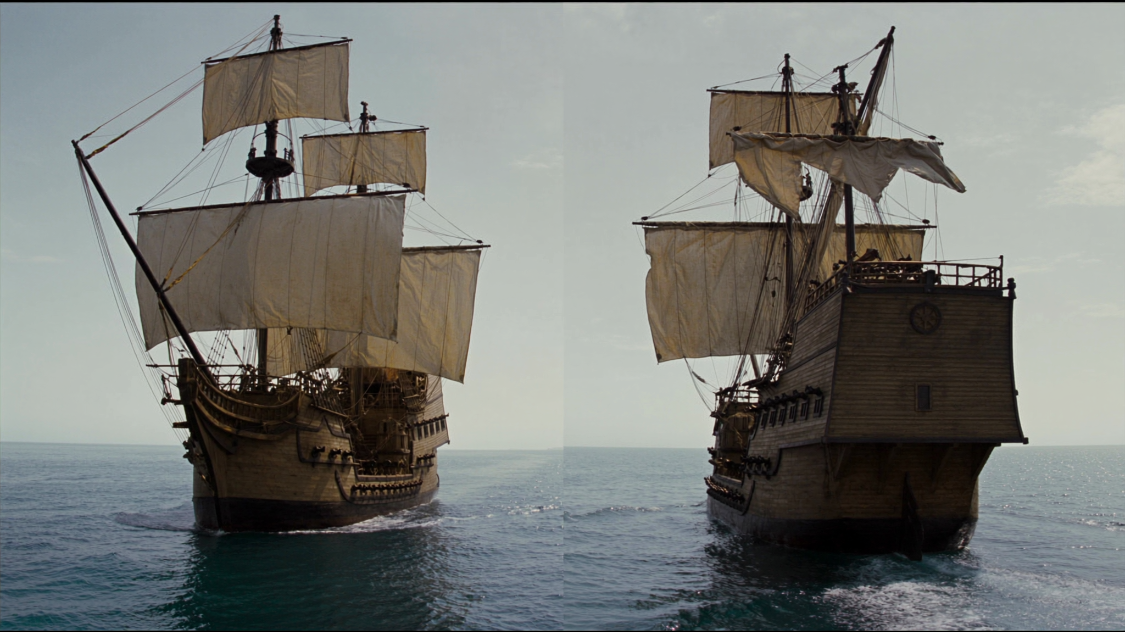
尽量选择与最终画面机位接近的图片。
如果最终想生成船只的后方视角,就优先使用能够清楚展示船尾的参考图;如果需要从侧面拍摄,就选择侧面结构明确的图片。
参考图的作用不是单纯提供船只外观,而是为后续的空间定位提供依据。
3. 第二步:在图上直接标记
使用任意图片编辑工具,都可以完成这一步。
用红色圆圈标出炮弹应该命中的位置。
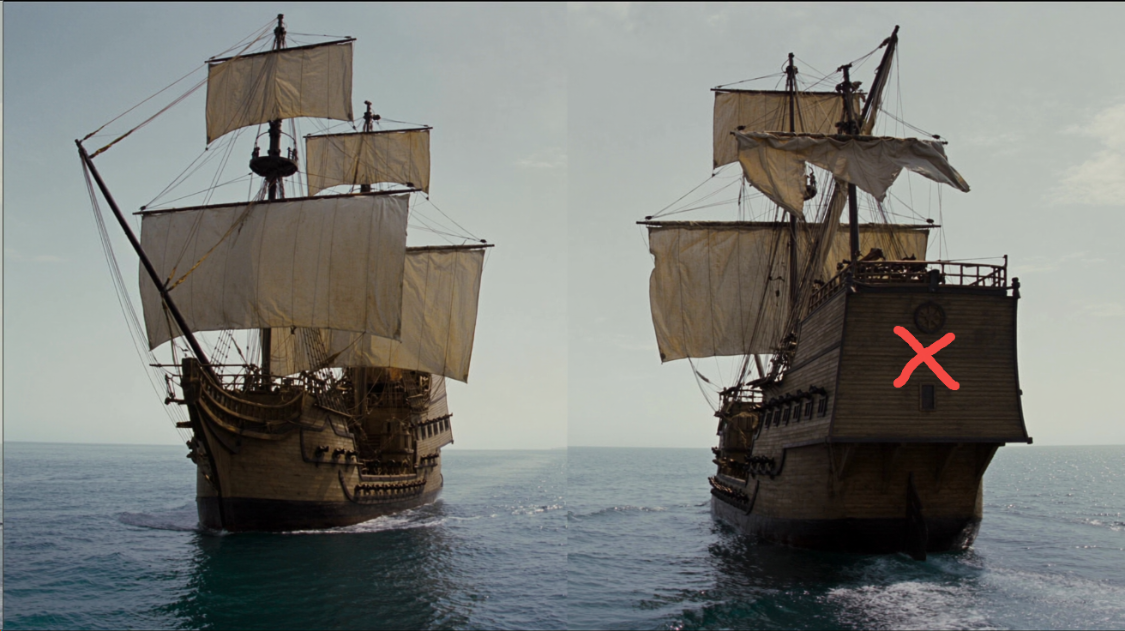
标记不需要复杂,能够让人一眼看懂就可以。
例如,红圈表示爆炸目标,蓝点表示人物站位,箭头表示炮弹飞行方向。
不要在图片上写入大量解释性文字,也不要使用太多含义相近的标记。标记越清楚,越容易与文字提示词建立对应关系。
4. 第三步:让 AI 根据标记重新组织提示词
标记完成后,将图片交给具备图像理解能力的 AI 工具,并说明每个标记代表什么。
可以使用下面这段提示词:
请分析我提供的船只参考图及图中的标记。红色圆圈代表炮弹需要命中的位置,蓝色标记代表人物所在位置,箭头代表炮弹的运动方向。请根据图中的实际空间关系,重新组织视频生成提示词。明确写出炮弹的运动方向、爆炸位置、人物与爆炸点之间的距离,以及船体各部分的相对位置。
保留参考图中的船只结构与空间关系,不要将爆炸位置改到船身中部或船只周围的海面上。不要擅自增加其他爆炸点。
输出一段可以直接用于 AI 视频生成的中文提示词。
这一步的重点,是让 AI 将图像中的视觉信息转化成更加明确的文字表达。
需要注意,标注图并不意味着 AI 一定会百分之百遵循位置。它的作用是减少空间理解上的歧义,最终仍需要结合生成结果检查。
5. 第四步:把位置关系写进最终提示词
得到修改后的提示词后,还需要明确保留最重要的空间约束。
例如:
弹体追踪视角,63°,实时:开场画面为的敌方甲板——架在木质炮架上的黑铁火炮已经推出炮位,炮口对准画面左侧,远处那艘挂着浅白船帆的大帆船正停泊在那里。 最近的那门炮瞬间开火——炮口迸出白炽的火光,炮架猛地向后撞在绳索滑车组上——镜头随即猛地转向 并随之移动:镜头固定在圆形炮身旁的追焦支架上,位置紧贴水面,下方的海面因剧烈运动拖出长长的模糊拖影。 炮弹 在整个飞行过程中都停留在画面左边缘的远方天际,在雾霭中呈现出朦胧的青绿色。正前方的目标越来越清晰:那是爱德华多座舰的后墙——一道高耸的木雕崖壁,从水线处一直延伸至顶部带栏杆的甲板——它从模糊的轮廓逐渐扩大为占满整个画面的巨墙,飞行器正朝着它的上半部分飞去。
剪辑3——硬切至慢动作,MS,47°,回到舞台,构图与剪辑1完全一致:镜头位于船尾楼朝后并略微向上拍摄——舵手在画面右侧紧握舵轮,爱德华多在舵轮左侧一步远的位置,肩上站着一只金刚鹦鹉,两人浑身湿透、不断滴水,画面下方横贯栏杆,两侧是海面。 炮弹击中了船尾凸起甲板的下方靠后位置,处于视野之外——紧接着,爆炸从船员们身后、他们所在甲板的远端边缘后方猛地炸开:木板、长长的碎木片和烟雾在他们背后冲天而起。 第二发、第三发接连重击同一面船尾舱壁,每一次爆炸都在它们身后掀起新的水柱。距离最近的爆炸直接将爱德华多掀得双脚离地——直直朝着镜头的方向飞了过来。 飞行方向清晰明确:准确命中参考图红圈标记的船尾外侧区域。爆炸集中发生在指定命中点,火光与烟雾沿船体外侧扩散,因此他的身体被冲击波朝着镜头方向抛去——每一格画面里,爱德华多的身形都在变大,他越过栏杆扶手朝镜头飞来,双臂直直向前伸展,而车轮、桅杆与碎片喷流则在他身后不断退远。 他的脸像个滑稽的震惊面具:嘴巴张得溜圆,眼睛瞪得滚圆,脸颊在冲击波里不住颤动;金刚鹦鹉被从他肩膀上掀飞,炸开一片红羽毛,在他身旁扑腾翅膀。舵手弓着背伏在舵轮上,纹丝不动。这段剪辑在半空戛然而止——爱德华多正腾空而起,占满整个画面朝镜头扑来。
这段提示词将目标位置、运动方向、人物位置以及需要避免的错误分别写清楚。
相比单纯重复“船尾爆炸”,它提供了更多能够被画面验证的条件。
如果生成结果仍然偏离目标,可以继续调整标记位置、参考图角度或运动方向,而不是每次都从头重写整段提示词。
四、方法三:人物动作不合理,就补全前后因果
第三种问题更加隐蔽。
画面里的角色可能外形正确,场景也没有问题,动作本身甚至生成得很流畅,但整个行为看起来就是不合理。
例如,一个男人遇到一群快速冲过来的猴子。他明明可以跑开,却突然趴在地上,双手抱住头部,一动不动。
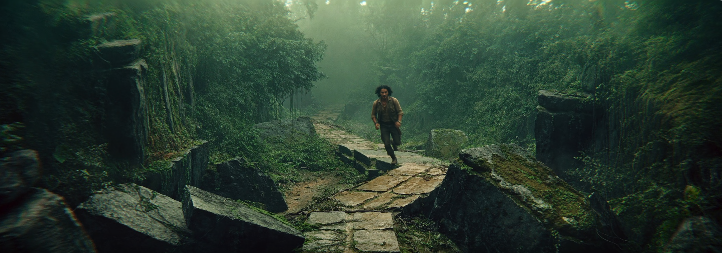
如果只要求 AI 让他表现得更害怕,生成结果未必会改善。
因为问题不在于人物的情绪不够强烈,而在于 AI 没有获得足够明确的行为依据。
1. 情绪描述不等于动作逻辑
“害怕”“紧张”“惊慌”这些词可以帮助 AI 理解人物的情绪,但它们无法单独决定人物应该采取什么动作。
面对危险,有人会转身逃跑,有人会躲到障碍物后面,也有人会蹲下保护自己。
这些行为都可能符合害怕的情绪,但具体采用哪一种,需要结合场景判断。
如果提示词只写:
男人非常害怕,双手抱头,趴在地上求饶。猴群出现在附近。
那么,人物为什么趴下、猴群距离他有多近、他为什么没有逃跑,这些问题都没有得到明确说明。
AI 只能自行补充缺失的行为逻辑。
因此,想让人物动作合理,就不能只描述他做了什么,还需要解释是什么促使他这样做。
2. 按照触发、反应和结果组织动作
可以将人物行为拆成三个部分。
第一步:明确触发事件。
什么事情让人物产生反应?
例如,几只猴子突然从树林深处快速冲出,沿着人物所在的方向奔跑。
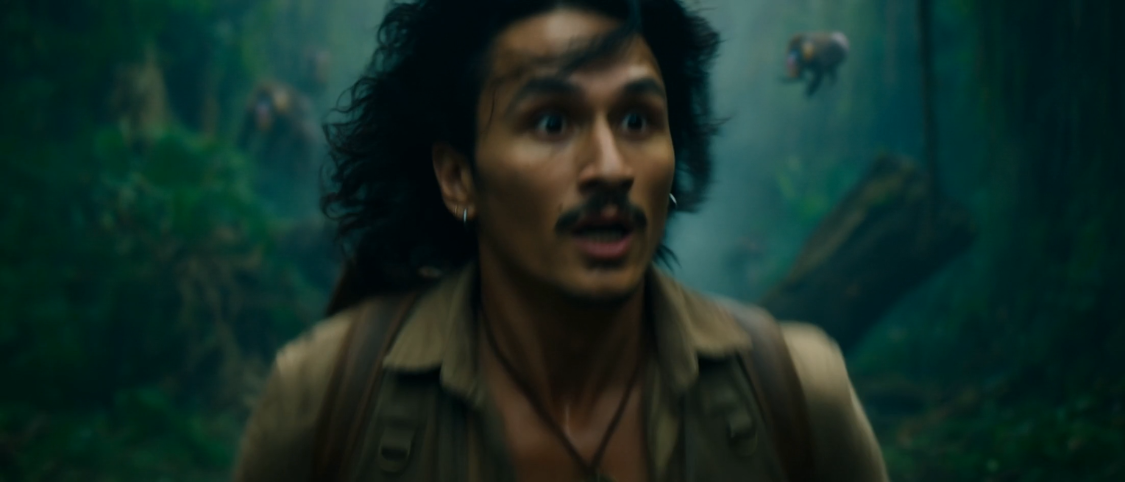
第二步:明确人物的反应。
人物看见了什么?他为什么采取这个动作?
例如,男人发现猴群正从自己身边高速经过,担心被撞倒,于是立即降低身体重心,双手交叉护住头部。
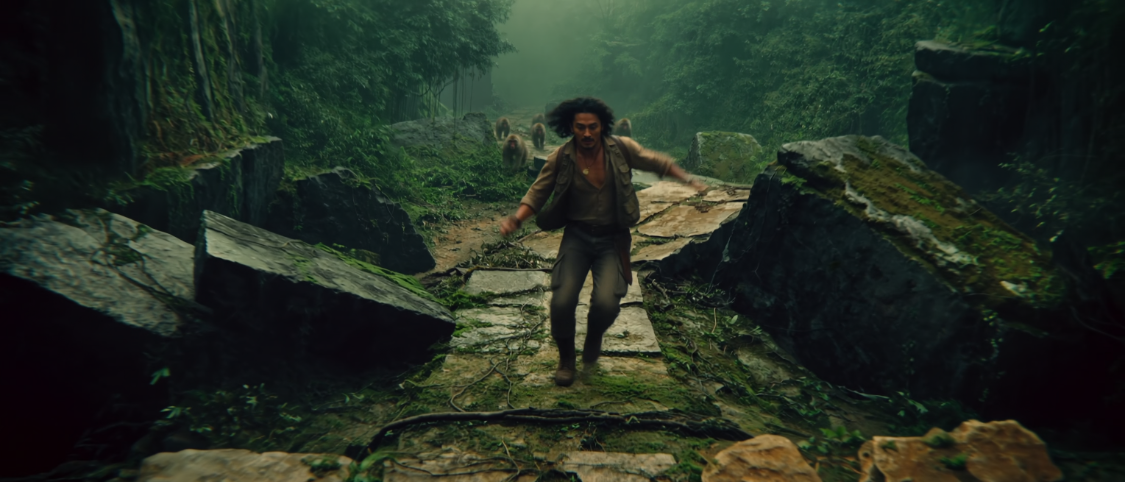
第三步:明确动作的结果。
人物完成动作后,场景发生了什么变化?
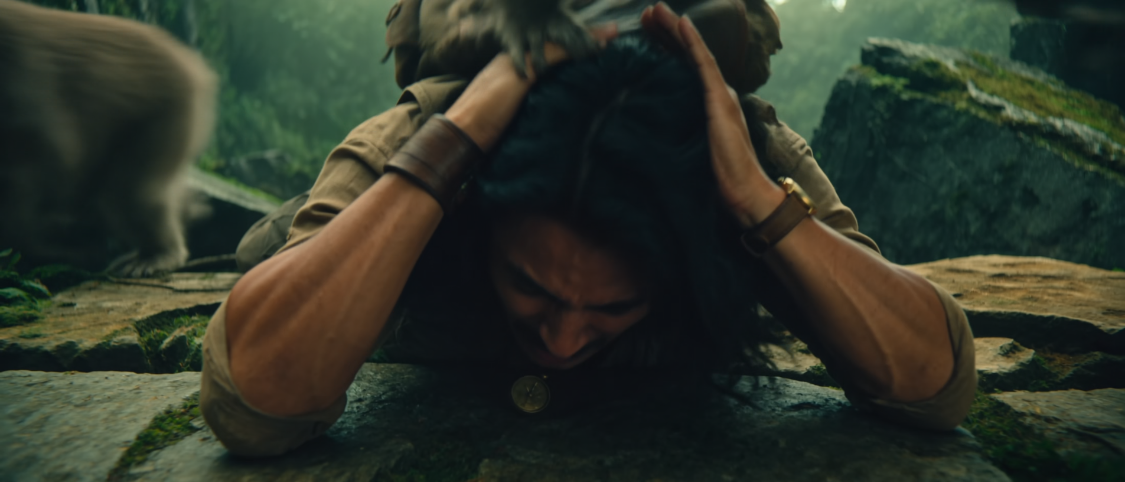
例如,猴群从人物身边跑过,男人仍然保持低伏姿势,直到周围恢复平静,才缓慢抬起头观察。
这样,人物的动作就不再是孤立的。
他不是因为提示词里写了“害怕”才趴下,而是因为危险正在接近,需要保护自己。
3. 将因果关系写进提示词
可以直接使用下面这段提示词:
镜头从高处俯瞰小径:摄像机架设在4米高处,47度视场角,镜头向下倾斜,拍摄的是雾气弥漫的小径。探险者朝着下方的镜头飞奔而来,双臂自然地摆动着。他的靴子绊到了一块碎石板凸起的边缘——他向前倾倒,重重地摔在地上,在石头上滑行。就在他摔倒的瞬间,摄像机迅速下倾,以连续的摇臂式拍摄,从高角度缓缓下降到他蜷缩身体的上方,最终定格在近景。他双手用力拍打后脑勺——右手放在右耳后,左手放在左耳后,手指并拢贴着头发,双手之间留有明显的空隙——双肘紧贴身体,双眼紧闭,整个身体蜷缩成一个保护性的姿势。他刚一撞在石头上,猴群就已经扑了过来:第一批猕猴从他身体两侧呼啸而过,模糊的灰褐色身影掠过画面,其中一只在他苦苦哀求时纵身跃过他的背——猴群如潮水般涌来,而他的脸仍然埋在石头上,他的声音在镜头中回荡,他尖叫着哀求道:“好了好了,我受够了!我愿意!你们赢了!求求你们停下来!”
镜头先展示猴群接近的环境关系,再切换到人物的低伏动作,最后以人物观察周围的近景收尾。人物动作连续自然,前后状态保持一致。
这里需要注意,补充因果关系不等于给剧情增加大量新内容。
我们没有必要为人物设计复杂的背景故事,也不需要额外增加新的角色和事件。只要把当前动作发生的直接原因,以及动作完成后的状态补充清楚,就已经能够帮助 AI 理解人物行为。
4. 不要把所有动作都写成情绪指令
很多人在修改人物动作时,喜欢反复添加类似的词语:
更加害怕、更加慌张、极度紧张、表现得非常不安。
这些描述并非完全没有用,但它们不能替代具体动作。
如果人物应该逃跑,就明确写出逃跑的方向、身体姿态和移动路线;如果人物应该躲避,就说明危险从哪里出现、人物如何躲避,以及躲避后处于什么位置。
情绪负责补充人物状态,动作负责表现行为,因果关系负责解释人物为什么这样做。
当这三个部分形成清晰的联系时,人物的行为才更容易符合场景逻辑。
五、三类问题,分别采用三种修正方法
学完前面三个案例,我们可以将它们整理成一套更容易使用的判断方法。
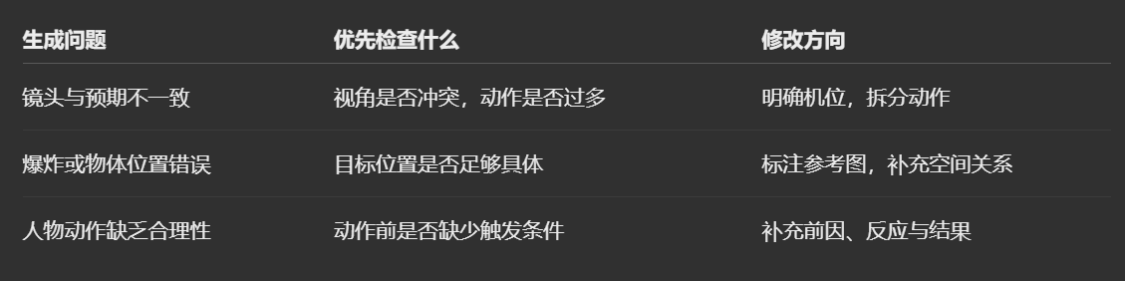
这三种方法的区别,在于它们解决的是不同层面的信息缺失。
镜头问题需要解决的是“观众应该看到什么”。
空间问题需要解决的是“物体应该出现在哪里”。
行为问题需要解决的是“人物为什么这样行动”。
如果没有区分这些问题,就很容易出现一种情况:明明是空间位置不准确,却不断修改动作;明明是人物缺少行为动机,却一直增加情绪描述。
提示词越写越长,生成结果却没有明显改善。
因此,每次修改之前,都应该先判断当前偏差属于哪一类。
结语
AI 生成的画面不符合预期,并不意味着只能不断增加提示词。
有时,我们需要重新明确镜头视角;
有时,需要通过参考图确定空间位置;
还有时,需要补齐人物动作背后的因果关系。
这三种方法分别解决了画面表达、空间定位和行为逻辑的问题。
当你能够准确判断生成偏差,并选择对应的修正方式,就不必再依赖大量重复的描述。
提示词优化的关键,不是把每句话写得更复杂,而是让 AI 清楚地知道:画面应该是什么样,物体应该在哪里,人物为什么要这样行动。